


GVS5H: Fünf offene 27B-Modelle im Verbund erreichen Fable-5-Niveau
Die wichtigsten Fakten
- GVS5H (ledger-based zero-shot self-orchestration) lässt mehrere frische Instanzen eines Modells ein Problem zerlegen und über einen geteilten Ordner mit Plan, Notizen und aktuellem Lösungsstand koordinieren, ganz ohne Training.
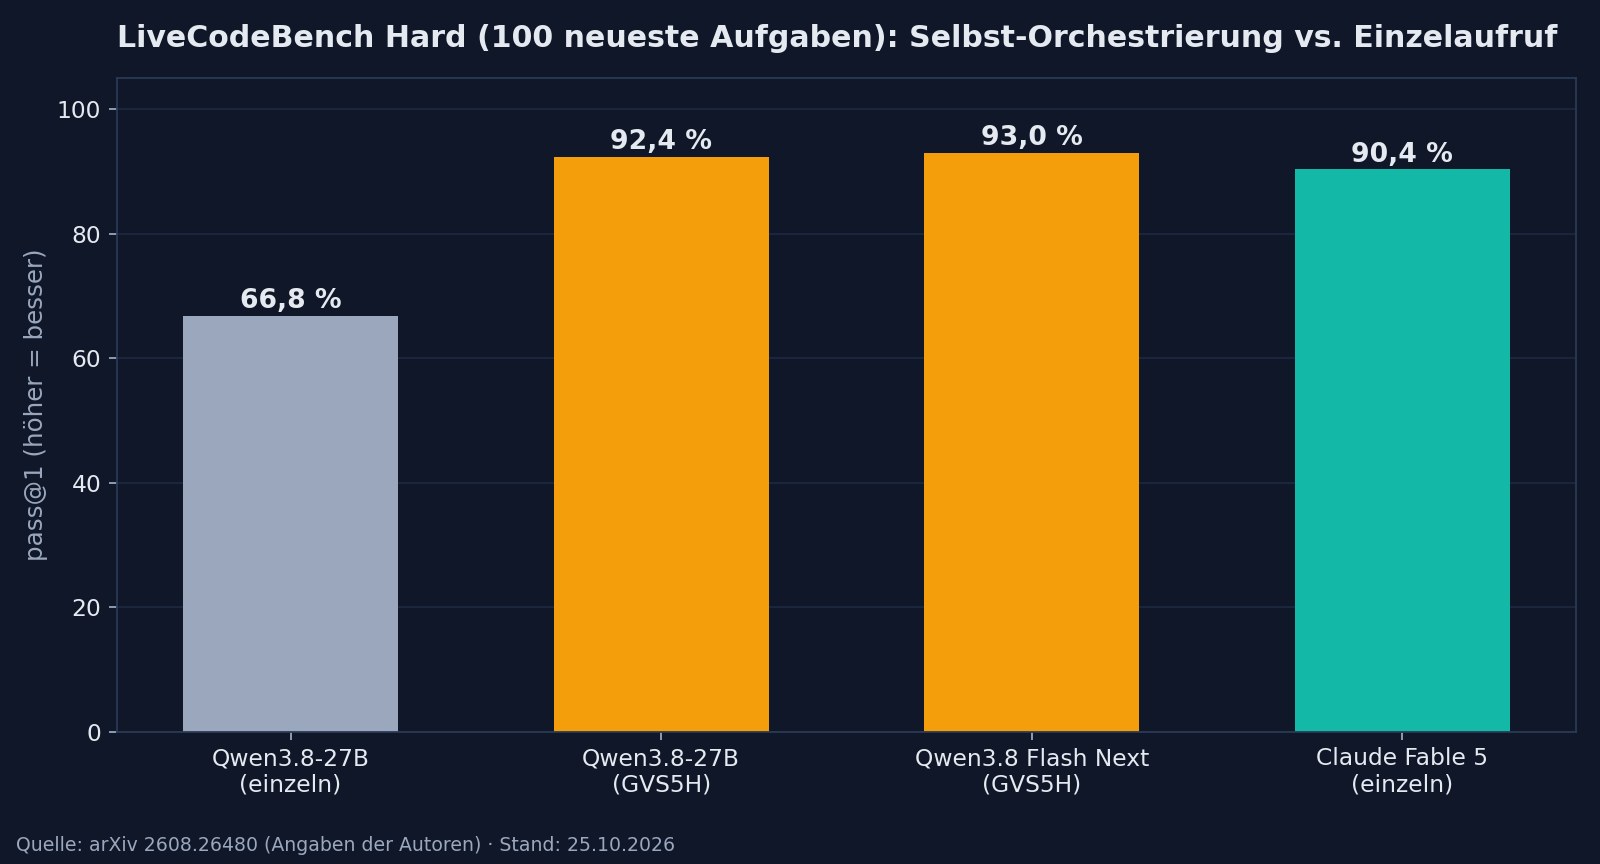
- Auf den 100 neuesten schweren LiveCodeBench-Aufgaben steigt das lokal laufende, offene Qwen3.8-27B von 66,8 auf 92,4 Prozent, Claude Fable 5 liegt bei 90,4 Prozent.
- Orchestriert erreicht Qwen3.8 Flash Next 93,0 Prozent bei etwa 9 Prozent der Kosten von Fable 5; über elf getestete Modelle hinweg beträgt der Gewinn bis zu 25,6 Prozentpunkte.
- Wichtige Einschränkungen: Nicht jedes Modell profitiert, manche werden schlechter, und LiveCodeBench Hard ist Wettkampfprogrammierung, keine Entwicklung an echten Repositories.
Kurz gesagt: Statt ein größeres Modell zu kaufen, lass fünf Kopien desselben kleinen Modells zusammenarbeiten. Genau das macht das neue Open-Source-Harness GVS5H, und die Zahlen sind beachtlich: Frontier-Niveau beim Coden, auf einer einzigen lokalen GPU, für einen Bruchteil der Kosten.
Wie es funktioniert
GVS5H steht für ledger-based zero-shot self-orchestration: Frische Instanzen ein und desselben Modells zerlegen eine Aufgabe und koordinieren sich über ein geteiltes Dateisystem, das Plan, Notizen und den aktuellen Lösungsstand enthält, wie das Paper auf arXiv beschreibt. Es kommt ohne Training oder Feintuning aus. Getestet wurde über elf offene und geschlossene Modelle hinweg, mit Gewinnen bis zu 25,6 Prozentpunkten auf fixierten Backends. Eine Transkript-Analyse führt den Gewinn auf die Zerlegung der Probleme und den persistenten Kontext zurück. Der Code steht unter MIT-Lizenz auf GitHub, Paper und Laufdaten unter CC BY 4.0.
Die Zahlen im Detail
Auf den 100 neuesten schweren LiveCodeBench-Problemen steigt Qwen3.8-27B durch die Orchestrierung von 66,8 auf 92,4 Prozent pass@1, das Ergebnis läuft auf einer einzelnen lokalen GPU. Das orchestrierte Qwen3.8 Flash Next kommt auf 93,0 Prozent und liegt damit über den 90,4 Prozent von Claude Fable 5, bei laut Autoren etwa 9 Prozent der Kosten. Alle Werte stammen aus dem Paper der Entwickler und sind keine unabhängige Replikation.
Die Einschränkungen
Die Autoren sind selbst ungewöhnlich offen: Die Gewinne sind nicht universell, manche Modelle verbessern sich nicht oder werden schlechter. Zwei methodische Punkte kommen hinzu, berichtet Morning Tokens: Die Opus-5-Baseline lief über ein älteres Gerüst durch OpenRouter, und LiveCodeBench Hard misst Wettkampfprogrammierung, nicht die Arbeit an echten, großen Repositories. Ob sich der Vorsprung auf Alltags-Entwicklung überträgt, müssen eigene Tests zeigen.
Einordnung: Inferenz-Organisation als Hebel
GVS5H ist ein weiterer Beleg dafür, dass die Organisation der Inferenz inzwischen so viel bringen kann wie ein Modell-Upgrade, dieselbe Logik hinter Microsofts MAI-DxO in der Diagnostik oder den Manager-Ansätzen der letzten Monate. Das Ledger-Muster, ein geteilter Ordner als Gedächtnis der Gruppe, ist simpel genug, um es in bestehende Agenten-Flotten zu kopieren, und die MIT-Lizenz lädt genau dazu ein. Für Teams, die aus Kosten- oder Datenschutzgründen auf offene Gewichte setzen, ist das einer der praktisch relevantesten Releases des Herbstes.
Was du mitnehmen kannst
- Trainingsfreie Selbst-Orchestrierung hebt offene 27B-Modelle auf Frontier-Coding-Niveau, auf einer einzelnen GPU.
- Bis zu 25,6 Prozentpunkte Gewinn über elf Modelle, aber nicht bei allen, manche verschlechtern sich.
- Code unter MIT, Paper und Daten unter CC BY 4.0, sofort nachbaubar.
- Benchmark ist Wettkampfprogrammierung, nicht Repo-Arbeit, eigene Tests auf der eigenen Codebasis bleiben Pflicht.
Häufige Fragen
Brauche ich dafür mehrere GPUs oder ein Cluster?
Nein. Das gezeigte Ergebnis mit Qwen3.8-27B läuft auf einer einzelnen lokalen GPU, weil die Instanzen nacheinander oder getaktet arbeiten und sich über das Dateisystem abstimmen. Die Kosten steigen mit der Zahl der Modellaufrufe, liegen aber laut den Autoren weit unter denen eines Frontier-Modells.
Funktioniert das mit jedem Modell?
Nein. Über elf getestete Modelle hinweg zeigten manche keinen Gewinn oder wurden sogar schlechter. Die Autoren empfehlen implizit, den Effekt pro Backend zu messen, statt ihn vorauszusetzen.
Ist das dasselbe wie ein Multi-Agenten-Framework?
Verwandt, aber minimalistisch: Es gibt keine spezialisierten Agenten-Rollen oder trainierten Manager, sondern frische Kopien desselben Modells, die sich nur über einen geteilten Ordner mit Plan, Notizen und Lösungsstand abstimmen. Genau diese Einfachheit macht es leicht übertragbar.
Quellen
- GVS5H: Five Qwen3.8-27B Models Match Claude Fable 5 on LiveCodeBench Hard (arXiv, abgerufen 2026-10-25)
- GVS5H auf GitHub (GitHub / slee-persis, abgerufen 2026-10-25)
- AI News Oct 25, 2026 (Morning Tokens, abgerufen 2026-10-25)
Weitere Artikel
- Google macht sein Agenten-Gerüst Open Source: Was Harness² kann
- DeepSeek V4.1-Flash-1017: Kleines Modell, starke Coding-Agenten
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Das Titelbild ist KI-generiert und im Bild entsprechend gekennzeichnet. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.