


LFM3: Liquid AI veröffentlicht sechs offene 2B-Modelle auf einem Backbone
Die wichtigsten Fakten
- Liquid AI hat LFM3 veröffentlicht: sechs Modelle der 2B-Klasse (Text, Vision, Audio, Omni und zwei Decision-Modelle), alle aus der gemeinsamen Basis LFM3-1.7B-Base trainiert. Gewichte sind offen und ab sofort auf Hugging Face, im Playground und über die Liquid AI API verfügbar.
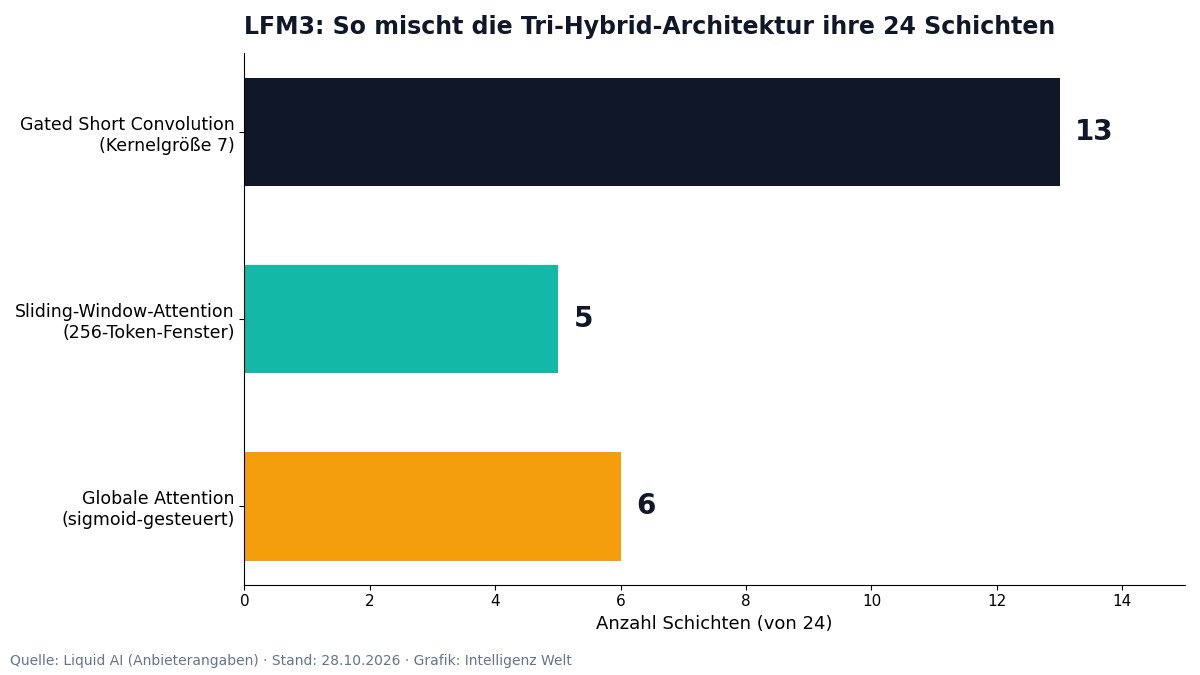
- Die neue Tri-Hybrid-Architektur mischt 13 Faltungsschichten, 5 Sliding-Window-Attention- und 6 globale Attention-Schichten; trainiert wurde auf 22 Billionen Tokens. Das Textmodell hat 256K Kontext und belegt bei 4-Bit-Präzision rund 1 GB Speicher.
- Laut Anbieter übertrifft LFM3-1.7B das größere LFM2.5-2.6B bei 35 Prozent weniger Parametern; alle Leistungsangaben sind Anbieter-Benchmarks. Liquid selbst rät in der Dokumentation wegen der Modellgröße von agentischem Coding und komplexem mehrstufigem Reasoning ab.
Kurz gesagt: Liquid AI, bekannt für effiziente Hybrid-Modelle jenseits reiner Transformer, hat mit LFM3 seine neue Generation vorgestellt. Die Idee: nicht ein großes Generalisten-Modell, sondern eine Familie kleiner Spezialisten auf einem gemeinsamen Rückgrat, die lokal laufen und sich auf einer einzelnen GPU verfeinern lassen. Die erste Ausbaustufe umfasst sechs Modelle der 2B-Klasse.
Architektur: drei Operatoren, 24 Schichten
LFM3 kombiniert drei Sequenz-Operatoren: 13 Schichten gated short convolutions (Kernelgröße 7 statt bisher 3), 5 Sliding-Window-Attention-Schichten mit 256-Token-Fenster und 6 Schichten globale Attention, deren Köpfe sich über ein Sigmoid-Gate abschalten können. Dazu kommen Partial RoPE auf den globalen Schichten und eine Sandwich-Normalisierung. Gesucht wurde die Architektur wie schon bei LFM2 automatisiert mit Hardware im Loop - diesmal über 14 Geräte- und Backend-Kombinationen, vom Galaxy S26 Ultra über einen Raspberry Pi 5 bis zu Apple M4 Max, AMD-Ryzen-AI-Laptops, Cloud-CPUs, GPUs und Qualcomms Hexagon-NPU.
Trainiert wurde LFM3-1.7B-Base auf 22 Billionen Tokens; die letzten 3,5 Billionen sind eine kuratierte Mid-Training-Phase mit mehr agentischen Traces und Tool-Aufrufen, die auch das Kontextfenster auf 256.000 Tokens streckt. Der Wortschatz umfasst 128.000 Tokens, laut Dokumentation werden 16 Sprachen unterstützt, darunter Deutsch. Die Lizenz ist die hauseigene LFM Open License v1.0.
Sechs Modelle, ein Rückgrat
Aus der Basis zweigen vier Eingabe-Modalitäten ab (Text, Vision, Audio und Omni) plus zwei Decision-Modelle, die aus den Vision- und Omni-Varianten spezialisiert wurden. Das Textmodell LFM3-1.7B (1,73 Milliarden Parameter) ist für lokale Agenten in Harnesses wie Hermes Agent, Pi und OpenClaw nach-trainiert und passt bei 4-Bit-Präzision in etwa 1 GB Speicher. Reasoning ist standardmäßig aktiv und lässt sich abschalten; FP8- und NVFP4-Checkpoints stehen für GPU-Inferenz bereit.
Benchmarks und Demos - alles Anbieterangaben
Liquid AI berichtet, LFM3-1.7B schlage das Vorgänger-LFM2.5-2.6B bei 35 Prozent weniger Parametern und sei bei 8K Kontext rund 25 Prozent schneller als LFM2-1.2B. Im hauseigenen Agenten-Benchmark LiveClaw erreicht es 45,6 Punkte gegenüber 14,7 für LFM2.5-2.6B. Unabhängig geprüft ist das nicht. Die Praxis-Demos sind konkreter: Eine kurze Verfeinerung von LFM3-VL-2B an rund 3.000 Drohnenfotos von Windkraftflügeln hob die Klassifikationsgenauigkeit für Schäden von unter 10 Prozent auf 67 Prozent; als Roboter-Controller erreichte ein VLA-Ausbau 96,2 Prozent Erfolg über die vier LIBERO-Suiten und liefert auf einem Jetson AGX Orin Aktions-Chunks in unter 50 Millisekunden.
Verfügbarkeit
Alle Basis- und nach-trainierten Gewichte stehen seit dem 27. Oktober auf Hugging Face, im Liquid Playground und über die Liquid AI API. llama.cpp, MLX und vLLM werden von Tag eins an unterstützt, LM Studio, Ollama und Unsloth sind im Ökosystem dabei. Zu den Launch-Partnern zählen AMD, Arm, Intel (via OpenVINO), NVIDIA, Qualcomm, OpenRouter und Vercel; Mercedes-Benz und Shopify haben laut Liquid vorab getestet.
Häufige Fragen
Läuft LFM3 auf meinem Laptop oder Handy?
Das ist der Anspruch: Das Textmodell belegt bei 4-Bit-Präzision rund 1 GB und wurde mit Hardware im Loop für Geräte vom Raspberry Pi 5 bis zu aktuellen Smartphones optimiert. llama.cpp, MLX und vLLM werden nativ unterstützt, GGUF-Builds sind auf Hugging Face verlinkt.
Darf ich LFM3 kommerziell nutzen?
Die Modelle stehen unter Liquids eigener LFM Open License v1.0. Die Gewichte sind offen und lokal verfeinerbar; die konkreten Lizenzbedingungen solltest du im Modell-Repositorium prüfen, bevor du sie kommerziell einsetzt.
Wie groß ist der Unterschied zu LFM2?
Neue Tri-Hybrid-Architektur mit mehr Attention-Anteil, doppelt so großem Convolutions-Kernel und deutlich mehr Training (22 Billionen Tokens plus kuratierte Mid-Training-Phase). Laut Anbieter schlägt das 1,7B-Modell den 2,6B-Vorgänger - eine Anbieterangabe, die noch keiner unabhängigen Prüfung unterlag.
Quellen
- Introducing LFM3: Every Modality for Specialized Intelligence (Liquid AI, abgerufen 2026-10-28)
- LFM3-1.7B (Modell-Dokumentation) (Liquid AI Docs, abgerufen 2026-10-28)
- AI News Oct 28, 2026 (Morning Tokens, abgerufen 2026-10-28)
Weitere Artikel
- Nanbeige4.3-33B: Dichtes 33B-Agentenmodell mit 512K-Kontext unter Apache 2.0
- Kimi K3.1 Pro: Open-Weights-Modell fast auf Augenhöhe mit Claude Opus 5.5
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Das Titelbild ist KI-generiert und im Bild entsprechend gekennzeichnet. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.