

Mercury 3: Diffusion-Modell knackt 1.000 Token pro Sekunde
Die wichtigsten Fakten
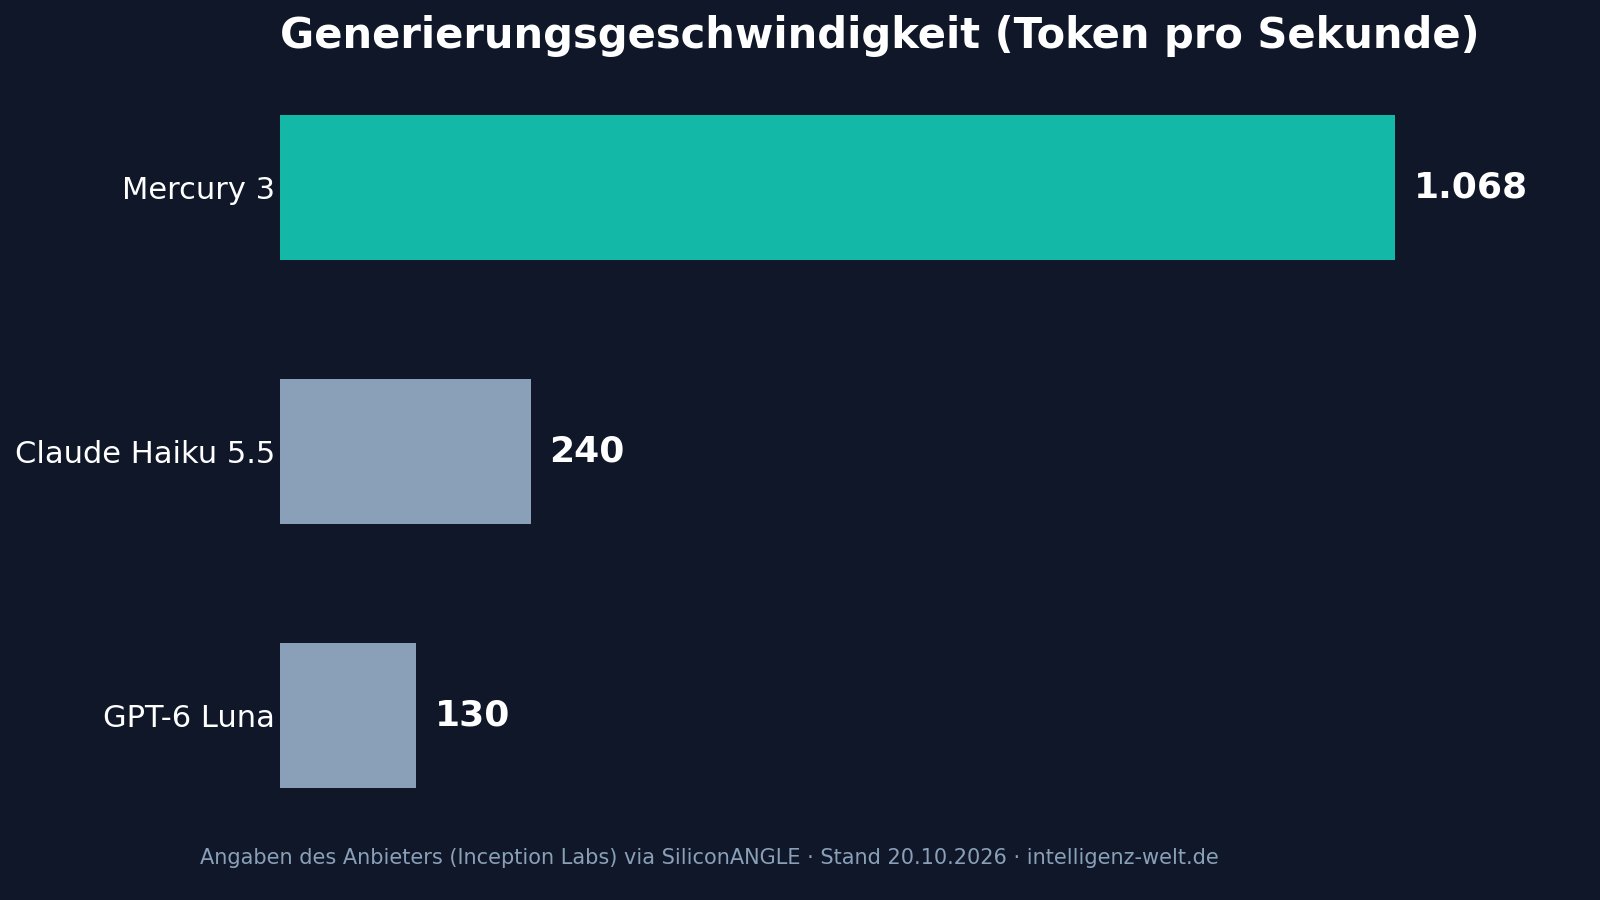
- Mercury 3 generiert laut Inception Labs 1.068 Token pro Sekunde, etwa 4 bis 8 Mal schneller als GPT-6 Luna und Claude Haiku 5.5.
- Das Diffusion-Modell entwirft die gesamte Antwort auf einmal und verfeinert sie parallel, statt Token für Token zu schreiben.
- Der Kontext wächst auf 1 Million Token; der Listenpreis liegt bei 0,20/0,70 Dollar pro Million Input-/Output-Token, zum Launch mit 50 Prozent Rabatt.
- In acht von zwölf Anbieter-Benchmarks liegt Mercury 3 vorne, unabhängige Messungen gibt es noch nicht; Nutzer berichten in der Praxis von 300 bis 400 Token pro Sekunde.
- Verfügbar über Inception, OpenRouter, Baseten und Vercel, kompatibel zur OpenAI-API.
Kurz gesagt: Inception Labs hat Mercury 3 veröffentlicht, das bislang leistungsstärkste Diffusion-Sprachmodell. Es soll GPT-6 Luna und Claude Haiku 5.5 in den meisten Benchmarks schlagen und dabei vier- bis achtmal schneller sein. Der Haken: Alle Zahlen stammen bisher vom Anbieter.
Was Mercury 3 kann
Die Kernzahlen laut Inception Labs: 1.068 Token pro Sekunde auf NVIDIA-GPUs, 1 Million Token Kontext (bisher 260.000 bei Mercury 2.5), Listenpreis 0,20 Dollar pro Million Input- und 0,70 Dollar pro Million Output-Token, zum Launch halbiert auf 0,10 und 0,35 Dollar, gecachte Input-Token 90 Prozent günstiger. Das Modell ist über 40 Mal größer als Mercury 1; eine genaue Parameterzahl nennt Inception nicht.
Warum Diffusion anders arbeitet
Klassische Sprachmodelle schreiben Token für Token, eines nach dem anderen. Ein Diffusion-Modell wie Mercury entwirft dagegen die komplette Antwort auf einmal und verfeinert dann alle Positionen parallel über wenige Durchgänge, wie SiliconANGLE erklärt. Inception-Chef Stefano Ermon sagt, die häufigste Frage seit Mercury 1 sei gewesen, ob Diffusion skaliert; seine Antwort: Die Grenzen lägen in Compute und Daten, nicht im Algorithmus. Mit Mercury 3 sehen die Skalierungsgesetze der etablierten Modelle auch für Diffusion bestätigt aus.
| Benchmark | Mercury 3 | GPT-6 Luna | Claude Haiku 5.5 |
|---|---|---|---|
| SWE-Bench Atlas (Coding) | 51,1 | 33,3 | 32,3 |
| DeepSWE (Coding) | 46,3 | - | 51,6 |
| Gewonnene Tests (von 12) | 8 | 2 | 2 |
Der größte Vorsprung liegt ausgerechnet im Coding: Auf SWE-Bench Atlas erreicht Mercury 3 51,1 Punkte gegen 33,3 und 32,3. Auf DeepSWE liegt Haiku 5.5 mit 51,6 zu 46,3 vorn, zwei weitere Tests gewann GPT-6 Luna knapp. Wichtig: Bisher hat keine unabhängige Stelle eigene Ergebnisse veröffentlicht. Nutzer auf Hacker News berichten von eindrucksvoller, aber niedrigerer Praxis-Geschwindigkeit um die 300 bis 400 Token pro Sekunde, berichtet ai0.news.
Wofür sich das lohnt
Inception zielt auf Anwendungen, in denen jede Verzögerung auffällt: Browser-Agenten, Echtzeit-Nachhilfe, Suche auf Smart Glasses, Kundensupport. Bei Octen AI lag die mediane Generierungszeit in Tests bei 0,9 Sekunden, bei RevisionDojo kommen Hinweise in etwa einer Sekunde zurück, zitiert der Anbieter seine Early-Access-Partner. Dazu kommen Mercury Voice für minimale Zeit bis zum ersten Token und Mercury Decide für Massen-Klassifizierung. Wer testen will: Das Modell läuft über Inception, OpenRouter, Baseten und Vercel, ist OpenAI-API-kompatibel, und es gibt 100 Millionen Gratis-Token zum Start.
Zum Hintergrund: Inception wurde 2024 von den Informatik-Professoren Stefano Ermon, Aditya Grover und Volodymyr Kuleshov gegründet und hat im vergangenen November eine 50-Millionen-Dollar-Runde unter Führung von Menlo Ventures mit Beteiligung von Microsofts M12 abgeschlossen, berichtet SiliconANGLE. Der Nachfolger von Mercury 3 befindet sich laut Ermon bereits im Training.
Was du mitnehmen kannst
- Diffusion-Modelle sind jetzt konkurrenzfähig: Mercury 3 skaliert wie klassische Modelle, nur deutlich schneller.
- 1.068 Token/Sekunde sind Anbieter-Angabe; rechne in der Praxis eher mit 300-400, immer noch sehr schnell.
- Zum Launch kostet das Modell 0,10/0,35 Dollar pro Million Token, OpenAI-kompatibel, ohne Umbau testbar.
- Für latenzkritische Agenten (Browser, Voice, Suche) ist Mercury 3 der interessanteste neue Kandidat.
Häufige Fragen
Was ist ein Diffusion-Sprachmodell?
Klassische Sprachmodelle erzeugen Text Token für Token nacheinander. Ein Diffusion-Modell entwirft stattdessen die gesamte Antwort auf einmal und verfeinert alle Positionen parallel über wenige Durchgänge. Das macht es deutlich schneller, weil die Arbeit parallel statt seriell abläuft.
Ist Mercury 3 wirklich 8 Mal schneller?
Das sagt der Anbieter: 1.068 Token pro Sekunde gegenüber etwa 240 bei Claude Haiku 5.5 und etwa 130 bei GPT-6 Luna. Unabhängige Messungen gibt es noch nicht; Nutzer berichten in der Praxis von 300 bis 400 Token pro Sekunde, was immer noch ein deutlicher Vorsprung wäre.
Was kostet Mercury 3?
Listenpreis sind 0,20 Dollar pro Million Input- und 0,70 Dollar pro Million Output-Token. Zum Launch gibt es 50 Prozent Rabatt (0,10/0,35 Dollar), gecachte Input-Token sind 90 Prozent günstiger. Über die Anbieter-Plattform gibt es 100 Millionen Gratis-Token zum Testen.
Wo kann ich Mercury 3 nutzen?
Über die Inception API Platform sowie über OpenRouter, Baseten und Vercel. Das Modell ist kompatibel zur OpenAI-API, bestehende Anwendungen müssen dafür kaum angepasst werden.
Quellen
- Diffusion at Scale: Introducing Mercury 3 (Inception Labs, abgerufen 2026-10-21)
- Inception says Mercury 3 beats GPT-6 Luna and Claude Haiku 5.5 at up to 8x the speed (SiliconANGLE, abgerufen 2026-10-21)
- AI News - October 20, 2026: Mistral Launches 209M-Param Timestral, Mercury 3 Hits 1K Tokens per Second (ai0.news, abgerufen 2026-10-21)
Weitere Artikel
- Voxtral 3: Mistrals Sprach-Agenten hören, denken und antworten in Echtzeit
- MiniMax M3.1 Flash: Chinas nächster Preisbrecher
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Das Titelbild ist KI-generiert und im Bild entsprechend gekennzeichnet. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.