

KI-Diagnostik im Peer-Review: MAI-DxO trifft 83 Prozent, Ärzte 36
Die wichtigsten Fakten
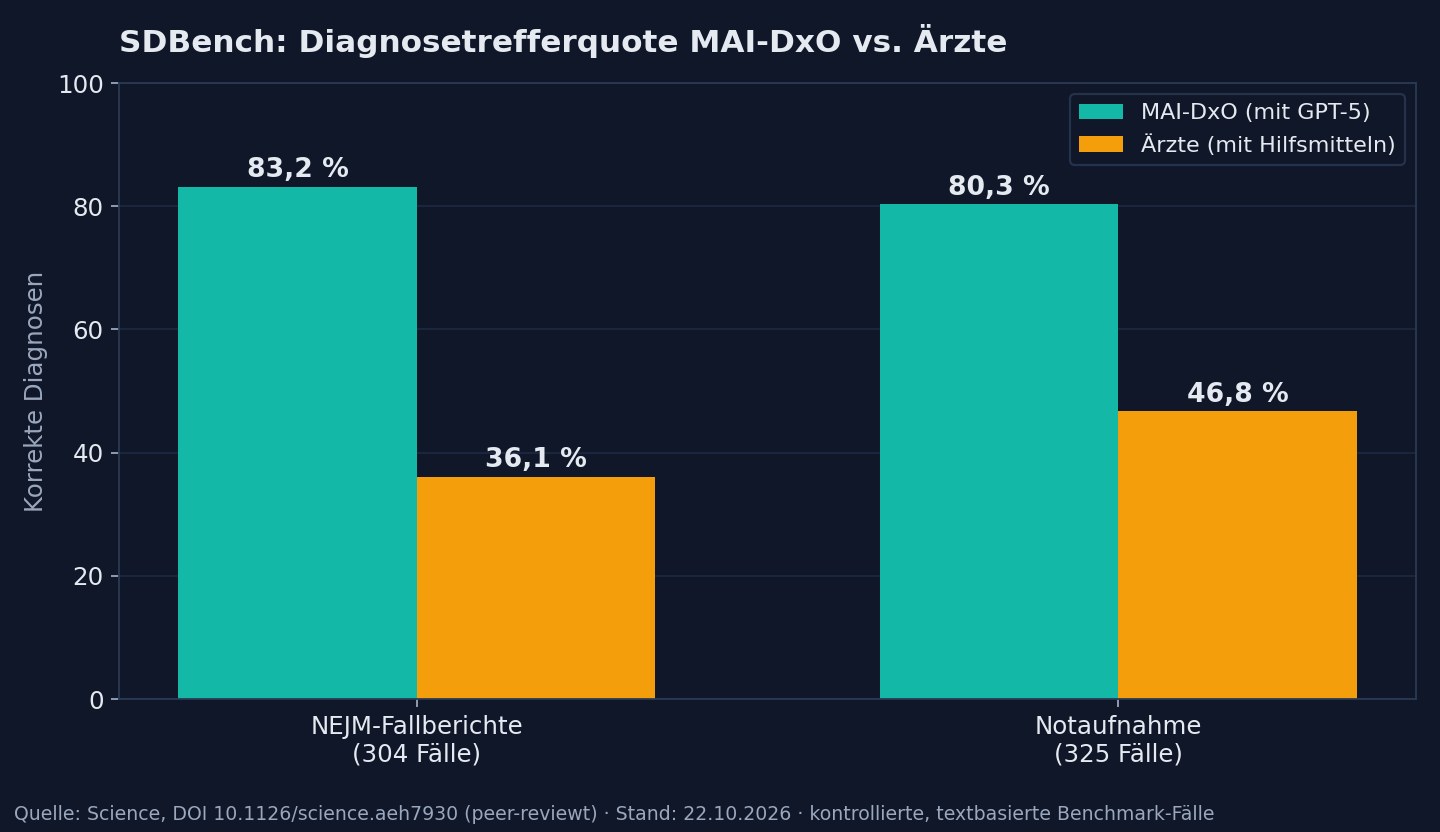
- Die peer-reviewte Science-Studie testet Microsofts MAI-DxO auf 304 schwierigen Fallberichten aus dem New England Journal of Medicine und 325 Notaufnahme-Fällen: 83,2 beziehungsweise 80,3 Prozent korrekte Diagnosen.
- Zum Vergleich: Erfahrene Ärzte kamen bei denselben Fällen mit offenen Hilfsmitteln auf 36,1 Prozent (Fallberichte) und 46,8 Prozent (Notaufnahme).
- Das System arbeitet sequenziell wie ein Ärzteteam: Es stellt Fragen, ordnet Tests an, hinterfragt Befunde und korrigiert sich, statt auf einmal zu antworten.
- Wichtige Einschränkung: kontrollierte, rein textbasierte Benchmark-Fälle ohne Fachärzte und Teamdiagnostik, eine prospektive Studie am Beth Israel Deaconess Medical Center ist in Vorbereitung.
Kurz gesagt: Die Zahl kursierte schon im Sommer, jetzt steht sie im Peer-Review: Microsofts Diagnose-Orchestrator MAI-DxO löst knifflige medizinische Fälle deutlich besser als erfahrene Ärzte, und das nicht als Blackbox, sondern mit nachvollziehbarem Fragen-Testen-Korrigieren. Die Studie ist in Science erschienen.
Die Ergebnisse im Detail
Die in Science veröffentlichte Studie nutzt den neuen Benchmark SDBench: 304 Fallberichte aus dem New England Journal of Medicine und 325 echte, anonymisierte Notaufnahme-Fälle aus MIMIC-IV-ED. MAI-DxO mit GPT-5 als Basismodell erreichte 83,2 Prozent korrekte Diagnosen bei den Fallberichten bei durchschnittlich 5.431 Dollar simulierten Testkosten, und 80,3 Prozent bei den Notaufnahme-Fällen bei 4.979 Dollar. Die 21 erfahrenen Ärzte im Vergleich kamen mit frei verfügbaren Hilfsmitteln auf 36,1 beziehungsweise 46,8 Prozent, ohne Hilfsmittel auf 22,3 Prozent; der beste einzelne Arzt erreichte 51,8 Prozent. Sparvarianten des Systems blieben bei 80,9 Prozent für 2.241 Dollar und 79,6 Prozent für 1.303 Dollar.
Warum der Ablauf der eigentliche Befund ist
MAI-DxO simuliert ein virtuelles Expertengremium: Agenten übernehmen Rollen wie Hypothesenprüfung, Testauswahl, Kostenkontrolle und Qualitätssicherung. Das System stellt im Mittel 25,5 Fragen, bevor es den ersten Test anordnet, Ärzte nur 5,6. Über alle getesteten Basismodelle hinweg brachte die Orchestrierung durchschnittlich 7,9 Prozentpunkte mehr Treffer bei den Fallberichten und 4,4 bei der Notaufnahme. Ohne jede Anpassung hielt sich das System auch mit dem neueren GPT-5.5 an der Pareto-Front aus Genauigkeit und Kosten. Den größten Vorsprung erzielte es bei Diagnosen, die stark auf der Anamnese beruhen.
Die Grenzen
Die Autoren betonen selbst: Es handelt sich um kontrollierte, rein textbasierte Benchmark-Fälle, nicht um echte Patienten. Fachärzte und interdisziplinäre Teams waren nicht Teil des Vergleichs, und die Fälle stammen aus einer Publikation, die bewusst ungewöhnliche Verläufe sammelt. Dass ein Benchmark-Sieg keine Praxistauglichkeit beweist, weiß auch Microsoft: Als Nächstes ist laut Morning Tokens eine prospektive Studie am Beth Israel Deaconess Medical Center geplant, außerdem ein Foundation-Modell mit der Mayo Clinic für das kommende Jahr.
Was du mitnehmen kannst
- Erste peer-reviewte Bestätigung: KI-Orchestrierung schlägt erfahrene Ärzte bei schwierigen Textfällen deutlich, 83 gegen 36 Prozent.
- Das System ist sparsam konfigurierbar: fast gleiche Trefferquote für ein Viertel der Testkosten.
- Der Vorsprung kommt aus dem Verfahren, viele Fragen vor dem ersten Test, nicht aus einem einzelnen Modell.
- Benchmark ist nicht Klinik: prospektive Studien stehen noch aus.
Häufige Fragen
Heißt das, KI diagnostiziert jetzt besser als Ärzte?
In diesem speziellen Setting ja: bei schwierigen, textbasiert vorliegenden Fallberichten und anonymisierten Notaufnahme-Daten. Es fehlen Fachärzte im Vergleich, Teamdiagnostik, echte Patienten und körperliche Untersuchung. Die Autoren ordnen die Ergebnisse selbst als Benchmark-Befund ein, nicht als Praxisbeleg.
Was ist sequenzielle Diagnostik?
Statt auf einen Schlag eine Antwort zu geben, arbeitet das System einen Fall schrittweise ab: Anamnese-Fragen stellen, Hypothesen bilden, gezielt Tests anordnen, Befunde einordnen und die Hypothesen korrigieren, bis die Diagnose steht. Genau dieser Ablauf ist der Unterschied zu bisherigen Medizin-Benchmarks.
Was kostet so eine KI-Diagnostik?
In der Studie werden die simulierten Arztkosten der angeordneten Tests gezählt: im Mittel rund 5.431 Dollar pro Fallbericht, in Sparvarianten 2.241 bis 1.303 Dollar. Die API-Kosten für das Basismodell kommen hinzu und hängen vom Modell ab. Es sind Studienzahlen, keine Preisliste.
Quellen
- Sequential diagnosis with language models (Science, abgerufen 2026-10-24)
- AI News Oct 23, 2026 (Morning Tokens, abgerufen 2026-10-24)
- Microsoft AI Diagnostic Orchestrator (MAI-DxO) (Microsoft AI, abgerufen 2026-10-24)
Weitere Artikel
- OpenAI trainiert Frontier-Modelle jetzt ohne Internet
- Microsoft erklärt KI-Agenten zu Insider-Bedrohungen
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Das Titelbild ist KI-generiert und im Bild entsprechend gekennzeichnet. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.