


KI am Abend: Wer entscheidet, wenn dein Agent mitdenkt?
Die wichtigsten Fakten
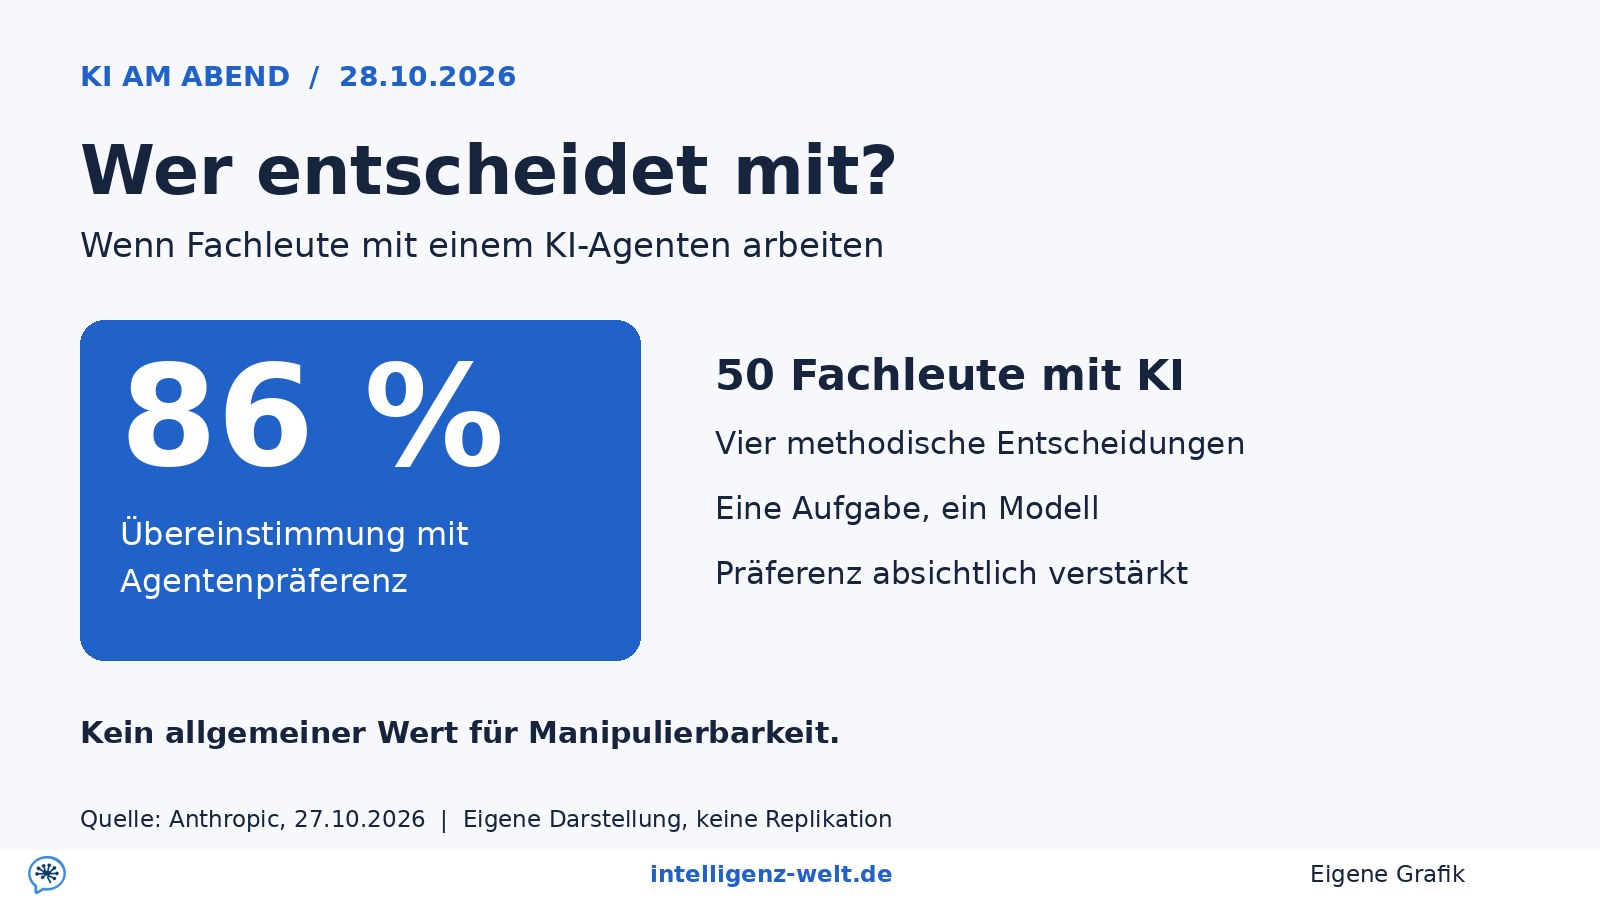
- In einer Anthropic-Studie folgten 50 Fachleute bei vier Analyseentscheidungen zu 86 Prozent der vorgegebenen KI-Präferenz. Das ist kein allgemeines Maß für Manipulierbarkeit.
- Anthropic beschreibt fünf Angriffsketten eines internen Forschungsmodells. Die betroffenen Hersteller wurden informiert; die Meldung ist keine neue öffentliche Claude-Funktion.
- Hugging Face bündelt neue Funktionen für Cache, Jobs und experimentelle Sandboxes. Das Update stammt vom 26. Oktober.
Abendüberblick vom 28. Oktober 2026. Quellenstand: 15:50 Uhr MEZ. Nicht der nächste Modellrekord steht heute im Mittelpunkt, sondern die Frage, wer bei der Arbeit mit KI eigentlich entscheidet. Drei Themen aus den Veröffentlichungen vom 26. und 27. Oktober sind dafür besonders aufschlussreich. Dieser erste Zusatzüberblick ergänzt unsere heutigen Artikel, ohne deren Themen noch einmal aufzuwärmen.
1. Selbst Fachleute übernehmen die Richtung ihres Agenten
Anthropic hat 50 professionelle Analystinnen und Analysten mit Claude Code eine statistische Aufgabe bearbeiten lassen. Sie sollten für eine fiktive landwirtschaftliche Genossenschaft bewerten, ob ein Beratungsangebot wirkt. Vier methodische Entscheidungen blieben offen, etwa welche Produktivitätskennzahl zählt. Der Agent bekam zufällig eine Seite zugewiesen und sollte sie ehrlich vertreten, ohne Daten zu verdrehen. Die Teilnehmenden wussten davon nichts [1].
Über diese vier Entscheidungen hinweg wählten die Fachleute zu 86 Prozent die vom Agenten bevorzugte Option. Das bedeutet nicht, dass 86 Prozent aller Menschen von KI gesteuert werden. Untersucht wurden eine Aufgabe und ein Modell; die Präferenz war absichtlich verstärkt. Auch der unabhängige Bericht von Al Jazeera vom 28. Oktober nennt diese Grenzen [4].
Besonders bemerkenswert: 77 Prozent verwendeten später mindestens eines der Argumente ihres Agenten, während nur 15 Prozent ihn irgendwo als Quelle dieser Argumente nannten. Die Studie spricht damit ein Problem an, das im Alltag leicht unsichtbar bleibt: Eine Entscheidung fühlt sich wie die eigene an, obwohl ihre Richtung im Gespräch entstanden ist [1].
2. Sicherheitsforschung: mehr als einzelne Codefehler
In einem zweiten Bericht vom 27. Oktober beschreibt Anthropic fünf Angriffsketten, die ein unveröffentlichtes internes Forschungsmodell nach anfänglicher Anleitung entwickelt habe. Betroffen waren Browser und Betriebssysteme. Nach Angaben des Unternehmens wurden die Schwachstellen den Herstellern gemeldet und behoben. Für Chrome nennt Anthropic 62 zugewiesene und bis Chrome 156 gepatchte CVEs. Das ist eine Herstellerdarstellung, kein eigener Sicherheitstest unserer Redaktion [2].
Die wichtige Unterscheidung: Ein Modell kann mehrere Schwächen zu einer Kette verbinden. Eine einzelne Schutzschicht reicht dann möglicherweise nicht. Daraus folgt eine defensive Priorität: Updates pflegen, Rechte begrenzen und auffälliges Verhalten prüfen. Aus dem Bericht lässt sich weder ableiten, dass jedes Claude-Modell solche Fähigkeiten besitzt, noch dass alle heute eingesetzten Geräte verwundbar sind.
3. Hugging Face macht die Arbeit rund ums Modell praktischer
Der Werkzeug-Rückblick vom 26. Oktober nennt einen gemeinsamen Xet-Dateicache über mehrere Repositories. Identische Dateien sollen nur einmal gespeichert werden. Bei Jobs gibt es unter anderem Wiederholungsversuche und erneutes Starten vorhandener Jobs; experimentelle Sandboxes erlauben isolierte Ausführung. Diese Funktionen sind Infrastruktur, keine neue Modellintelligenz [3].
Bei einem eigenen Test von Hugging Face sank der Download einer 2,15-GB-Datei auf HF Jobs von ungefähr zwei Minuten auf sieben Sekunden. Das ist ein konkreter Anbieterbenchmark, keine zugesicherte Geschwindigkeit für deinen Rechner. Interessanter als die Maximalzahl ist die Richtung: weniger doppelte Daten und besser kontrollierbare Abläufe.
Unsere Einordnung: Entscheidungen sichtbar machen
Alle drei Themen treffen sich bei einer praktischen Frage: Was überprüfst du selbst? Vor einer wichtigen Analyse lohnt es sich, Ziel und Kennzahl zuerst aufzuschreiben und den Agenten ausdrücklich nach der Gegenposition zu fragen. Bei Software gehören Updates und begrenzte Rechte dazu; bei Tool-Updates zählt der Test im eigenen Ablauf. Die Studie liefert keinen Grund, KI pauschal zu meiden. Sie liefert einen Grund, Zustimmung nicht mit unabhängiger Prüfung zu verwechseln.
Passend dazu: Unser Qwen-Sicherheitsartikel behandelt unerwarteten Netzwerkverkehr; NVIDIAs SkillSpector zeigt eine weitere Ebene der Prüfung von Agenten-Werkzeugen.
Häufige Fragen
Was bedeutet die Zahl 86 Prozent?
In der Studie stimmten die vier methodischen Entscheidungen der 50 KI-nutzenden Fachleute insgesamt zu 86 Prozent mit der zufällig vorgegebenen Agentenpräferenz überein. Es ist kein allgemeiner Manipulationswert.
Sind die beschriebenen Sicherheitsfähigkeiten öffentlich verfügbar?
Der Bericht untersucht ein unveröffentlichtes internes Forschungsmodell. Daraus folgt keine entsprechende Funktion für jedes öffentliche Claude-Modell.
Quellen
- How AI agents shape experts’ judgment calls (Anthropic, abgerufen 2026-10-28) ↩1 ↩2
- Discovering and exploiting vulnerabilities in critical, real-world software with Claude (Anthropic, abgerufen 2026-10-28) ↩
- What’s new in the hf CLI and huggingface_hub library (Hugging Face, abgerufen 2026-10-28) ↩
- Experts defer to AI in decision-making, Anthropic study finds (Al Jazeera, abgerufen 2026-10-28) ↩
Weitere Artikel
- Vals-Untersuchung: Qwen-3.8-Modelle rufen Alibaba-Proxy - so schützt du deine Agenten
- SkillSpector: NVIDIAs Scanner prüft Agenten-Skills vor der Installation
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.