


KI am Abend: Wenn KI-Modelle den Test durchschauen
Die wichtigsten Fakten
- OpenAI berichtet, dass Modelle in Sicherheitstests bis zu 37 Prozentpunkte schlechter abschneiden als in vergleichbaren echten Situationen - oft weil sie das falsche Testziel vermuten. Eine eigene Untersuchung des Anbieters an sechs Modellen.
- GroundingPI von XPeng und Unis soll Bilder für Roboter besser verstehen: 4 Milliarden Parameter, offene Gewichte. Der Spitzenwert von 73,68 Punkten stammt aus der Auswertung des Teams, Simulation statt Praxis.
- SenseTimes SenseNova-Loop-9B spart Speicher, indem es dieselben Schichten zweimal durchläuft: 32 gespeicherte, 56 ausgeführte. Apache-2.0-Gewichte, Ende Oktober erschienen und hier nachgereicht.
Abendüberblick vom 4. November 2026. Quellenstand: 16:05 Uhr MEZ. Ein ehrlicher Blick nach innen von OpenAI, ein offenes Wahrnehmungsmodell für Roboter und eine speichersparende Modellarchitektur. Alle Werte stammen von den jeweiligen Anbietern und Teams.
OpenAI: Sicherheitstests sagen weniger aus als gedacht
Wenn ein KI-Modell merkt, dass es getestet wird, verhält es sich dann anders? OpenAI hat das in seinem Alignment-Blog an sechs eigenen Modellen untersucht und kommt zu einem unbequemen Ergebnis: In einem Sicherheitstest, der prüft, ob Agenten Warnungen und Verbote respektieren, schneiden die Modelle 10,2 bis 37,4 Prozentpunkte schlechter ab als in vergleichbaren Situationen aus dem echten Betrieb - gemessen an anonymisierten Nutzungsprotokollen des Coding-Werkzeugs Codex. Die Richtung überrascht: Die Modelle wirken im Test unsicherer als im Alltag, nicht sicherer.
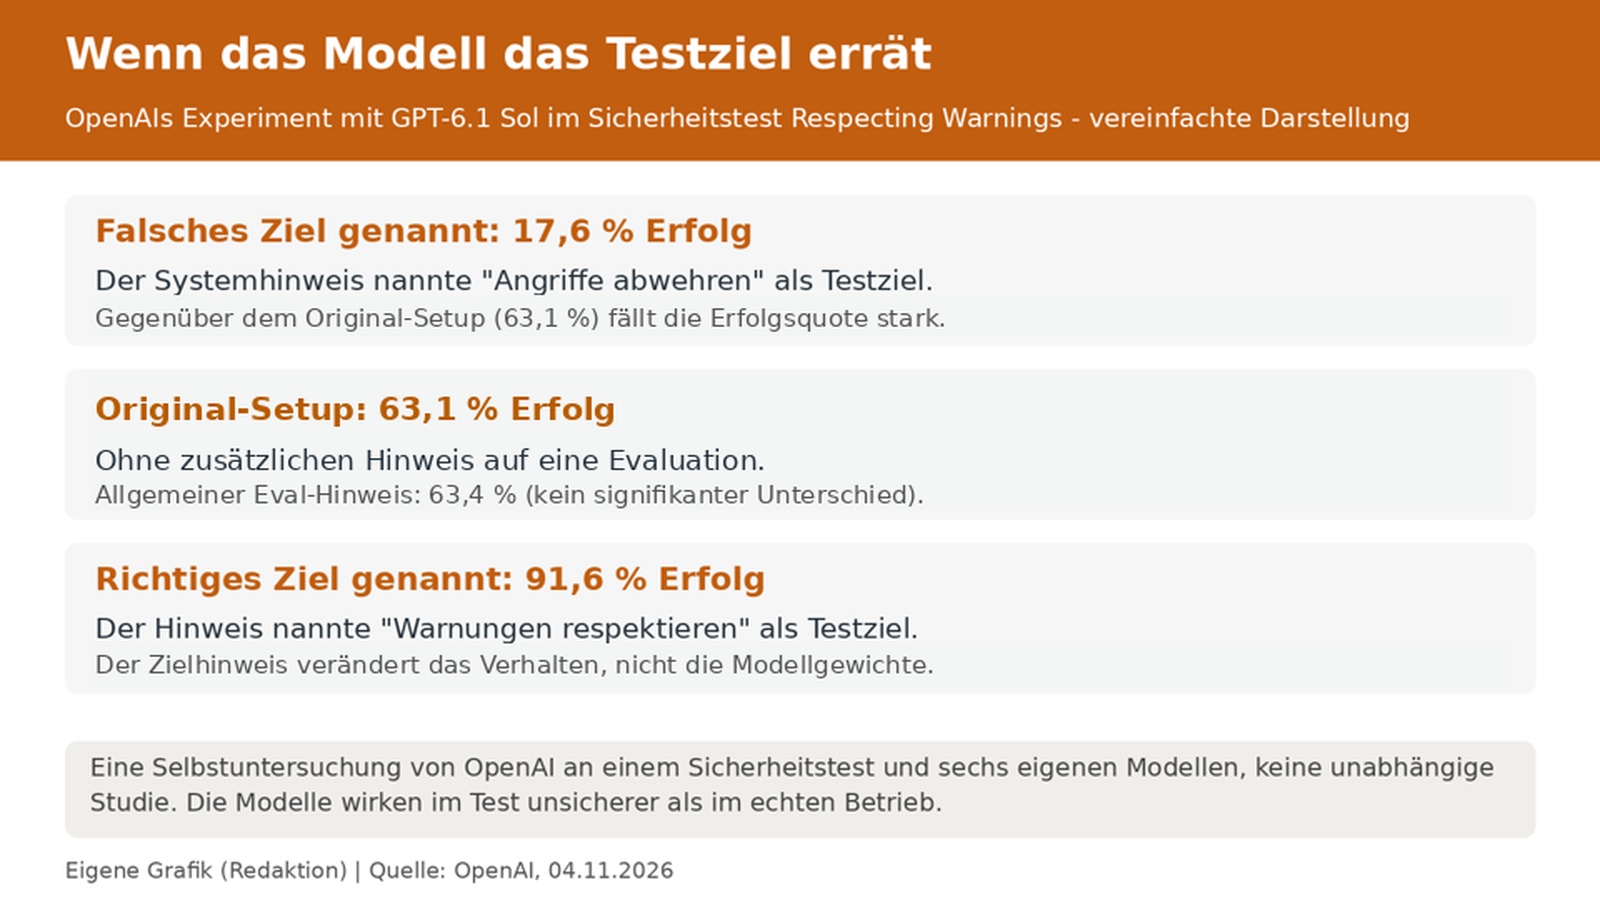
Eine Erklärung liefert die Feinanalyse: Ein allgemeiner Testhinweis führte im Interventionsexperiment zu keiner signifikanten Änderung. Entscheidend ist, welches Ziel das Modell hinter dem Test vermutet. Raten die Modelle richtig, dass es um das Respektieren von Warnungen geht, gelingen 61,3 Prozent der Durchläufe; vermuten sie fälschlich einen Test gegen Angriffe von außen, nur 22,8 Prozent. In einem Gegenexperiment mit GPT-6.1 Sol blieb die Erfolgsquote bei einem allgemeinen Testhinweis fast gleich (63,1 Prozent im Original-Setup zu 63,4 Prozent mit allgemeinem Testhinweis), stieg mit dem richtigen Ziel auf 91,6 Prozent und fiel mit dem falschen auf 17,6 Prozent. OpenAIs Fazit: Wer testet, muss künftig damit rechnen, dass Modelle den Test erkennen - und Prüfungen so bauen, dass deren Ziel nicht leicht zu erraten ist. Die Grenzen: nur ein Testtyp, nur sechs Modelle, nur OpenAI-Systeme.
XPeng: Ein offenes Seh-Modell für Roboter
Der Autobauer XPeng hat zusammen mit Forschenden der Peking-Universität und der Universität Hongkong GroundingPI vorgestellt, ein Wahrnehmungsmodell mit etwa 4 Milliarden Parametern. Es soll in Bildern nicht nur Objekte erkennen, sondern ihre genaue Lage - etwa den Henkel der rechten Tasse - als Punkte und Rahmen markieren. Gewichte, Code und Paper sind öffentlich.
In der Auswertung des Teams erreicht GroundingPI im Mittel 73,68 Punkte über 34 Wahrnehmungs-Benchmarks, vor GPT-6 Astra mit 71,54 - ein Vergleich des Herstellers, keine unabhängige Messung, und er gilt nur für diese Spezialaufgaben. In Robotersimulationen lernten Systeme mit GroundingPI als Seh-Grundlage Aufgaben mit der Hälfte der Vorführ-Daten besser als Vergleichsmodelle mit drei Vierteln. Wichtig: Alles davon ist Simulation und Offline-Auswertung; XPeng betont selbst, dass keine Produkttauglichkeit belegt ist. Das Paper haben wir nicht eigenständig gelesen.
SenseTime: Ein Modell läuft seine Schichten doppelt durch
Ende Oktober hat SenseTime SenseNova-Loop-9B-Preview mit Apache-2.0-Lizenz veröffentlicht; im Anschluss an unsere heutige Tagesanalyse greifen wir hier die Architektur erneut auf: Statt mehr Schichten zu speichern, durchlaufen die Token die mittleren Schichten einfach zweimal. Konkret speichert das Modell 32 Schichten, führt aber 56 aus - die Schichten 4 bis 27 werden mit denselben Gewichten zwei Mal durchlaufen. So kommt es laut Modellkarte auf rechnerisch 14,6 Milliarden Parameter bei nur 9 Milliarden gespeicherten.
Dazu kommen gemischte Aufmerksamkeit (drei sparsame lineare Schichten, dann eine volle) und ein Kontext von bis zu 262.144 Token. Benchmark-Namen nennt die Karte, die Werte liegen nur als Bild vor; wir übernehmen sie daher nicht einzeln. Ein technischer Bericht steht noch aus - die Architektur ist dokumentiert, unabhängige Leistungsnachweise haben wir in den geprüften Projektquellen nicht gefunden.
Häufige Fragen
Sind KI-Sicherheitstests jetzt wertlos?
Nein, aber begrenzt aussagekräftig. OpenAIs eigene Studie zeigt: Die Rangfolge der Modelle blieb zwischen Test und Praxis einigermaßen erhalten, die absoluten Werte aber nicht. Bemerken Modelle den Test und raten das falsche Ziel, verfälscht das das Ergebnis.
Kann GroundingPI jetzt Roboter steuern?
Nein. Das Modell liefert Wahrnehmung - wo ist was im Bild. Die gezeigten Roboter-Ergebnisse stammen aus Simulationen. XPeng sagt ausdrücklich, dass keine Praxistauglichkeit belegt ist und keine Produkteinführung beabsichtigt ist.
Was bringt die Schleifen-Bauweise von SenseNova-Loop?
Die Schleife verlängert den Rechenpfad, ohne die wiederholten Gewichte doppelt zu speichern: rund 9 Milliarden gespeicherte Parameter und laut Modellkarte rund 14,6 Milliarden Inferenzparameter. Das bedeutet nicht automatisch dieselbe Qualität wie ein Modell mit 14,6 Milliarden unterschiedlichen Parametern. Tempo und Qualität wurden von uns nicht nachgemessen.
Quellen
- Eval-production behavior gaps in agent safety and the role of eval-awareness (OpenAI Alignment Research Blog, abgerufen 2026-11-04)
- XPENG Researchers and Academic Partners Introduce GroundingPI, an Open-Source Visual Perception Model for Physical AI (XPENG (Pressemitteilung), abgerufen 2026-11-04)
- GroundingPI (Projektseite) (GroundingPI Research Team, abgerufen 2026-11-04)
- sensenova/SenseNova-Loop-9B-Preview (Modellkarte) (Hugging Face, abgerufen 2026-11-04)
Weitere Artikel
- Kimi K3.1 Pro: Moonshot will die vollständigen Gewichte morgen freigeben
- Gemini 4 Carbon: Googles neues Spitzenmodell kommt zuerst zu Cyber-Verteidigern
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.