


KI am Abend: Drei offene Modelle, drei Lizenz-Modelle
Die wichtigsten Fakten
- Ant Groups Forschungsarm hat Ling-3.1-flash veröffentlicht: ein Riesenmodell mit 560 Milliarden Parametern, von denen nur 25 Milliarden pro Schritt arbeiten. Hub-Metadaten nennen MIT, grundsätzlich auch kommerziell nutzbar; eine separate Lizenzdatei haben wir dort nicht gefunden.
- TwIL-8B von webAI ist ein kleines Denkmodell für Mathe und Programmieren, das laut Anbieter lokal laufen kann. In den Anbieter-Tests schlägt es teils größere Modelle, hakt aber bei Wissensfragen. Wichtig: Die Lizenz erlaubt ausschließlich nichtkommerzielle Forschung und Bildung.
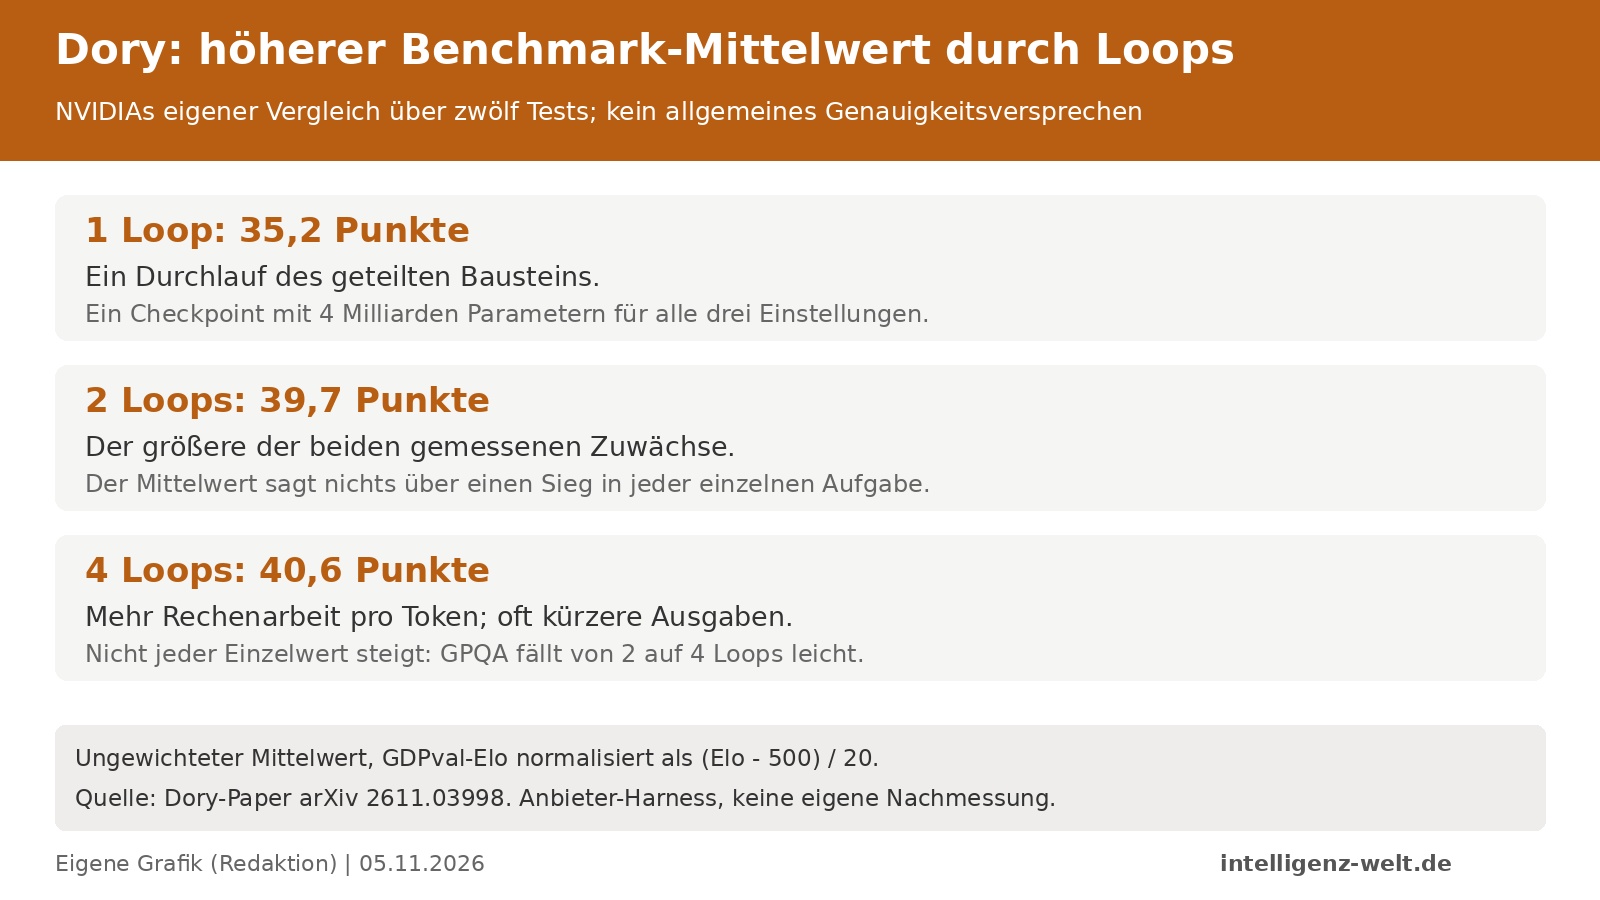
- NVIDIAs Dory1.0-4B arbeitet in Denk-Schleifen: Derselbe Baustein wird mehrfach durchlaufen, je nach Aufgabe öfter oder seltener. Im Papier steigt der ungewichtete Benchmark-Mittelwert bei 1/2/4 Schleifen - ohne dass das Modell größer wird. Kommerzielle Nutzung ist erlaubt.
Abendüberblick vom 5. November 2026. Quellenstand: 16:05 Uhr MEZ. Drei offene Modelle stehen im Fokus - und alle drei zeigen, dass "offen" nicht gleich "frei nutzbar" bedeutet. Alle Leistungswerte stammen von den jeweiligen Anbietern.
Ant Group: Ein Riesenmodell mit Sparflamme
Ling-3.1-flash kommt von inclusionAI, dem Open-Source-Arm der Ant Group (Alibaba-Schwester). Das Modell hat 560 Milliarden Parameter, aktiviert aber pro Rechenschritt nur 25 Milliarden - es verteilt die Arbeit intern auf Hunderte Spezialisten und ruft je nach Frage nur die passenden ab. Es ist der Nachfolger von Ling-3.0-flash und beherrscht einen ein- und ausschaltbaren Denkmodus. Der geprüfte Hub-Stand ist vom 3. November; die Historie enthält bereits Oktober-Commits, das ist kein belegter Releasetag, dazu gibt es Versionen auf ModelScope und OpenRouter.
Die Hub-Metadaten nennen MIT, grundsätzlich auch kommerziell nutzbar. Eine separate Lizenzdatei enthält das geprüfte Repository nicht; wir stützen diese Einstufung ausdrücklich auf die Metadaten. Die Leistungswerte (etwa 81 Punkte im Programmier-Test Terminal-Bench 2.1) stammen aus der Firmenkarte; wir haben keine unabhängige Nachmessung geprüft. Zum Vergleich: Baidus heute vorgestelltes ERNIE-Modell schließt die EU lizenzseitig aus - für Ling nennen die Hub-Metadaten stattdessen MIT.
webAI: Ein Mathe-Ass für den heimischen Rechner - aber nicht fürs Geschäft
TwIL-8B hat 8,79 Milliarden Parameter. Die Karte nennt eine 4,98 GiB große Q4_K_M-GGUF-Datei und lokale CPU-/GPU-Inferenz. Das ist die Dateigröße, kein Gesamt-RAM- oder VRAM-Bedarf: Laufzeit, Kontext und KV-Cache kommen hinzu. Es baut auf IBMs freiem Modell Granite auf und wurde mit mathematischen Wettkampfaufgaben trainiert. In den Tests des Anbieters erreicht es im Test MATH-500 98,2 Prozent und schlägt damit teils Modelle, die etwa 3,5-mal so groß sind. Bei Wissensfragen liegt es dagegen deutlich zurück - und der Anbieter sagt das auch offen.
Der Haken steht wieder im Kleingedruckten: TwIL-8B steht unter einer Nicht-kommerziellen Lizenz. Lizenzabschnitt 3.3 definiert das eng als ausschließlich nichtkommerzielle Forschungs- und Bildungszwecke, auch für Derivate. Eine pauschale Freigabe jedes privaten Einsatzes folgt daraus nicht. Weitergabe erfordert Lizenzkopie und erhaltene Hinweise. Auch bei den Zahlen ist Vorsicht geboten: Ein Teil der Werte stammt von einer Variante des Modells, die noch nicht in allen Tests gelaufen ist, und die Konkurrenzwerte hat webAI aus fremden Modellkarten übernommen statt selbst nachzumessen.
NVIDIA: Ein Modell, das in Schleifen denkt
Dory1.0-4B aus NVIDIAs Nemotron-Werkstatt funktioniert anders als übliche Modelle: Ein mittlerer Baustein wird mehrfach hintereinander durchlaufen - wie ein Gedanke, den man mehrmals durchdenkt. Der Trick: Ein einziges Modell kann so je nach Aufgabe mit weniger oder mehr Rechenarbeit pro Token arbeiten, ganz ohne Umrüstung. Laut dem jetzt vorliegenden Papier steigt der ungewichtete, teils normalisierte Benchmark-Mittelwert von 35,2 Punkten bei einer Schleife auf 40,6 bei vier Schleifen. Die Gewichte sind schon seit Mitte Oktober offen, das Papier mit den Trainingsdetails ist im November erschienen.
Dory wurde laut Paper zunächst auf sechs Billionen Token trainiert, davon rund 4,5 Billionen im gemischten NVFP4-Verfahren. Weitere rund 0,3 Billionen Token dienten der Kontexterweiterung, insgesamt also etwa 6,3 Billionen Token. Ein Energieverbrauchsvorteil wurde von uns nicht geprüft. Die geprüfte OpenMDW-1.1-Lizenz erlaubt auch kommerzielle Nutzung; bei Weitergabe sind Lizenz und Herkunftshinweise zu erhalten. Fremdrechte sind separat zu prüfen. Die Zahlen stammen aus NVIDIAs eigener Testumgebung; in Wissens-Tests bleibt das Vier-Milliarden-Modell erwartbar hinter größeren Modellen zurück. Der ungewichtete Zwölf-Test-Mittelwert normalisiert GDPval-Elo als (Elo - 500) / 20. Einzeltests steigen nicht durchgehend, etwa GPQA von zwei auf vier Loops. Kürzere Ausgaben sind kein Beleg für kürzere Wartezeit oder geringeren Energieverbrauch.
Häufige Fragen
Welches der drei Modelle darf ich kommerziell nutzen?
Ling-3.1-flash (MIT laut Hub-Metadaten, keine separate Lizenzdatei gefunden) und Dory1.0-4B (OpenMDW 1.1) erlauben die kommerzielle Nutzung. TwIL-8B ist ausschließlich für nichtkommerzielle Forschung und Bildung freigegeben. Im Zweifel gilt immer der jeweilige Lizenztext.
Läuft eines dieser Modelle auf einem normalen PC?
TwILs Karte nennt lokale Inferenz und eine 4,98 GiB große Q4_K_M-Datei. Das belegt keinen Gesamt-RAM-Bedarf: Kontext, KV-Cache und Laufzeit kommen hinzu. Dory bietet ebenfalls Quantisierungen; vLLM-PR #60149 wurde am 25. Oktober gemergt, die installierte Version ist separat zu prüfen. Ling ist mit 560B Gesamtparametern groß; die Karte zeigt 8 H200 oder 4 GB300 als Referenz.
Sind die Leistungsangaben verlässlich?
Alle genannten Werte stammen aus den Modellkarten und Papieren der Anbieter selbst. webAI weist selbst auf Messlücken hin; NVIDIA und inclusionAI haben ihre eigenen Testumgebungen genutzt. Wir haben keine unabhängigen Nachmessungen geprüft.
Quellen
- inclusionAI/Ling-3.1-flash (Modellkarte) (inclusionAI / Hugging Face, abgerufen 2026-11-05)
- webAI-Official/TwIL-8B (Modellkarte) (webAI / Hugging Face, abgerufen 2026-11-05)
- nvidia/NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16 (Modellkarte) (NVIDIA / Hugging Face, abgerufen 2026-11-05)
- Dory1.0-4B: A Looped Normalized-GPT (Paper, arXiv 2611.03998) (NVIDIA / arXiv, abgerufen 2026-11-05)
- TwIL webAI Non-Commercial License 1.0 (webAI / Hugging Face, abgerufen 2026-11-05)
- OpenMDW License 1.1 (OpenMDW, abgerufen 2026-11-05)
- vLLM PR #60149: merged 25.10.2026 (vLLM / GitHub, abgerufen 2026-11-05)
- Ling commit history (kein Release-Nachweis) (Hugging Face, abgerufen 2026-11-05)
Weitere Artikel
- Ripple-65B Preview: Offene Gewichte und Coding-Anspruch
- Mistral Large 4 'Le Chonk': Offene Gewichte mit Lizenz-Bedingung
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.