


KI am Abend: Smartwatch als Screening-Hilfe
Die wichtigsten Fakten
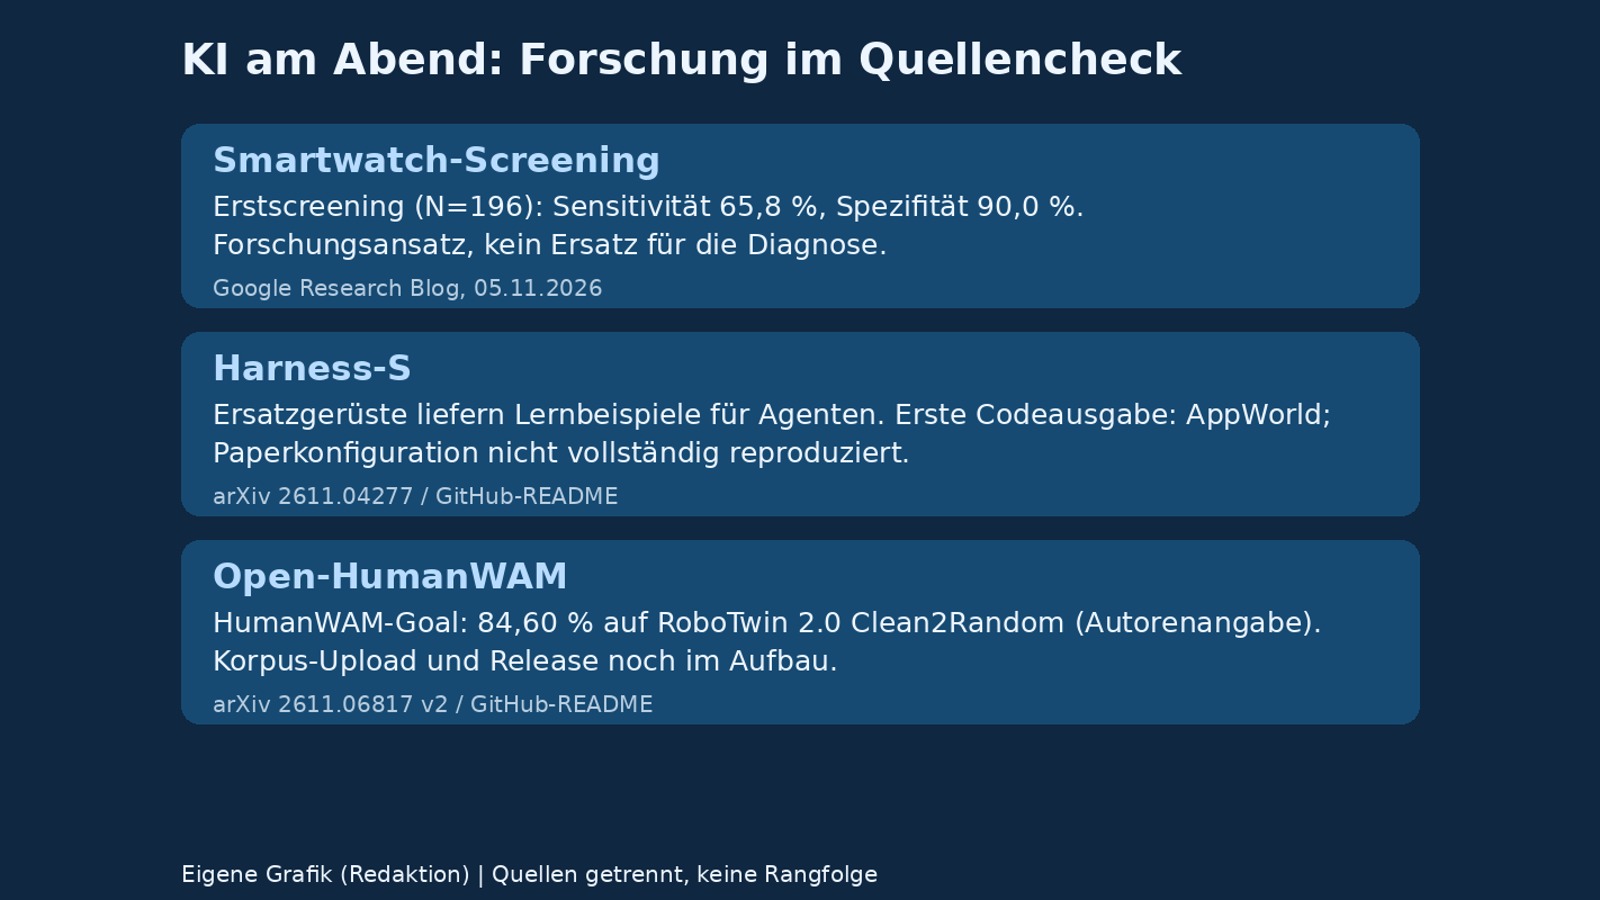
- Google erforscht Bluthochdruck-Screening aus Smartwatch-Sensoren ohne Manschettenkalibrierung. Die Studie (N=196) ersetzt keine ärztliche Diagnose.
- Harness-S lässt eine Agenten-Policy aus Lösungswegen unter Ersatzgerüsten lernen. Erste Codeausgabe: AppWorld, mit Abweichungen zur Paperkonfiguration.
- Open-HumanWAM beschreibt Vortraining auf 50.000 Stunden Menschenvideo. Die Paperwerte sind Autorenangaben; Korpus-Upload und Release sind noch im Aufbau.
Abendüberblick vom 7. November 2026. Quellenstand: 16:07 Uhr MEZ. Drei Themen: Eine Google-Studie liest Bluthochdruck-Anzeichen aus der Smartwatch, eine neue Trainingsmethode gibt Agenten Ersatzgerüste für schwere Fälle, und eine als offen angekündigte Rezeptur skaliert Roboter-Vortraining auf 50.000 Stunden Menschenvideo.
Google: Bluthochdruck-Signale aus der Smartwatch
Google Research stellt in einem Blogbeitrag vom 5. November ein KI-System vor, das Anzeichen für Bluthochdruck passiv aus den Standardsensoren einer Consumer-Smartwatch erkennt - ohne Kalibrierung per Armmanschette. Das System namens AI-PPG-ACC-HTN nutzt dem Beitrag zufolge den optischen Pulssensor (PPG) und den Bewegungssensor, dessen Daten die feinen mechanischen Herzschwingungen (Ballistokardiogramm) enthalten. Zugrunde liegt eine Studie in Nature, begleitet von der Klinik Beth Israel Deaconess und der Harvard Medical School.
Trainiert wurde dem Beitrag zufolge zweistufig: selbstüberwachtes Vortraining auf 492.347 Stunden Sensordaten von 2.109 Teilnehmenden, danach Aggregation der Merkmale über mehrere Trage-Tage plus Körpergröße in einem Klassifikator. Geprüft wurde in einer prospektiven Studie an fünf US-Standorten mit 196 Teilnehmenden ohne bekannte kardiovaskuläre Erkrankung und ohne blutdrucksenkende Medikamente gegen den klinischen Goldstandard der 24-Stunden-Langzeitmessung. Beim Erstscreening erreichte die Uhr laut Google eine Sensitivität von 65,8 Prozent und eine Spezifität von 90,0 Prozent (Praxis-Erstmessung: 55,3 Prozent Sensitivität und 90,0 Prozent Spezifität); bei der Bestätigung zuvor auffälliger Werte (48 Fälle) kam sie auf 78,4 Prozent Sensitivität und 90,9 Prozent Spezifität und lag bei beiden Punktschätzungen über einer erneuten Praxismessung. Google ordnet das Verfahren ausdrücklich als frühe Machbarkeitsforschung ein, nicht als Ersatz für Manschettenmessung oder ärztliche Diagnose. Die Ergebnisse gelten für das untersuchte Kollektiv, nicht als Leistungsversprechen für beliebige Smartwatches.
Harness-S: Agenten lernen von Geschwister-Gerüsten
Wie gut ein KI-Agent arbeitet, hängt auch am Ausführungsgerüst - dem Harness aus Prompts, Werkzeugen und Ablauflogik. Statt ein einziges bestes Gerüst zu suchen, setzt ein Team um Kangning Zhang und Wenxiang Jiao in einem Paper auf arXiv (eingereicht am 3. November) auf einen Pool spezialisierter Geschwister-Gerüste. Die Methode Harness-S ruft diesen Pool dem Abstract zufolge nur dann ab, wenn alle Versuche im Basisgerüst scheitern: Dieselbe Policy erzeugt dann Lösungswege unter einem passenden Ersatzgerüst, und diese Trajektorien ersetzen die Fehlschlaggruppe im Verstärkungslernen. Ein Router wählt die Kandidaten anhand von Verhaltensprofilen und einem Voting mehrerer Sprachmodelle.
Das Ergebnis laut Paper: Auf den Benchmarks AppWorld, SWE-Gym und DBBench schlägt die so trainierte Policy (Basis: Qwen3.5-4B und -9B) reines Policy-Training, obwohl sie wieder im ursprünglichen Gerüst läuft - das aus den Ersatzgerüsten Gelernte überträgt sich demnach auf das Modell selbst. Zusätzliche Gewinne bringe der Router bei unveränderter Zahl von Ausführungsversuchen. Die Angaben stammen aus dem Paper und sind nicht unabhängig geprüft; die erste GitHub-Ausgabe (DeepExperience/Harness-S) deckt AppWorld ab. Sie verwendet standardmäßig regelbasierte Auswahl statt Profil-Voting; der portable GPU-Launcher hat laut README noch keinen vollständigen Trainingslauf bestanden. Der Code bestätigt daher nicht automatisch die Paperwerte.
Open-HumanWAM: 50.000 Stunden Menschenvideo für Roboter
Ein Team um Juncheng Ma (Universität Peking) hat mit Open-HumanWAM eine als offen angekündigte Rezeptur vorgestellt, die Roboter-Vortraining auf 50.000 Stunden egozentrischen Menschenvideos skaliert (arXiv, Version 2 vom 5. November). Der Korpus Open-HumanWAM-50K ist dicht mit Handbewegungen und Sprache annotiert; die Autoren beschreiben ein empirisches log-lineares Skalierungsgesetz zwischen Vortrainingsstunden und späterer Roboter-Erfolgsrate.
Die gemeldeten Werte: Das nur auf Menschenvideo vortrainierte Modell HumanWAM-Vanilla erreicht nach Roboternachtraining dem Paper zufolge 92,08 Prozent Erfolg auf RoboTwin 2.0 (Clean2Clean) und 68,88 Prozent auf Clean2Random. Die Variante HumanWAM-Goal mit gemeinsamem Mensch-Roboter-Vortraining kommt auf 92,70 beziehungsweise 84,60 Prozent und passt ihr Verhalten auf physischen Robotern an ungesehene visuelle Ziele an, ohne Parameterupdate. Alle Zahlen sind Autorenangaben. Der Release ist allerdings noch nicht vollständig: Das GitHub-README nennt einen laufenden Korpus-Upload, ausstehende Gewichte und Anleitungen im Aufbau. Für Vanilla verwendet die öffentliche Evaluation zudem 50 statt der 100 Episoden pro Aufgabe im Bericht. Ein vollständiger, unverändert reproduzierbarer Release ist damit nicht belegt.
Häufige Fragen
Ersetzt die Smartwatch künftig die Blutdruckmanschette?
Nein. Google beschreibt das Verfahren als frühe Machbarkeitsforschung und ausdrücklich nicht als Ersatz für Manschettenmessung oder ärztliche Diagnose. Es soll als passiver Screening-Hinweis dienen, der Betroffene zur Abklärung in die Praxis schickt.
Was ist an Harness-S neu?
Statt ein einziges optimales Ausführungsgerüst zu suchen, hält Harness-S einen Pool spezialisierter Geschwister-Gerüste vor. Scheitert der Agent im Basisgerüst, liefern Ersatzgerüste Lösungswege, aus denen das Modell per Verstärkungslernen lernt - danach läuft es wieder im Originalgerüst, laut Paper mit besseren Ergebnissen.
Was genau ist bei Open-HumanWAM offen?
Das Paper kündigt Korpus, Pipelines, Modellgewichte und Evaluation als offen an. Das aktuelle README meldet aber laufende Uploads und ausstehende Teile. Der Release ist daher nicht als vollständig verifiziert.
Quellen
- Detecting signs of hypertension using wearable sensors (Google Research Blog, abgerufen 2026-11-07)
- Opportunistically Detecting Signs of Hypertension on a Consumer Smartwatch (Nature, abgerufen 2026-11-07)
- Harness-S: Learning from Sibling Harnesses for Generalizable Agent Training (arXiv (Kangning Zhang, Wenxiang Jiao u. a.), abgerufen 2026-11-07)
- DeepExperience/Harness-S (GitHub-Repository) (GitHub, abgerufen 2026-11-07)
- Open-HumanWAM: An Open Recipe for Scaling Human and Robot Experience for Embodied Foundation Models (arXiv (Juncheng Ma, Jiaxin Li u. a.), abgerufen 2026-11-07)
- DAGroup-PKU/HumanNet, Branch open-humanscale (GitHub-Repository) (GitHub, abgerufen 2026-11-07)
Weitere Artikel
- Wie Claude träumt: Anthropic erklärt das Gedächtnis seiner Agenten
- Oumi FAiE: Ein Agent, der KI-Agenten baut, trainiert und verbessert
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.