


KI am Abend: Agenten, Artefakte, Abkürzungen
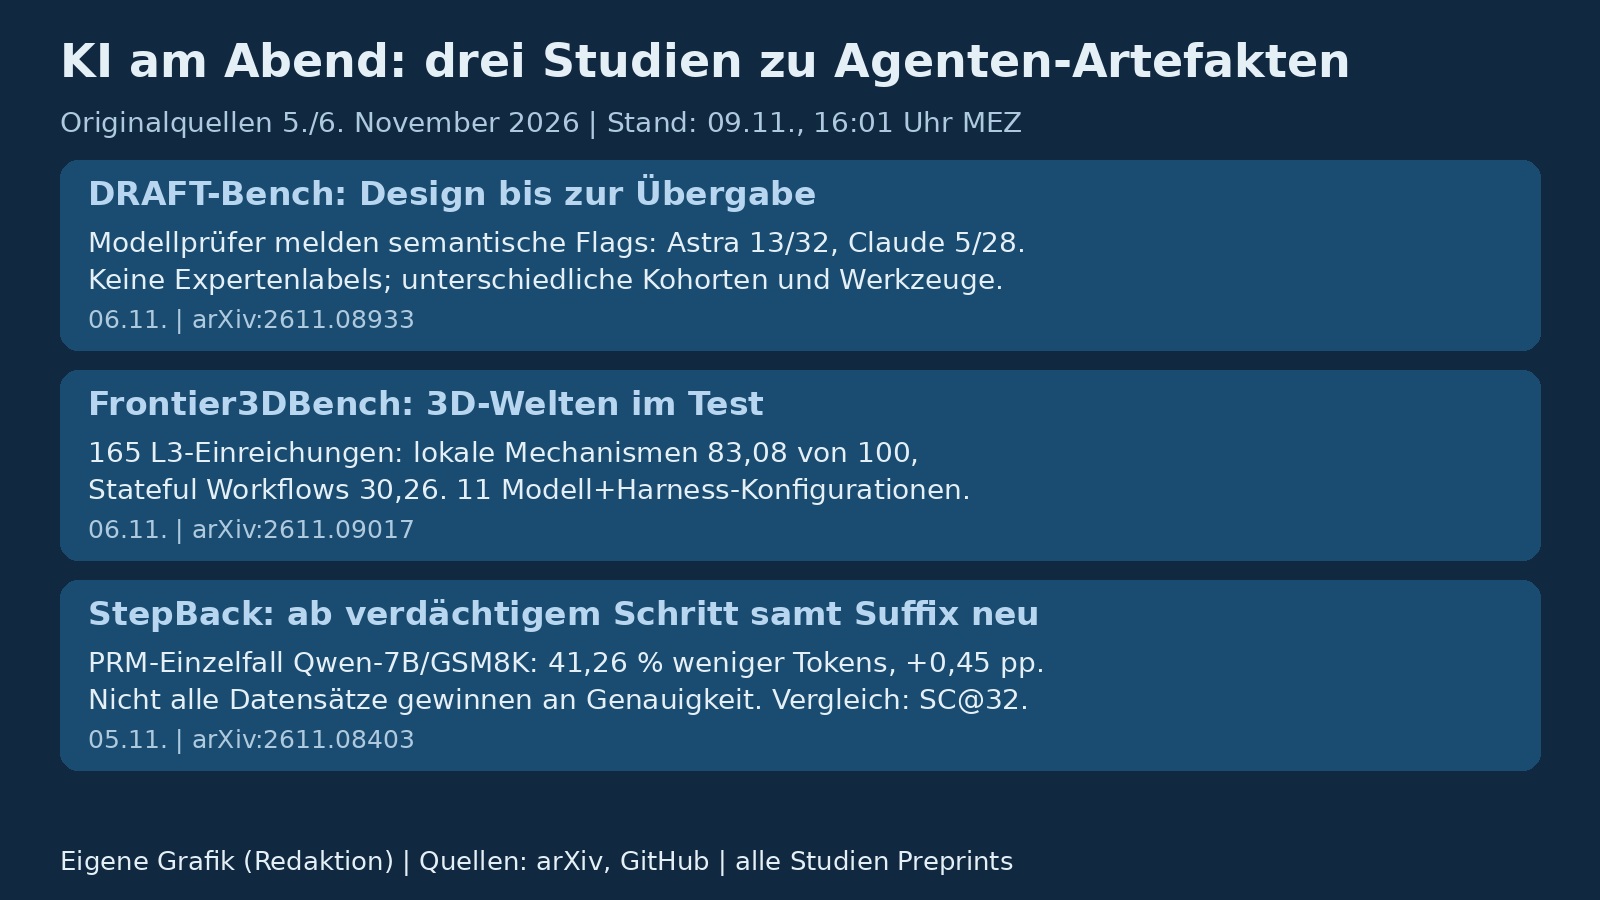
Die wichtigsten Fakten
- DRAFT-Bench prüft Designagenten über den ganzen Auftrag. Alle bewerteten Läufe bestehen die Dateiformprüfung, trotzdem meldet die Inhaltsprüfung Verstöße: bei 13 von 32 Bedingungen des einen Systems, 5 von 28 beim anderen. Es sind Modellurteile, keine Expertenlabels.
- Frontier3DBench: Über 165 L3-Einreichungen erreichen lokale Mechanismen im Mittel 83,08 von 100 Punkten, Stateful Workflows 30,26. Das sind elf Modell-Harness-Konfigurationen mit je 15 Aufgaben.
- StepBack erzeugt ab einem verdächtigen Schritt den gesamten Suffix neu. Der PRM-Einzelfall Qwen-7B/GSM8K spart gegenüber SC@32 41,26 Prozent Tokens bei +0,45 Prozentpunkten Genauigkeit.
Abendüberblick vom 9. November 2026. Quellenstand: 16:01 Uhr MEZ. Drei Arbeiten über eine gemeinsame Frage: Was genau hat ein Agent am Ende geliefert? Zwei Benchmarks prüfen Design- und 3D-Artefakte bis zur Übergabe, ein Decoding-Verfahren zeigt, wie viel Rechenarbeit beim Mehrfach-Reasoning eingespart werden kann. Wir haben die Experimente nicht selbst wiederholt; alle drei Arbeiten sind Preprints.
DRAFT-Bench: Erst Dateiform, dann Inhalt, dann Akzeptanz
DRAFT-Bench (University of Maryland und Curify, arXiv:2611.08933) begleitet Designaufträge über den ganzen Lebenszyklus: Anforderungen klären, Richtungen erkunden, Revisionen ausführen, Produktionsdateien übergeben. Dazu gehören 35 Aufträge unter 43 Bedingungen und eine separate Spur mit 40 simulierten Kundenanfragen. Das Ergebnis trennt drei Dinge sauber: Lauf abgeschlossen, Dateiform in Ordnung, Inhalt erfüllt die Anforderung. Alle bewerteten Kernläufe beider Systeme - Codex CLI mit GPT-6-Astra und Claude Code mit Opus 5.5 - erhalten volle strukturelle Punktzahl. Die semantische Prüfung meldet trotzdem mindestens einen Verstoß bei 13 von 32 bewerteten Kernbedingungen von Astra und 5 von 28 bei Claude (auf den 28 gemeinsamen: 11 zu 5). Die Autoren betonen: Das sind Urteile eines Modellprüfers, keine von Experten bestätigten Fehlerraten.
Auch die Reihenfolge der Systeme ist weniger stabil, als sie aussieht. In der Anfragespur wechselt sie zwischen den beiden Kohorten: Bei den ursprünglichen 20 Szenarien liegt Claude mit 18 zu 17 vorn, in den 19 zusätzlichen gemeinsam bewerteten kehrt sich das mit 19 zu 16 für Astra um. In der Ausführung schließt Astra alle 43 Bedingungen ab, Claude 35 von 43, darunter acht Zeitüberschreitungen am 60-Minuten-Limit pro Zug. Zwischen den Systemläufen wurde außerdem die Judge-Policy ohne erneute Bewertung geändert. Die Systeme liefen mit unterschiedlichen Werkzeugen, Laufzeiten und Isolation; eine reine Modellrangfolge lehnen die Autoren ausdrücklich ab. Aufgaben und Toolkit sind öffentlich.
Frontier3DBench: Mechanismen funktionieren, Abläufe nicht
Frontier3DBench (Einsia.AI und Tsinghua University, arXiv:2611.09017) lässt elf Modell-Harness-Kombinationen 145 Aufgaben in drei Stufen lösen: 65 Einzelobjekte und 65 Szenen in Blender, 15 interaktive offene Welten in Unreal Engine. Die höchste Gesamtpunktzahl erreicht GPT-6.1-sol im Codex-Harness mit 66,02 von 100; die Welten führt GPT-6-astra an. Durchgängig gilt: Aus Textanweisungen plausible Inhalte zu erzeugen ist leichter als eine vorgegebene Referenz zu treffen - jede Konfiguration punktet bei der Rekonstruktion schlechter als bei freier Generierung.
Am aufschlussreichsten ist die Zerlegung der 165 Welten-Einreichungen (11 Konfigurationen mal 15 Aufgaben): Einzelmechanismen erreichen im Mittel 83,08 von 100 Punkten, Bewegungsfreiheit von Teilen nur 20,82, zusammenhängende Aktivitäten mit dauerhaftem Zustand 30,26. Eine Tür geht also meist auf, aber ein Ablauf aus mehreren aufeinander aufbauenden Aktionen scheitert. Eine Prüfung mit acht menschlichen Bewertern über 45 Items aus vier referenzgebundenen L1-/L2-Aufgabenfamilien (360 Urteile) zeigt, dass die automatische Bewertung mit menschlichen Rangfolgen mindestens so gut übereinstimmt wie die Bewerter untereinander (Kendall-Tau 0,727 gegenüber 0,679). Alle Werte sind Modell-plus-Harness-Kombinationen aus je einem Lauf pro Aufgabe; wir haben diese Ergebnisse nicht selbst repliziert.
StepBack: Ab dem verdächtigen Schritt neu erzeugen
Self-Consistency, das Mehrfach-Reasoning mit Mehrheitswahl, erzeugt jede Antwortspur komplett neu. StepBack (North Carolina State University, arXiv:2611.08403) spaltet die Spuren in Schritte, sucht den ersten verdächtigen Schritt mit einem leichten Signal - Konfidenzabfall des Modells selbst oder Urteil eines kleinen Prozess-Bewertungsmodells - und generiert nur ab dort neu. Bei gleichem Antwortbudget wie Self-Consistency mit 32 Spuren bleibt die Trefferquote im Mittel über sieben Benchmarks und drei kleine Modelle (3B bis 7B) gleich oder steigt leicht (plus 0,17 bis 0,82 Punkte mit dem Bewertungsmodell), während die Tokenzahl um 18,66 bis 22,80 Prozent sinkt; mit dem NLL-Konfidenzsignal betragen die modellweisen Durchschnittsersparnisse 27,74 bis 33,32 Prozent, bei Genauigkeitsänderungen von -0,17 bis +0,55 Prozentpunkten. Die 41,26 Prozent sind dagegen ein PRM-Einzelfall: Qwen-7B auf GSM8K mit +0,45 Prozentpunkten Genauigkeit gegenüber SC@32. In sechs der 21 PRM-Modell-Datensatz-Paare fällt die Genauigkeit geringer aus.
Das Verfahren lässt sich mit adaptiven Methoden kombinieren, die zusätzlich die Zahl der Spuren begrenzen: In der besten Kombination (mit DSC auf GSM8K) braucht es 5,2-mal weniger Tokens als Self-Consistency bei 0,9 Punkten höherer Trefferquote. Die Grenzen nennen die Autoren selbst: nur zwei Lokalisierungssignale getestet, nur Mathematik und Mehrschritt-Fragebeantwortung, Modelle bis 7B, und bei den schwersten Wettbewerbsaufgaben wird der Vorteil instabil - manche Fehler liegen zu früh, um sie durch lokales Neuwerfen zu reparieren.
Häufige Fragen
Heißt DRAFT-Bench, dass Claude besser liefert als Astra?
Das sagt die Studie gerade nicht. Die Systeme liefen mit unterschiedlichen Werkzeugen und Laufzeiten, Astra schloss mehr Bedingungen ab, Claude bekam auf den gemeinsamen 28 weniger Verstoßmeldungen. Die Autoren lehnen eine reine Rangfolge ab und verlangen Expertenbewertung als nächsten Schritt.
Warum sind 83 Punkte bei Mechanismen keine gute Nachricht?
Weil der Wert nur Einzelteile misst. Eine Welt besteht aus verketteten Aktionen mit dauerhaftem Zustand, und genau dort sinkt der Schnitt auf 20,82 beziehungsweise 30,26 Punkte. Für Spiele oder Simulationen zählt der Ablauf, nicht das Einzelteil.
Spart StepBack bei jeder Inferenz Tokens?
Nur wo Mehrfach-Reasoning mit Mehrheitswahl eingesetzt wird, und bisher nur gezeigt für Mathematik und Mehrschritt-Fragen mit Modellen bis 7B. Bei sehr schweren Aufgaben schrumpft der Vorteil. Code oder lange Zusammenfassungen sind noch ungetestet.
Quellen
- DRAFT-Bench: Evaluating Frontier Agents Across the Professional Design Lifecycle (arXiv (University of Maryland / Curify), abgerufen 2026-11-09)
- DRAFT-Bench: Aufgaben und Toolkit (GitHub / super-inbox, abgerufen 2026-11-09)
- Frontier3DBench: Benchmarking Coding Agents for 3D Creation across Objects, Scenes, and Interactive Open Worlds (arXiv (Einsia.AI / Tsinghua University), abgerufen 2026-11-09)
- StepBack: Step-Level Error-Localized Resampling for Efficient Test-Time Reasoning (arXiv (North Carolina State University), abgerufen 2026-11-09)
Weitere Artikel
- Apiiro findet Secrets in 1.122 öffentlichen Claude-Code-Dateien
- Taste-Bench: KI-Agenten treffen schlechte Langzeit-Entscheidungen
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.