


KI am Abend: Belohnungskosten, Gutachter im Test, Enthaltung mit Grenzen
Die wichtigsten Fakten
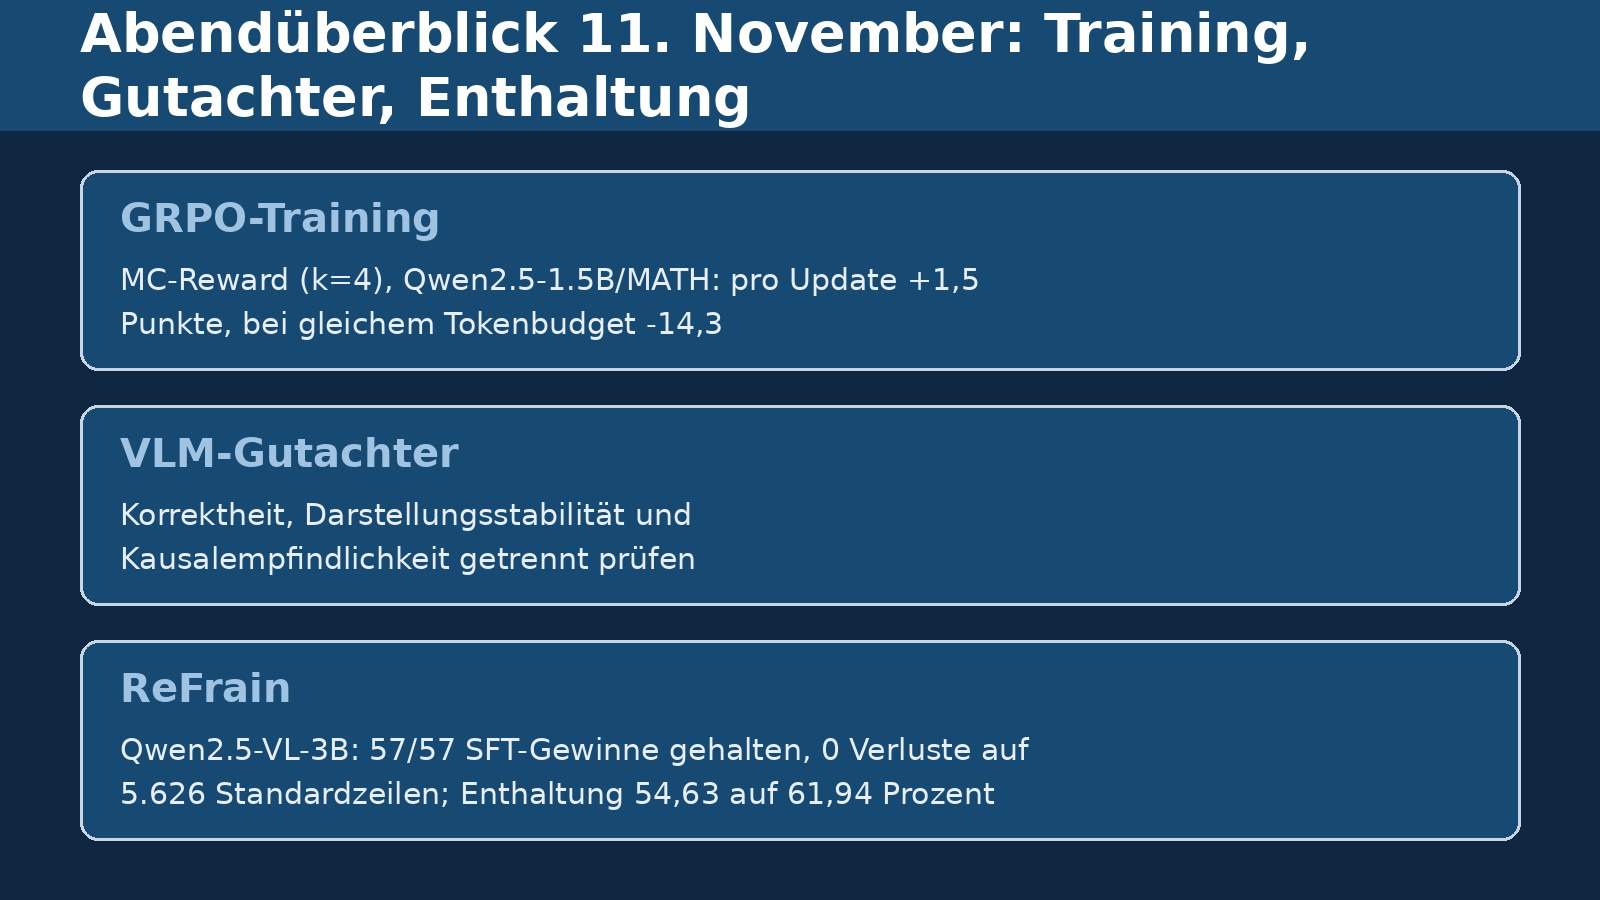
- Die Studie umfasst 1.668 Läufe mit sechs Modellen. Die MC-Belohnung mit k=4 auf Qwen2.5-1.5B/MATH endet bei gleichem Tokenbudget 14,3 Punkte hinter GRPO (Intervall 12,7 bis 16,0); pro Update liegt sie vorn, weil ihre Fortsetzungen 91 Prozent der erzeugten Tokens verbrauchen und nur 50 statt 584 Updates möglich sind.
- GridWM-Judge prüft zehn VLM-Gutachter mit gekoppelten Original- und Kontrafaktik-Trajektorien. Die Diagnose trennt Korrektheit, Darstellungsstabilität und Kausalempfindlichkeit; ein stabiler Gutachter kann trotzdem falsch urteilen.
- ReFrain auf Qwen2.5-VL-3B: Im Null-Budget-Punkt bleiben alle 57 SFT-Gewinne erhalten, auf 5.626 Standardzeilen geht keine ursprünglich richtige Antwort verloren. Korrekte Enthaltung steigt von 54,63 auf 61,94 Prozent. Keine allgemeine Verlustgarantie.
Abendüberblick vom 11. November 2026. Quellenstand: 16:03 Uhr MEZ. Drei Studien vom 10. November stellen Messfragen in den Mittelpunkt: Was kosten dichte Belohnungen beim Verstärkungstraining unter fairer Rechenrechnung, wie verlässlich beurteilen große Bildmodelle die Trajektorien von Agenten und wie lässt sich einem Modell das Enthalten beibringen, ohne bereits richtige Antworten zu opfern. Alle Zahlen sind Angaben der Autorenteams; die Versuche wurden von uns nicht wiederholt.
Dichte Belohnungen sind pro Update effizienter und enden trotzdem hinten
Singh und Kollegen (Case Western Reserve University) rechnen die gängige Rechnung neu: In einem Protokoll mit angeglichenem Rechenaufwand und vorab registrierten Studien laufen 1.668 Experimente mit 1.468 GPU-Stunden über sechs Qwen- und Llama-Modelle. Die Monte-Carlo-Belohnung mit k=4 auf Qwen2.5-1.5B-Instruct und MATH steckt 91 Prozent der erzeugten Tokens in Fortsetzungen, sodass nur 50 statt 584 Updates möglich sind. Pro Update liegt sie mit 1,5 Punkten (Intervall 1,0 bis 2,1) vorn und ist 1,56-mal so effizient. Bei gleichem Tokenbudget endet sie dennoch 14,3 Punkte hinter GRPO (Intervall 12,7 bis 16,0; fünf Seeds, Holm p=5e-5), auf zwölf frischen Seeds 14,9 Punkte dahinter, und bei gleicher Trainingszeit 7,8 Punkte (6,8 bis 8,8). Keine dichte Variante schlägt GRPO bei gleicher Trainingszeit: Vier-Fortsetzungen minus 3,3 Punkte, Wiederverwendung minus 5,2, VinePPO-artig minus 1,1 innerhalb der Äquivalenzgrenze von ±2, k=1 minus 1,1 ohne Signifikanz.
Ein Gradiententest misst zwar hohe Übereinstimmung (anfänglicher mittlerer Kosinus 0,84; bei späteren Prüfständen des hoch gewichteten Rewards 0,969 bis 1,000), überschätzt aber jede Belohnungsvariante um ein bis zwei Punkte. Ein hohes Gewicht von α=5 verliert 12,4 Punkte, während die Entropie von 0,21 auf 0,58 steigt; die Autoren lesen das als Überoptimierung, nicht als Fehlausrichtung. Die Auswahl von Trainingsaufgaben nahe einer vorhergesagten Erfolgsquote von 1/2 bringt 1,7 Punkte (Qwen3-0.6B) beziehungsweise 0,8 (Qwen2.5-1.5B) bei gleichen Tokens und repliziert auf frischen Seeds und 1.543 ungesehenen Aufgaben; der Vorsprung entspricht 0,78 des Tokenbudgets, schmilzt bei doppeltem Budget auf 0,5 Punkte (Intervall −0,5 bis +1,6, äquivalent zu null) und eine neu abgestimmte Lernrate der GRPO-Baseline kommt bis auf 0,5 Punkte heran. Ein nachsichtiger Prüfer führt dazu, dass Läufe aufhören, Antworten zu boxen; ein strikter Prüfer beseitigt den Drift ohne Genauigkeitsverlust. Der Code ist öffentlich.
Zehn VLM-Gutachter reagieren auf die Verpackung der Beweise
Zhang, Wang, Jin und Kollegen (University of Science and Technology of China) fordern von Gutachter-Modellen Zustandsbedingte Invarianz: stabil gegenüber Darstellungsänderungen, empfindlich gegenüber kausalen Änderungen des Ausgangs. Ihr GridWM-Judge erzeugt deterministische MiniGrid-Trajektorien als prüfbare Referenz, dazu abgeglichene Varianten mit entfernter Evidenz und kontrafaktischem Ausgang sowie Darstellungssonden; fünf diagnostische Aufgaben prüfen Wahrnehmung, Übergänge, Darstellungsstabilität, Repräsentationsaustausch und Kausalunterscheidung. Getestet werden zehn Gutachter, darunter Claude Sonnet 4.6, GPT-4o, GPT-5.4, Gemini 3 Flash, Kimi K2.5 und drei Qwen3-Größen.
Korrektheit sagt nichts über Kausalempfindlichkeit: In der Kausalaufgabe akzeptiert GPT-5.4 erfolgreiche Trajektorien zu 0,750 und verwirft Kontrafaktische zu 0,500 (rohe Unterscheidung 0,333), Claude Sonnet 4.6 liegt bei 0,250 beziehungsweise 0,917 (0,250); auf 432 erweiterten Gruppen stehen 0,322 (Intervall 0,278 bis 0,366) gegenüber 0,088 (0,062 bis 0,116). Sonnet 4.6 fällt unter Storyboard-Bildern in einen Alles-falsch-Modus (Übereinstimmung 0,06) und ist unter Einzelbildern nach dem Diagnosekriterium nicht degeneriert; Qwen3-32B neigt dort zu Erfolgsurteilen. Der Wechsel von Storyboard zu Einzelbildern verschiebt die rohe Unterscheidung im Mittel um +0,173, über die Modelle hinweg nicht signifikant (p=0,063). Die Autoren begrenzen ausdrücklich: kontrollierte Diagnose in einer symbolischen Gitterwelt mit deterministischen Läufen, keine Einsatzschätzung für echte Roboter, kein Leaderboard. Ergänzende MiniWorld-/Habitat-Versuche werden separat berichtet. Sie empfehlen, Korrektheit, Darstellungsstabilität und Kausalempfindlichkeit nur gemeinsam zu berichten. Bildformat, Prompt-Wortlaut und Laufbedingungen änderten sich gemeinsam; der Unterschied lässt sich nicht allein dem Layout zuschreiben.
Enthalten lernen ohne richtige Antworten zu verlieren
Jinyuan Zhang (Hubei University) formuliert die nachträgliche Enthaltungsreparatur als Constraint-Problem: maximiere korrekte Enthaltung unter der Bedingung, dass der Verlust ursprünglich richtiger Antworten ein Budget ε nicht überschreitet. ReFrain nutzt eine lineare Sonde auf den Logits des ersten Tokens, eine Schwellenkalibrierung auf zurückgehaltenen Bildclustern und ein deterministisches Veto zugunsten der angezeigten Keine-der-Optionen-Antwort. Auf einem geteilten Qwen2.5-VL-3B-Prüfpunkt hält das Null-Budget alle 57 durch Nachtraining gewonnenen Antworten, verliert unter 5.626 Standard-Auswertungszeilen keine ursprünglich richtige Antwort und hebt die korrekte Enthaltung von 54,63 auf 61,94 Prozent (+7,30 Punkte); bei ε=0,5 Prozent erreicht es 74,05 Prozent mit acht Verlusten und 55 erhaltenen Gewinnen.
Am gleichen Ausgangspunkt gemessen erreicht CLIP-UP EmbLoRA 64,65 Prozent bei 62 Verlusten, dieselbe Sonde ohne Kalibrierung verliert 298 richtige Antworten, und einfaches Enthaltungs-Nachtraining kommt auf 87,47 Prozent bei 140 Verlusten. Eine nach dem Einfrieren aller Schwellen gelaufene Bestätigung auf 228 unabhängigen AI2D-Bildclustern zeigt 66,05 Prozent korrekte Enthaltung ohne Verluste am 0,5-Prozent-Punkt (+32,72 Punkte über EmbLoRA); Enthaltungs-Nachtraining liegt dort 4,90 Punkte über ReFrain, allerdings mit Verlusten. Grenzen: ein einziger Trainings-Seed, 677 Trainingszeilen, die Schranke deckt nur das Null-Budget und einen neuen austauschbaren Cluster, und die Gewinnerhaltungswerte stammen nur von Qwen2.5-VL-3B. Der Code ist öffentlich.
Häufige Fragen
Warum verlieren dichte Belohnungen, obwohl sie pro Update besser dastehen?
Weil die Monte-Carlo-Variante 91 Prozent ihrer erzeugten Tokens in Fortsetzungen steckt und dadurch nur 50 statt 584 Updates schafft. Pro Update gewinnt sie 1,5 Punkte, bei gleichem Tokenbudget verliert sie 14,3.
Bedeutet ein stabiler Gutachter automatisch ein zuverlässiger?
Nein. Ein Gutachter, der immer dasselbe Urteil fällt, ist stabil ohne zuverlässig zu sein; die Studie zeigt etwa einen Alles-falsch-Modus unter Storyboard-Bildern und empfiehlt gemeinsames Berichten von Korrektheit, Stabilität und Kausalempfindlichkeit.
Garantiert ReFrain, dass keine richtige Antwort verloren geht?
Nein. Das Budget null ist eine empirische Bedingung auf Kalibrierungsdaten; die Schranke gilt nur für das Null-Budget und einen neuen austauschbaren Cluster, und auf zwei Basismodellen ohne Nachtraining gingen zwei beziehungsweise vier richtige Antworten verloren.
Quellen
- Are Dense Rewards Worth Their Tokens in GRPO? A Matched-Compute Study (arXiv (Singh u.a.; Case Western Reserve University), abgerufen 2026-11-11)
- Towards Reliable VLM Judges: State-Conditional Invariance and Presentation-Aware Diagnostics (arXiv (Zhang, Wang, Jin u.a.; University of Science and Technology of China), abgerufen 2026-11-11)
- Multimodal Abstention That Preserves Acquired Correct Answers (arXiv (Jinyuan Zhang; Hubei University), abgerufen 2026-11-11)
Weitere Artikel
- Visa-Benchmark: 43 Prozent der simulierten Shopping-Läufe scheitern
- Anthropic-Experiment: Claude-Agenten schreiben Trainingsdaten, die den Sicherheitsmonitor austricksen
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.