


KI am Abend: Entropie-Spitzen, enge Fits, Bits gegen Reihenfolgen
Die wichtigsten Fakten
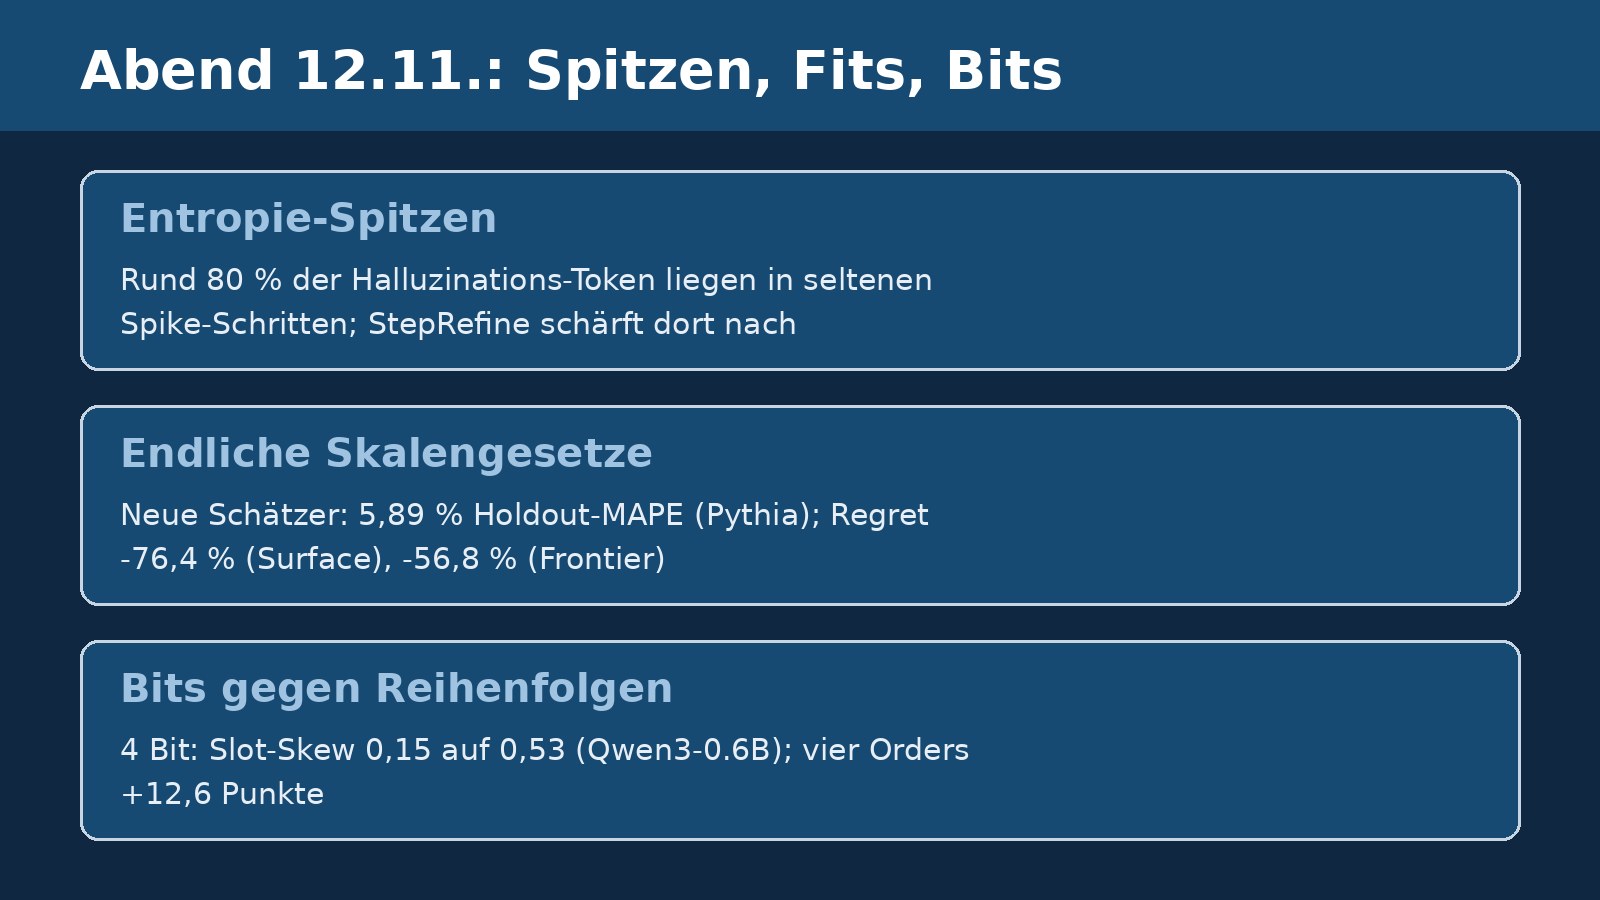
- StepRefine: In der Analyse von LLaDA-V und Dream-VL liegen rund 80 Prozent der Halluzinations-Token in Entropie-Spike-Regionen. Bei LLaDA-V-8B steigt MMHalu von 3,35 auf 3,50 (Skala 0-6), Bingo von 2,71 auf 2,93 (Skala 1-5). Zusätzliche Verfeinerungsrunden ersetzen spätere Dekodierschritte.
- Skalengesetze bei endlichen Budgets: Autoren melden 5,89 Prozent Holdout-MAPE auf Pythia-Standard und 76,4 Prozent weniger Surface-Allokations-Regret mit einem log-quadratischen Fit auf dem digitalisierten Chinchilla-Archiv. Das ist eine retrospektive Auswahlmessung, keine gemessene Einsparung eines neuen Trainingslaufs.
- Bits gegen Reihenfolgen (Qwen3-0.6B/1.7B, simulierte RTN-Quantisierung): 6 Bit ohne Accuracy-Verlust in diesem Protokoll; vier Orders bringen bei 4 Bit plus 12,6 Prozentpunkte für 0.6B. Kosten sind ein Gewichtsbyte-Proxy, keine Latenzmessung; die Studienempfehlung ist nicht auf alle lokalen Modelle übertragbar.
Abendüberblick vom 12. November. Quellenstand: 16:02 Uhr MEZ. Heute: ein gezielter Reparaturschritt gegen Halluzinationen in Diffusionsmodellen, eine Theorie der Skalengesetze vor ihrem asymptotischen Bereich und ein Kostenvergleich zwischen Gewichts-Bits und Antwort-Reihenfolgen.
Halluzinationen in Diffusionsmodellen: Wo sich Fehler häufen
Multimodale Diffusions-Sprachmodelle erzeugen ihre Antworten in vielen Entrauschungsschritten. Ein Team um Zhongxing Xu (Monash University, Cornell, UC Santa Cruz, Northeastern, University of Minnesota) zeigt: Die mittlere Masken-Entropie sinkt dabei nicht monoton, sondern zeigt an wenigen Schritten scharfe Spitzen. Diese Schritte sind selten, doch rund 80 Prozent der halluzinierten Token liegen in ihrer Umgebung; 71 Prozent der Spitzen treten bei LLaDA-V, 62 Prozent bei Dream-VL in der ersten Hälfte der Schritte auf, wenn noch viele Positionen maskiert sind. Die Gegenmaßnahme StepRefine arbeitet trainingsfrei beim Dekodieren: Überschreitet die Entropie-Änderung das lokale Mittel plus eine Standardabweichung, schaltet der Schritt von diskreten Tokens auf latente Verfeinerung um; mehrere Verfeinerungsrunden mit wahrscheinlichkeitsgewichteten Embeddings schärfen die Verteilung, bevor der Kandidat festgeschrieben wird. Die Extrarunden werden gegen das verbleibende Schrittbudget gebucht, ersetzen also spätere Schritte statt die Zahl der Forward-Passes unter diesem Dekodierschrittbudget zu erhöhen.
Die Autoren testen vier Backbones (LLaDA-V-8B, LLaDA-O-8B, Dream-VL-7B, LaViDa-L-8B) auf Reasoning-, Halluzinations-, Mathe- und Wissenschaftsbenchmarks. Bei LLaDA-V-8B steigt der Reasoning-Durchschnitt um rund 2,8 Prozentpunkte gegenüber der Basis. MMHalu steigt von 3,35 auf 3,50 auf einer 0-6-Skala, Bingo von 2,71 auf 2,93 auf einer 1-5-Skala. Die im Paper gedruckten +2,5/+4,4 sind somit keine Rohscore-Punkte. Ein Vergleichsbefund braucht eine Einschränkung: Auf VMCBench liegt StepRefine mit 74,4 unter WINO mit 74,7, obwohl der Fließtext einen durchgängigen Gleichstand oder Sieg behauptet. Mit Fast-dLLM auf VStar bleibt der gemeldete Speedup gegenüber der unbeschleunigten LLaDA-V-Basis nahezu gleich (8,45x ohne, 8,47x mit StepRefine; 23,21 gegenüber 23,39 Token/s). Auf diesem Vergleich steigt VStar von 52,4 auf 56,5; MMHalu mit Fast-dLLM von 3,09 auf 3,22. Die Entropie-Analyse belegt eine Korrelation, keine alleinige Ursache von Halluzinationen. Wir haben die Experimente nicht selbst reproduziert.
Skalengesetze: Warum einfache Fits bei kleinen Budgets krumm werden
Klassische Skalengesetze beschreiben den Validierungsverlust als Potenzgesetz in Modellgröße und Datenvolumen. Tianyu Zhao und Zhixiang Ren (LingQiong AI Lab, Shanghai Smart Logic Technology) analysieren, warum empirische Lernkurven bei endlichen Budgets davon abweichen: Spektrale Modi, die mit unterschiedlichen Raten abklingen, und Domänen, die unterschiedlich schnell sättigen, verschieben den Engpass mit der Skala. Ihre Werkzeuge: eine dreigliedrige Mellin-Barnes-Entwicklung entlang der Kapazitätsachse, Aitken-Differenzierung zum Eliminieren des Verlust-Floors (weil das Fitten mehrerer Potenzgesetze auf engen Pilot-Gittern schlecht konditioniert ist), ein Wasserfüllungs-Ansatz für die Datenmischung über K Domänen und ein Schur-Komplement, das echten Drift des optimalen Allokations-Exponenten vom Bias eingefrorener Hyperparameter trennt.
Die Selbstauskunft zur Validierung: Auf 45 Operatoren-Spektren und drei öffentlichen Datenquellen erreichen die Schätzer 5,89 Prozent Holdout-MAPE auf Pythia-Standard (LAMBADA-Log-Perplexitätsverlust; 70M bis 12B; 10,22 Prozent auf dem Deduped-Split), senken den Allokations-Regret im Chinchilla-Archiv (245 Läufe) um 56,8 Prozent (Frontier-Maß) beziehungsweise 76,4 Prozent (Surface-Maß) und reduzieren den mittleren Domänen-RMSE auf einem 1M-Holdout um 59,4 Prozent gegenüber linearer Ridge-Regression. Dafür gibt es 17 Trainingsdomänen und 13 beobachtete Validierungsdomänen. Separat beträgt der Selektions-Regret im 64-Mischungen-Kandidatenpool bei 1B null. Praktisch relevant: Wer Pilotläufe für eine Extrapolation plant, sollte die Skalenspanne zwischen kleinstem und größtem Pilotmodell verbreitern statt mehr Checkpoints in dasselbe enge Intervall zu packen; die Autoren führen das auf Rangdefizite der Design-Matrix zurück. Grenzen: eine theoriegetriebene Einzelarbeit eines Labors, aufgebaut auf Annahmen (Resolventen-Näherung, lokale quadratische Reduktion), deren Ergebnisse wir nicht selbst reproduziert haben. Die Regret-Zahlen sind verschiedene Verfahren und Auswahlprotokolle: 56,8 % betreffen das getrimmte Potenzgesetz beim Frontier-Matching (0,0909 auf 0,0393 nats); 76,4 % den log-quadratischen Fit bei Surface-Auswahl (0,0289 auf 0,0068 nats). Die Verlustschwelle L <= 3,15 entfernt hochverlustige Pilotläufe. Das Archiv enthält keine Lernratenpläne; der Filter beweist deshalb keinen konkreten Hyperparameterfehler. Es sind retrospektive Kandidatenpool-Auswertungen, keine direkt gemessenen Trainingskosteneinsparungen.
Bits oder Reihenfolgen: Wohin mit dem Inferenzbudget?
Wer lokal arbeitet, kann Gewichte in weniger Bits speichern oder das Modell mehrfach mit umgeordneten Antwortoptionen fragen. Drei Intel-Forschende (Khan, L und Misri) messen beides gemeinsam an Qwen3-0.6B und Qwen3-1.7B mit simulierter Round-to-nearest-Gewichtsquantisierung (8, 6, 4 und 3 Bit, fp16-Referenz), gelesen aus den Logits der Buchstaben A bis D auf ARC-Easy, ARC-Challenge, MMLU und HellaSwag (je 300 Items, 1.200 pro Modell; paarweise Bootstrap-Intervalle, 95 Prozent). Ergebnis eins: Sechs Bit verlieren keine Genauigkeit und liegen sogar 1,8 beziehungsweise 0,9 Punkte über fp16; die Autoren erklären das nicht und behaupten keine Verbesserung. Acht Bit kosten 0,7 und 0,4 Punkte. Ergebnis zwei: Bei 4 Bit steigt die Bevorzugung eines Antwort-Slots von 0,15 auf 0,53 (0.6B) und von 0,07 auf 0,12 (1.7B); eine Kontrolle mit Gaußschem Rauschen gleicher Fehlerleistung (0,15 und 0,37 in zwei Durchgängen, 0,19 in einem) bleibt uneindeutig, ob das Runden selbst die Schieflage erzeugt.
Ergebnis drei: Das Mitteln über vier zyklische Reihenfolgen holt bei 4 Bit 12,6 Punkte zurück (0.6B; bei fp16 noch 5,3; 1.7B: 4,9 beziehungsweise 3,8). Als Währung dient gelesene Gewichts-Bytes mal Durchläufe. In zehn annähernd kostengematchten Paaren pro Modell gewinnen Extra-Reihenfolgen nur zweimal, jeweils wenn die sparsamere Zelle mindestens 6 Bit hat; mehr Bits gewinnen siebenmal. Die Genauigkeits-Kosten-Front beider Modelle besteht aus 6-Bit-Zellen mit ein bis vier Durchläufen plus den billigsten 3- und 4-Bit-Einzelpässen; die Entscheidungsregel der Autoren: 6-Bit-Gewichte und den Rest des Budgets in bis zu vier Reihenfolgen stecken, einen Durchlauf pro Reihenfolge. Grenzen benennt das Paper ausführlich: nur zwei kleine Modelle, der einfachste Quantisierer (bessere verlieren bei 3 und 4 Bit weniger), ein Prompt-Format, vier Benchmarks; Qwen3-4B fiel dem GPU-Speicher zum Opfer. Die Kostenwährung ist ausdrücklich ein vereinfachter Proxy, keine Zeit- oder Energie-Messung. Die Gewichte werden gerundet und wieder in fp16 berechnet; es laufen keine gepackten Low-Bit-Kernel. Embeddings und Ausgabematrix bleiben fp16. Wenn die ganze Matrix gelesen wird, steigt der angesetzte 6-Bit-Preis von 0,39 auf 0,55 beziehungsweise 0,50 fp16-Pässe (0.6B/1.7B). Aktivierungsverkehr, Dequantisierung, Batching und geteilte Präfixe fehlen ebenfalls. Die Schwellen und Empfehlung hängen also vom Proxy und diesem Testprotokoll ab.
Häufige Fragen
Was ist eine Entropie-Spitze beim Diffusions-Dekodieren?
Lokal stark steigende mittlere Unsicherheit über maskierte Positionen. In der Analyse von LLaDA-V und Dream-VL liegen rund 80 Prozent der Halluzinations-Token in diesen Regionen. StepRefine setzt dort latente Verfeinerung ein; zusätzliche Forward-Passes ersetzen spätere Dekodierschritte. Das ist keine allgemeine Garantie gleicher Kosten oder Zeit auf anderer Hardware.
Warum nicht einfach mehr Pilot-Checkpoints auf engem Raum fitten?
Nach der theoretischen Analyse sind Multi-Power-Fits auf engem Log-Intervall schlecht konditioniert. Die Autoren empfehlen eine größere Skalenspanne und Aitken-Differenzierung zur Elimination des Verlust-Floors. Mehr Checkpoints im selben engen Bereich lösen das Identifizierbarkeitsproblem nicht automatisch.
Lohnt sich Quantisierung unter 6 Bit für lokale Modelle?
Die Studie misst zwei kleine Qwen3-Modelle mit simuliertem Round-to-nearest und Buchstaben-Logits. Vier Orders bringen bei 4 Bit für 0.6B plus 12,6 Prozentpunkte. Unter dem vereinfachten Gewichtsbyte-Proxy empfehlen die Autoren meist 6 Bit plus bis zu vier Orders; bei sehr knappem Budget enthält die Front auch 3-/4-Bit-Einzelpässe. Das ist keine allgemeine Hardware-Empfehlung.
Quellen
- Rethinking in Spikes: Mitigating Hallucinations in MDLMs with Step-Aware Decoding (arXiv (Zhongxing Xu, Zhonghua Wang u.a.; Monash University, Cornell, UC Santa Cruz, Northeastern, University of Minnesota), abgerufen 2026-11-12)
- Beyond the Log-Linear Frontier: Pre-Asymptotic Analysis of Finite-Budget Neural Scaling Laws (arXiv (Tianyu Zhao, Zhixiang Ren; LingQiong AI Lab, Shanghai Smart Logic Technology), abgerufen 2026-11-12)
- Bits or permutations? Spending a fixed inference budget on weight precision or on option-order averaging in small local language models (arXiv (Mohammed Nayeem Khan, Logesh L, Aliyas Ahmad Misri; Intel Corporation), abgerufen 2026-11-12)
Weitere Artikel
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.