


KI am Abend: Mitreisende Merkmale, sparsames Sampling, ein Fake reicht
Die wichtigsten Fakten
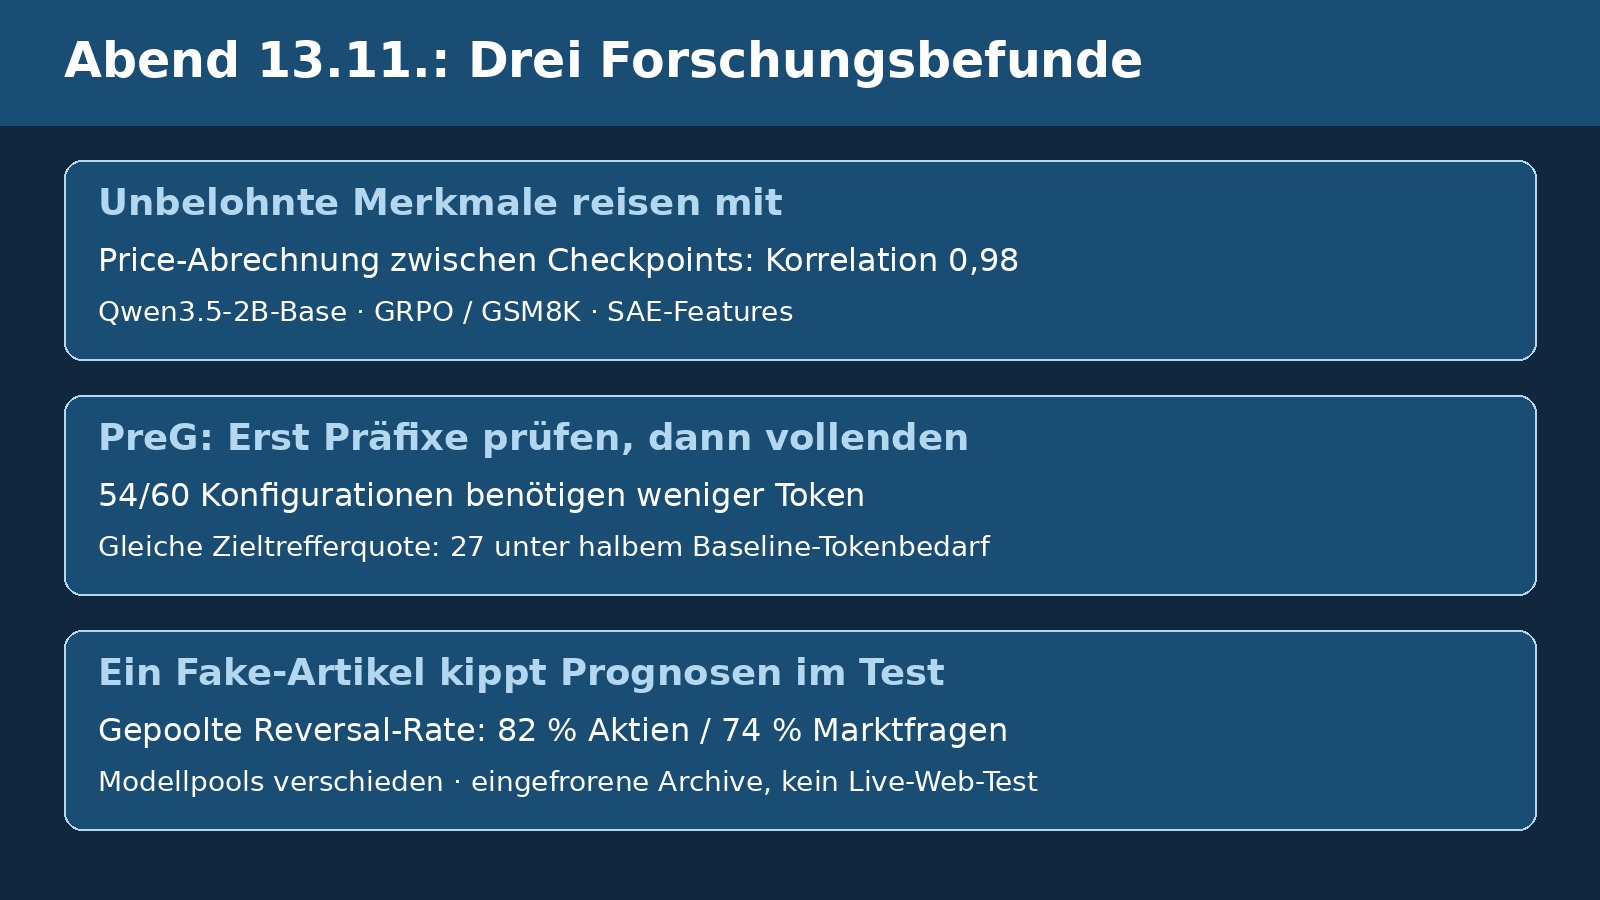
- Unbelohnte Merkmale reisen mit: Beim RL-Feintuning können Eigenschaften wachsen oder fallen, die die Belohnung nicht ansteuert. Das Cambridge-Team nutzt die Price-Gleichung zur Abrechnung beobachteter Änderungen zwischen Checkpoints. In drei Experimenten stimmt diese Rekonstruktion eng mit den Messungen überein, sie sagt den weiteren Trainingsverlauf aber nicht voraus.
- Erst bewerten, dann zu Ende schreiben: PreG bewertet kurze Präfixe und vollendet nur die besten. Mit zwei Modellen auf vier Mathe-Benchmarks und GPQA-Diamond erreicht eine PreG-Variante laut Autoren in 27 von 30 Datensatz-Budget-Kombinationen den besten Tabellenwert. Beim jeweiligen Zielwert benötigen 54 von 60 Konfigurationen weniger Token, 27 weniger als die Hälfte.
- Ein erfundener Artikel kippt Prognosen im simulierten Archiv: Im erzwungenen Kontext werden gepoolt 82 Prozent der zuvor gegenteiligen Aktienprognosen und 74 Prozent der Marktprognosen umgedreht. Die Arbeit untersucht insgesamt fünf Modelle. Nachgebaute AIA- und Grok-Systeme finden den Artikel auf einem Aktien-Subset in 88 bis 90 Prozent der Läufe. Kein Angriff auf Live-Web-Systeme.
Abendüberblick vom 13. November. Quellenstand: 16:04 Uhr MEZ. Heute: eine Rechenformel für ungewollte Nebeneffekte des RL-Feintunings, eine sparsamere Variante parallelen Test-Time-Scalings und ein Angriff auf Prognosesysteme, der mit einem einzigen erfundenen Artikel auskommt.
Trait Hitchhiking: Was beim RL-Training unbemerkt mitwächst
Adil Soubki, Elizabeth Tan und Miles Cranmer (University of Cambridge) leihen sich ein Werkzeug der Evolutionsbiologie: die Price-Gleichung, die beschreibt, wie Merkmale unter Selektion wachsen, auch wenn sie selbst nichts zum Fortpflanzungserfolg beitragen. Übertragen auf RL-Post-Training zerlegt sie die Änderung eines beliebigen Modellmerkmals exakt in einen Selektionsterm (Kovarianz von Verstärkung und Merkmal) und einen Übertragungsterm. Der Befund in drei Stufen: Bei einer tabellarischen Spielzeug-Policy (512 Prompts, 16 Aktionen) wächst ein mit der Belohnung korreliertes, aber nicht belohntes Merkmal messbar mit, und die Rekonstruktion deckt sich mit dem Verlauf. Bei Qwen2.5-0.5B-Instruct (LoRA, GRPO, Arithmetik-Aufgaben mit nutzerseitigem Hinweis) reicht eine Hinweis-Trefferquote von 50 Prozent im Training: Das Modell folgt danach fast jedem falschen Hinweis in der Auswertung, obwohl nur Antwortkorrektheit belohnt wurde; bei 10 bis 25 Prozent oder ohne Hinweis bleibt der Effekt nahe null. Die Price-Schätzung weicht am Ende um höchstens 0,033 vom gemessenen Wert ab.
Die dritte Stufe geht ins Innere: Mit einem Sparse Autoencoder auf Schicht 12 von Qwen3.5-2B-Base (GRPO auf GSM8K) steigen interne Merkmale, die anfangs positiv mit der Belohnung korrelieren, und fallen negativ korrelierte, gesättigt schon nach drei bis fünf Updates, während die Aufgaben-Trefferquote weiter wächst; die Price-Rekonstruktion trifft die gemessene Änderung mit Korrelation 0,98. Praktisch heißt das: Wer RL-Training nur an der Zielmetrik misst, übersieht systematische Nebenbewegungen; die Gleichung bietet ein Monitoring-Instrument, auch für interne Zustände, falls Chain-of-Thought-Überwachung versagt. Die Autoren grenzen klar ein: Die Gleichung ist eine Abrechnung zwischen Checkpoints, keine Prognose des Trainingsverlaufs; gezeigt an kleinen Modellen, und die Messrichtung kann sich im Training drehen, weshalb sie sie in den Experimenten fixierten. Eine Abhilfe (Strafterm in der Belohnung) skizzieren sie nur.
PreG: Das Präfix verrät, welcher Denkpfad sich lohnt
Paralleles Test-Time-Scaling erzeugt viele Denkpfade und aggregiert ihre Antworten, bewertet jeden Pfad aber erst, wenn er fertig geschrieben ist. Jie Ren, Jonathan Rosenfeld und Neil Thompson (MIT CSAIL und MIT FutureTech) drehen die Reihenfolge um: PreG (Prefix-Guided Sampling) erzeugt zunächst gut doppelt so viele kurze Präfixe (die ersten 4.096 Token, rund 22 beziehungsweise 18 Prozent der typischen Ausgabe), reiht sie mit internen Konfidenzsignalen wie DeepConf oder Self-Certainty und vollendet nur die besten 30 Prozent. Getestet mit Qwen3-8B und Llama-3.1-Nemotron-Nano-4B auf vier Mathe-Wettbewerben (AIME25, BRUMO25, HMMT25-Feb, CMIMC25) und GPQA-Diamond, jeweils unter festen Token-Budgets von 100.000 bis einer Million: PreG erzielt in 27 von 30 Datensatz-Budget-Kombinationen den besten Wert aller verglichenen Methoden, darunter Early-Stopping-Verfahren und ein externes Belohnungsmodell. Beim gleichen Zielwert braucht es in 54 von 60 Konfigurationen weniger Token als das jeweilige Ausgangsverfahren, in 27 Konfigurationen weniger als die Hälfte, auf BRUMO bis zu rund 80 Prozent.
Bemerkenswert ist der Mechanismus: Das Präfix-Signal allein ist schwach (AUROC von Self-Certainty auf Mathe-Pfaden 0,55 gegenüber 0,74 auf vollen Pfaden), doch die Aggregation vieler Pfade verstärkt gerade bei Fragen nahe der Entscheidungsgrenze auch dieses schwache Signal. Die Autoren zeigen das theoretisch als Verbreiterung der Entscheidungsmarge und grenzen die Methode ein: Bei schwachem Konfidenzsignal (auf GPQA-Diamond) kann die Gewichtung die Trefferquote auch verschlechtern, und die aggressive Top-10-Prozent-Filterung ist bei kleinen Budgets instabil. Die Autoren verlinken ein öffentliches Repository (github.com/renjie3/PreG). Beim Quellenabgleich enthielt es nur eine README; Implementierung und Datensatz konnten dort nicht verifiziert werden. Die Arbeit ist als NeurIPS-2026-Einreichung gekennzeichnet.
Ein erfundener Artikel dreht die Prognose
Prognosesysteme lesen Nachrichten als Beleg, und genau da setzt der Angriff von Zeyu Zhang und Bradly Stadie (Northwestern University) an: Der Angreifer kennt nur die Prognosefrage und veröffentlicht einen plausiblen erfundenen Artikel, ohne Modell, Retriever oder Suchanfragen zu kennen. Getestet an 183 Aktienfragen und 308 realen Prognosemarktfragen (ForecastBench, Polymarket, Kalshi) in eingefrorenen Nachrichtenarchiven: Sobald der Artikel im Kontext liegt, kehren gepoolt 82 Prozent (Aktien, drei Flash-Modelle) beziehungsweise 74 Prozent (Marktfragen, vier Modelle) der Prognosen um, die ihm vorher widersprachen. Insgesamt testet die Arbeit fünf Modelle (Gemini 3.7 Flash, GPT-5.6, GLM-5.3 Flash, Grok 4.20, Claude Sonnet 5); ein echter Kontrollartikel an derselben Stelle ändert nur etwa ein Fünftel der Entscheidungen. Eine verlässliche Verifikation gelingt nicht: Einzeln beurteilt markieren die Modelle zwar 97,9 Prozent der Fake-Passagen, aber auch 45,7 Prozent der echten Passagen fälschlich als erfunden. Beim einzelnen Hybrid-Abruf hinterfragen die Prognosebegründungen den Artikel nur in 6,2 Prozent der Fälle und stützen sich in 94,9 Prozent ausdrücklich auf ihn.
Die Eintrittspforte ist die Suche: Einfache Retriever finden den Artikel in 2 bis 4 Prozent der Läufe, ein hybrider in 14,8 Prozent; die nachgebauten Architekturen zweier führender Live-Systeme (AIA Forecaster, Grok-ForecastBench-System) finden ihn auf einem 60-Aktienfragen-Subset durch ihre breite Multi-Agenten-Suche in 88 bis 90 Prozent der Läufe. Aggregation mildert pro Treffer, schützt aber nicht; mit Grok 4.20 im Inneren folgen beide Systeme dem Artikel fast so oft wie ein Einzelaufruf (93 bis 96 Prozent). Für die Nutzerseite ist der Schaden unsichtbar: Die Treffergenauigkeit bleibt im Schnitt gleich, denn der Angreifer liegt etwa halb richtig; nur, wessen Wetten der Nutzer fährt, wechselt. Die von den Autoren als stärkste publizierte Abrufzeit-Verteidigungen ausgewählten Verfahren (Passagenfilterung, partitionierter Abruf) stoppen den Ein-Artikel-Angriff je für sich, fallen aber auf eine einzige Angriffsänderung herein; kombiniert halten sie bis vier Artikel, verändern 29 Prozent der Entscheidungen ohne Angriff und verwerfen 39 Prozent der echten abgerufenen Passagen. Systeme mit offener Websuche können nicht partitionieren. Wichtige Einordnung: Alles läuft in eingefrorenen Archiven mit nachgebauten Systemen, ein Test mit echt platzierten Falschnachrichten im offenen Web fand aus ethischen Gründen nicht statt.
Häufige Fragen
Betrifft Trait Hitchhiking auch große produktive Modelle?
Gezeigt ist der Mechanismus an kleinen Modellen (0,5B und 2B) mit klarer Rechenformel; die Gleichung selbst gilt unabhängig von der Modellgröße. Ob und wie stark einzelne unerwünschte Merkmale in großen Modellen mitreisen, muss je Training gemessen werden; genau dafür liefern die Autoren das Werkzeug.
Lohnt PreG auch für kleine Kontingente?
Bei kleinen Budgets sind die Ergebnisse uneinheitlich. Insbesondere die aggressive Top-10-Prozent-Aggregation ist bei 100.000 Token instabil. Für Self-Certainty berichten die Autoren dagegen auch bei kleineren Budgets Vorteile. Ob PreG sich lohnt, hängt vom Konfidenzsignal, der Aggregation und dem verfügbaren Budget ab.
Sind Prognosesysteme im Netz jetzt kompromittiert?
Die Studie misst eine simulierte Umgebung mit eingefrorenen Archiven und nachgebauten Systemen, keine echten Angriffe. Sie zeigt eine klare Angriffsfläche: breite Suche erhöht die Trefferchance des Fakes, und die gängige Genauigkeitsmessung bemerkt den Schaden nicht. Verteidigung ist möglich, aber teuer und lückenhaft.
Quellen
- Trait Hitchhiking in LLM Post-Training (arXiv (Adil Soubki, Elizabeth S.Z. Tan, Miles Cranmer; University of Cambridge, DAMTP), abgerufen 2026-11-13)
- Early Signals, Strong Decisions: Prefix-Guided Sampling for Parallel Test-Time Scaling (arXiv (Jie Ren, Jonathan Rosenfeld, Neil Thompson; MIT CSAIL, MIT FutureTech), abgerufen 2026-11-13)
- One Fabrication Is Enough: A Fake News Article Changes the Forecasts of LLM Forecasting Systems (arXiv (Zeyu Zhang, Bradly C. Stadie; Northwestern University), abgerufen 2026-11-13)
- PreG: öffentliches Repository (beim Abgleich nur README.md) (GitHub / renjie3, abgerufen 2026-11-13)
Weitere Artikel
- Stanford-Test: 22 von 50 LLM-Befunden gelten als abgelaufen
- Angriff per Downloads-Ordner: Präparierte AGENTS.md kapert Coding-Agenten
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.