


KI am Mittag: Wie OpenAI seine Modelle von innen überwacht
Die wichtigsten Fakten
- OpenAI überwacht seine stärksten Modelle zusätzlich mit Sonden, die die inneren Aktivierungen während der Antwort Token für Token prüfen und im Verdachtsfall stoppen. Alle Ergebnisse stammen aus OpenAIs eigenem Blog; die gezeigten Diagramme sind nach OpenAIs Hinweis nicht unbedingt repräsentativ für die produktiven Sonden.
- Anthropics Message Threads (öffentliche Beta) ersparen Agenten das erneute Hochladen der gesamten Unterhaltung; bei 500.000 bis 1 Million Tokens sinkt die Zeit bis zur ersten Antwort laut Anthropic im Median um etwa 35 Prozent.
- Weil Codex so viele Code-Änderungen erzeugt, hat OpenAI mit Pando einen eigenen Git-Nachbau für sein Monorepo in Betrieb genommen; die mittlere Push-Latenz sank laut OpenAI um fast das Fünffache.
Mittagsüberblick vom 3. November 2026. Quellenstand: 09:50 Uhr MEZ. Drei Blicke hinter die Kulissen zum Mittag: OpenAI erklärt, wie es seine stärksten Modelle von innen überwacht, Anthropic macht lang laufende Claude-Agenten schneller, und OpenAI musste wegen seiner Codex-Agenten den eigenen Code-Speicher neu bauen.
OpenAI liest beim Schutz im Modell mit
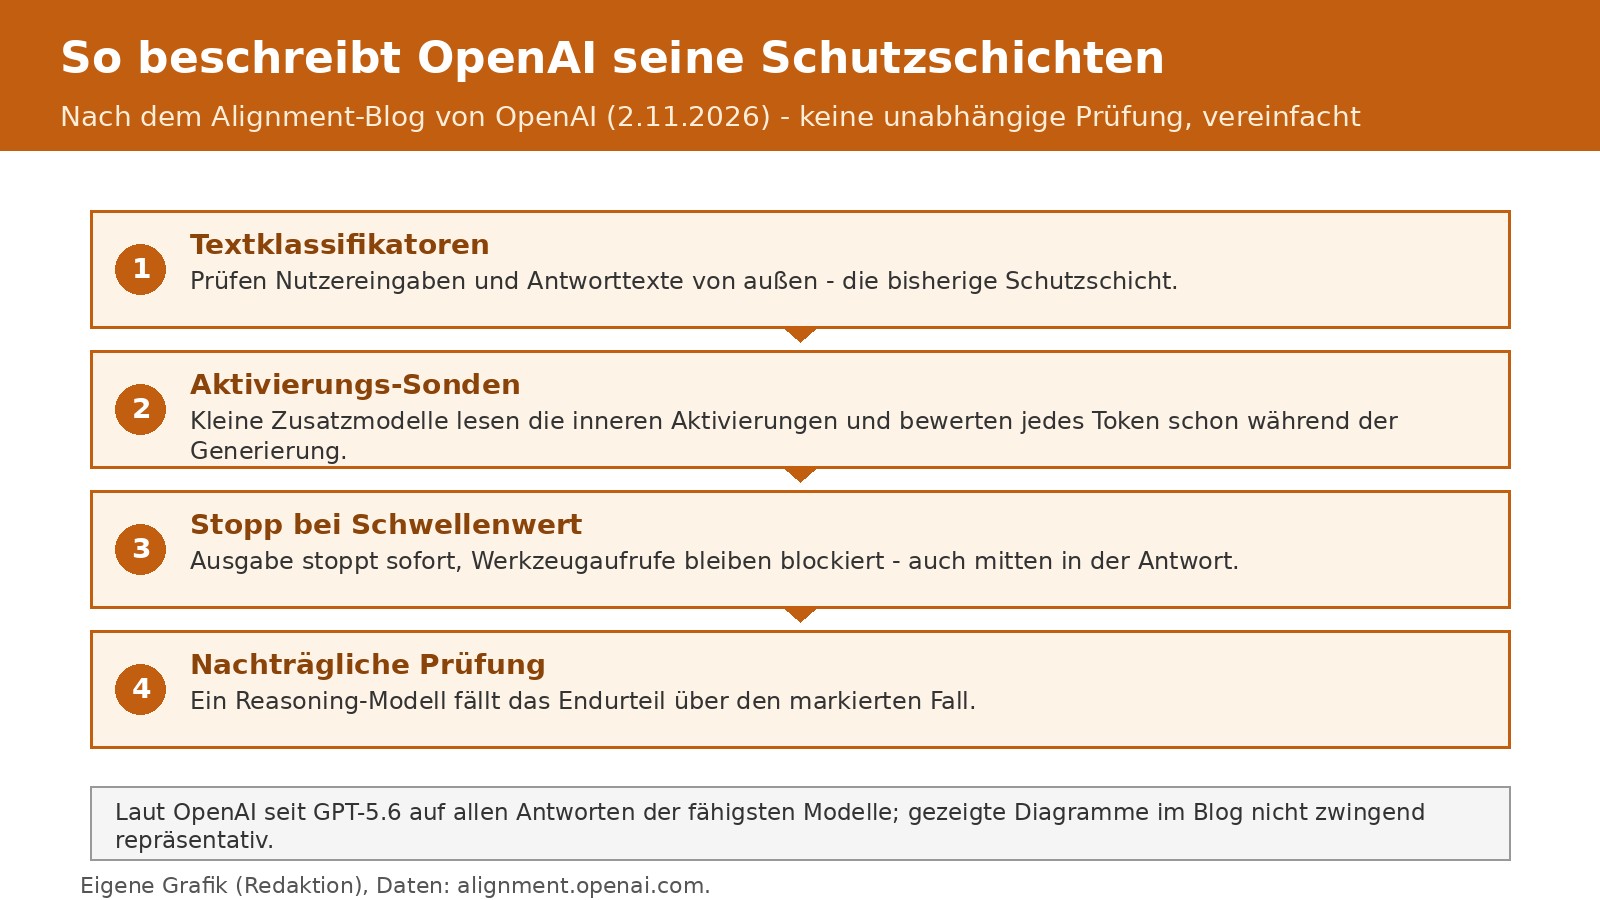
OpenAI hat am 2. November beschrieben, wie sogenannte Aktivierungs-Klassifikatoren ("Probes", also Sonden) als zusätzliche Schutzschicht in seinen stärksten Modellen laufen. Statt nur den fertigen Text zu prüfen, werten die kleinen Zusatzmodelle die inneren Aktivierungen des Sprachmodells aus - Token für Token, schon während die Antwort entsteht. Überschreitet der Sonden-Wert eine Schwelle, stoppt die Ausgabe sofort, Werkzeugaufrufe bleiben blockiert, und ein Reasoning-Modell prüft den Fall nach. Seit GPT-5.6 laufen die Sonden laut OpenAI auf allen Antworten der fähigsten Modelle, intern wie extern.
Laut dem Beitrag halten die Sonden getestete Umgehungsversuche (Jailbreaks) besser aus als deutlich größere Textklassifikatoren, sie werden mit der Fähigkeit des überwachten Modells besser und lassen sich über viele Trainingsschritte hinweg weiterverwenden. Die Grenzen nennt OpenAI selbst: Die Sonden finden nur, wofür sie trainiert wurden, und müssen für jedes neue Basismodell neu trainiert werden. Wichtig zur Einordnung: Alle Angaben stammen aus OpenAIs eigenem Blog, und die gezeigten Diagramme sind nach OpenAIs ausdrücklichem Hinweis nicht unbedingt repräsentativ für die tatsächlich eingesetzten Sonden. Eine unabhängige Prüfung gibt es nicht.
Claude-Agenten müssen weniger mitschleppen
Anthropic hat am 2. November Message Threads in die öffentliche Beta geschickt. Bislang schickt ein Agent bei jeder Anfrage die komplette bisherige Unterhaltung erneut mit - bei langen Sitzungen mit Hunderttausenden Tokens kostet das spürbar Zeit. Mit Threads schickt der Agent nur noch die neuen Nachrichten plus die Kennung der letzten Antwort. Laut Anthropic sinkt die Zeit bis zum ersten Antwort-Token bei Anfragen mit 500.000 bis 1 Million Tokens im Median um etwa 35 Prozent; für die meisten Claude-Code-Nutzer ist die Funktion demnach schon standardmäßig aktiv.
Technische Rahmung laut Anthropic: Der Thread liegt verschlüsselt nur im Arbeitsspeicher, wird nicht auf Festplatte geschrieben und läuft fünf Minuten nach der letzten Anfrage ab - danach beginnt ein neuer Thread mit der vollen Unterhaltung. Die Token-Kosten bleiben gleich, weil Claude intern weiterhin die gesamte Unterhaltung liest. Verfügbar ist die Beta auf der Claude-Plattform sowie bei AWS, Microsoft Foundry und Google Cloud (jeweils Anthropic-verwaltet). Angaben des Anbieters, keine unabhängige Messung.
OpenAIs Code-Speicher war am Limit
Und ein dritter Blick hinter die Kulissen: Weil Codex-Agenten die Entwicklung bei OpenAI massiv parallelisiert haben, kam das Firmen-Monorepo zeitweise unter 90 Prozent Zuverlässigkeit. OpenAI baute daraufhin mit Pando einen eigenen Git-kompatiblen Speicher, der Schreibvorgänge auf vielen Branches parallel verarbeitet und Downloads so schnell ausliefert, dass die Netzwerkanbindung der Clients der Flaschenhals wird. In Produktion sank die mittlere Push-Latenz laut OpenAI um fast das Fünffache; Pando liefert inzwischen fast ein Petabyte Git-Daten pro Tag und trägt die gesamte Entwicklung im Monorepo. Client und Protokoll bleiben gewöhnliches Git, Verbesserungen am Client will OpenAI an das Git-Projekt zurückgeben. Auch hier gilt: Angaben aus dem OpenAI-Blog ohne Fremdprüfung.
Häufige Fragen
Liest OpenAI bei mir mit?
Die beschriebenen Sonden werten laut OpenAI die internen Aktivierungen der Modelle aus, nicht Menschen. Sie laufen auf Antworten der fähigsten Modelle und sollen Regelverstöße stoppen. Details kommen ausschließlich aus OpenAIs Blog; eine unabhängige Prüfung des Einsatzes gibt es nicht.
Was bringt mir Message Threads als Nutzer?
Agenten-Anwendungen mit langen Sitzungen - etwa Coding-Assistenten - reagieren laut Anthropic schneller, weil nicht mehr die ganze Unterhaltung erneut hochgeladen wird. An den Token-Kosten ändert sich nichts.
Kann ich Pando selbst nutzen?
Nein, Pando ist OpenAI-interne Infrastruktur und nicht als Produkt angekündigt. OpenAI sagt lediglich zu, Verbesserungen am Git-Client an das Open-Source-Projekt zurückzugeben.
Quellen
- Training activation classifiers for safety and alignment (OpenAI (Alignment-Blog), abgerufen 2026-11-03)
- Make long-running agents faster with message threads (Anthropic (Claude), abgerufen 2026-11-03)
- Anthropic Launches Message Threads Beta for Long-Running Agents (unite.ai, abgerufen 2026-11-03)
- Scaling Git at OpenAI (OpenAI, abgerufen 2026-11-03)
- OpenAI built itself a new Git backend, too (The New Stack, abgerufen 2026-11-03)
Weitere Artikel
- CEO berichtet: Claude-Agent wählte Gentherapie und führte Teilschritte einer Operation am Maus-Gehirn aus
- Walmart öffnet sich für Shopping-Agenten, mit festen Regeln
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.