


KI am Mittag: Entscheiden statt antworten
Die wichtigsten Fakten
- Ling-3.2-flash von Ant Group versteht laut Anbieter nativ Bild, Text und Video bei einer Million Token Kontext - vorerst nur über die hauseigene Plattform, offene Gewichte haben wir nicht gefunden.
- Kakaos Kanana-2-v-decide generiert keinen Text: Das Modell mit offenen Gewichten und 3,67B Parametern beantwortet Auswahl-, Ja/Nein- und Bewertungsfragen mit Wahrscheinlichkeiten, für bestimmte Angebote an Dritte ist eine gesonderte kommerzielle Lizenz nötig.
- Tencents WeLM-Image (31,7B) führt Bildverstehen und -erzeugung in einem Modell zusammen; in den geprüften Quellen fanden wir den technischen Bericht, aber keinen Verweis auf veröffentlichte Gewichte.
Mittagsüberblick vom 6. November 2026. Quellenstand: 10:00 Uhr MEZ. Drei Wege, ein Thema: Multimodalität. Ant Group rüstet sein Spitzenmodell mit Bild- und Video-Verstehen auf, Kakao veröffentlicht ein kleines Modell, das Entscheidungen statt Sätze liefert, und Tencent beschreibt ein Bildmodell in einem technischen Bericht.
Ling-3.2-flash: Ant Groups Spitzenmodell lernt sehen
Ant Group hat laut Changelog seiner Entwicklerplattform am 5. November Ling-3.2-flash gestartet: 560 Milliarden Parameter, davon 25 Milliarden aktiv, ein Kontextfenster von einer Million Token und laut Anbieter natives Verständnis für Bild, Text und Video. Der Anbieter nennt vier Schwerpunkte: komplexes visuelles Verstehen, mehrstufige Agenten-Aufgaben über längere Strecken, 3D-Verständnis und medizinische Multimodal-Aufgaben. Nutzbar ist das Modell über den Chat und eine Programmierschnittstelle, die zu OpenAI- und Anthropic-Clients kompatibel sein soll.
Bemerkenswert ist der Unterschied zum Vorgänger: Ling-3.1-flash ist mit offenen Gewichten auf Hugging Face verfügbar. Für Ling-3.2-flash haben wir dort bis zum Quellenstand keine Gewichte gefunden - das neue Modell ist vorerst ein reiner Plattform-Dienst.
Kanana-2-v-decide: Kakaos Modell antwortet mit Wahrscheinlichkeiten
Kakao hat die Gewichte von Kanana-2-v-decide-3b-2611 auf Hugging Face veröffentlicht (Freigabe laut Karte am 6. November). Das 3,7-Milliarden-Parameter-Modell ist kein Gesprächsmodell: Es beantwortet typisierte Fragen - Auswahl zwischen Optionen, Ja/Nein oder eine Bewertungsskala - und liefert für jede Antwort eine Wahrscheinlichkeit. Bis zu zehn Bilder und 20.480 Token versteht es als Eingabe. Die Idee: KI-Agenten brauchen für den nächsten Schritt oft nur eine schnelle, kalibrierte Entscheidung, keinen formulierten Absatz.
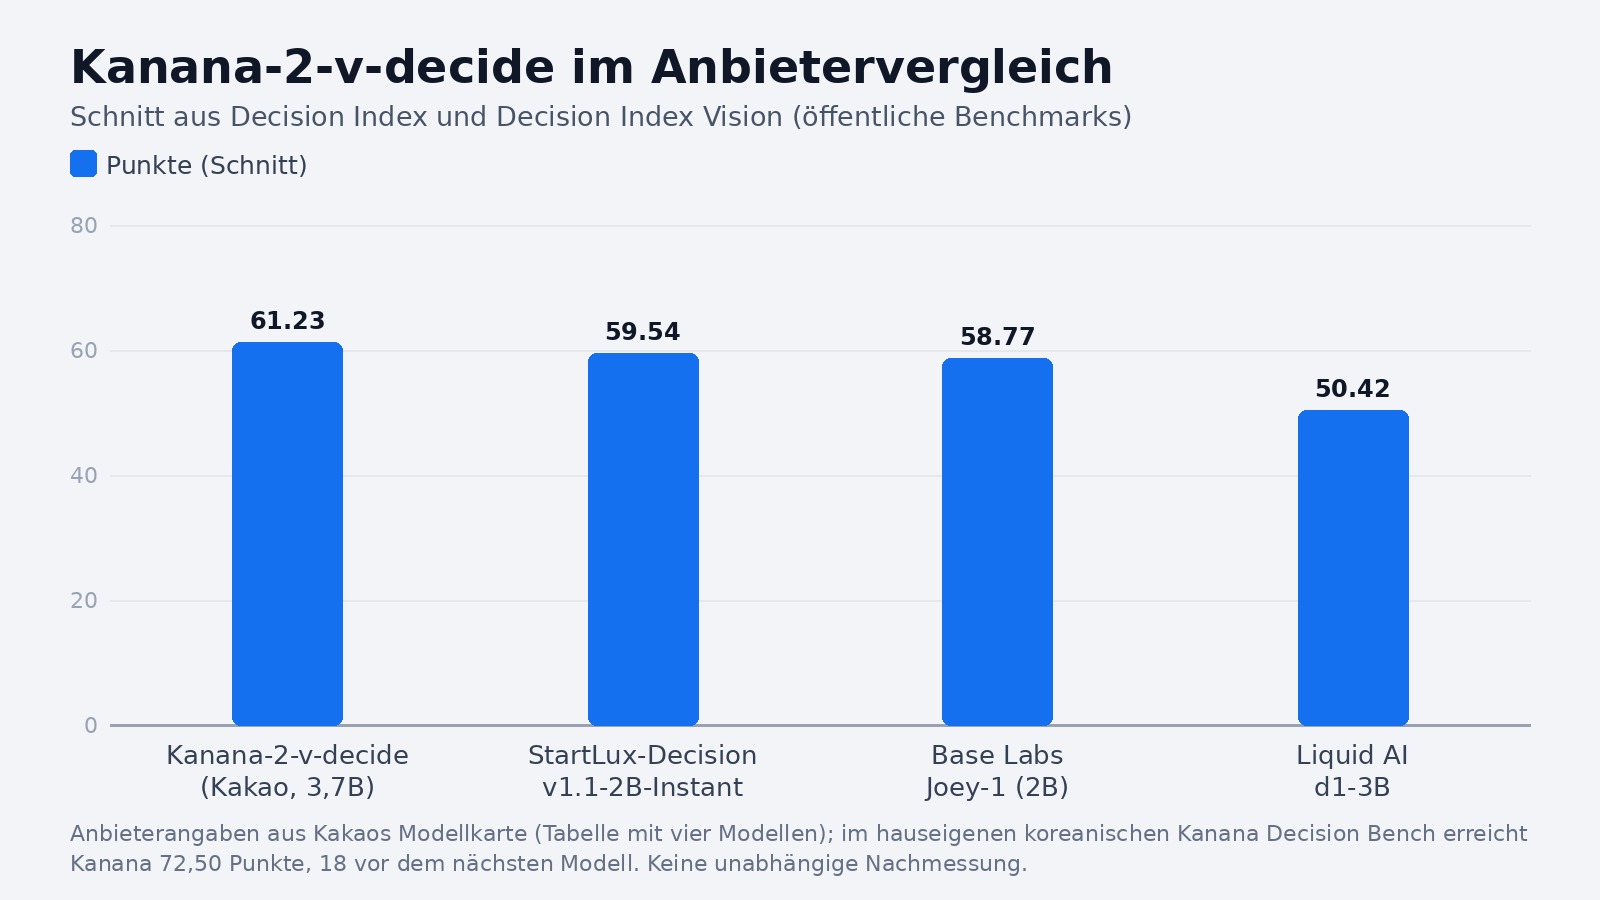
In Kakaos Vergleichstabelle liegt das Modell im Schnitt zweier öffentlicher Entscheidungs-Benchmarks vorn (61,23 Punkte) und im hauseigenen koreanischen Test 18 Punkte vor dem nächsten Vergleichsmodell. Wichtig ist die Lizenz: Nach Abschnitt 4.1 der Kanana Open License brauchen Angebote an Dritte über API, Cloud oder andere Fernzugriffe sowie Angebote als SI-/On-Premise-Lösung oder eingebettet auf Geräten eine gesonderte kommerzielle Lizenz. Eigene Dienste sind nach Abschnitt 4.2 ohne diese Lizenz erlaubt, soweit sie nicht unter 4.1 fallen. Bei Weiterverteilung gelten unter anderem die Kennzeichnung "Powered by Kanana" und, für mit dem Modell oder seinen Outputs trainierte und verbreitete Modelle, ein Kanana-Präfix. Offene Gewichte bedeuten hier keine uneingeschränkte Nutzung.
WeLM-Image: Tencents Bildmodell im technischen Bericht
Das WeChat-Vision-Team von Tencent beschreibt in einem technischen Bericht (arXiv, 5. November) WeLM-Image: ein einheitliches Bildmodell, das Text- und Bildverstehen, Bilderzeugung, Anleitungs-Bearbeitung und Mehrfach-Referenzen in einer Architektur verbindet. 31,7 Milliarden gespeicherte Parameter, rund 5,4 Milliarden davon aktiv pro Bild-Token, getrennte Verstehens- und Erzeugungspfade (Mixture of Transformers) und native Auflösung bis 1,5K. In den im Papier berichteten Vergleichen liegt die 1536er-Auflösung bei drei Bild-Benchmarks vorn - unter den getesteten quelloffenen Modellen, so die Autoren. Eine Turbo-Variante soll ein 1024er-Bild in 4,98 Sekunden auf einer einzelnen H20-GPU erzeugen.
In den hier geprüften Anbieterquellen fanden wir den technischen Bericht, aber keinen Verweis auf veröffentlichte Gewichte oder Code. Entworfen ist WeLM-Image laut Bericht für den Ein-GPU-Betrieb in WeChats Verbraucher-Anwendungen bei hohen Anfragezahlen.
Häufige Fragen
Kann ich Ling-3.2-flash schon selbst hosten?
Ant Group beschreibt den Zugang über Chat und API. In den hier geprüften Anbieterquellen fanden wir keinen Verweis auf herunterladbare Gewichte für 3.2-flash. Beim Vorgänger 3.1-flash sind Gewichte auf Hugging Face verfügbar.
Wozu brauche ich ein Entscheidungsmodell ohne Textausgabe?
Überall dort, wo ein Agent oder Dienst nur eine Auswahl, ein Ja/Nein oder eine Bewertung braucht: Kundenanfragen sortieren, das nächste Werkzeug wählen, Produktfotos bewerten. Kakaos Modell liefert dafür direkt Wahrscheinlichkeiten, aus denen Software sofort weiterarbeiten kann - ohne Text zu zerlegen.
Ist WeLM-Image jetzt Open Source?
In den hier geprüften Quellen fanden wir keinen Verweis auf veröffentlichte Gewichte oder Code. Der technische Bericht allein belegt keine Open-Source-Veröffentlichung.
Quellen
- Ant Ling Plattform: Changelog (Launch Ling-3.2-flash, 5.11.) (Ant Group, abgerufen 2026-11-06)
- Ant Ling Plattform: Models / Ling (Ant Group, abgerufen 2026-11-06)
- kakaocorp/kanana-2-v-decide-3b-2611 (Modellkarte) (Kakao / Hugging Face, abgerufen 2026-11-06)
- Kanana Open License Agreement (Lizenztext) (Kakao / Hugging Face, abgerufen 2026-11-06)
- WeLM-Image: A Unified Image Generation Model towards Visual Intelligence (arXiv 2611.07392) (Tencent WeChat Vision / arXiv, abgerufen 2026-11-06)
- Ling-3.1-flash: Vorgänger mit verfügbaren Gewichten (inclusionAI / Hugging Face, abgerufen 2026-11-06)
- WeLM-Image: Volltext, Architektur und Parameterzählung (Tencent / arXiv, abgerufen 2026-11-06)
Weitere Artikel
- Muse Spark Open: Meta öffnet sein stärkstes Modell (816B)
- Kling 4.0: 30 Sekunden Video am Stück und 15 Referenzen
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.