


KI am Mittag: Nvidias Cluster-Baukasten
Die wichtigsten Fakten
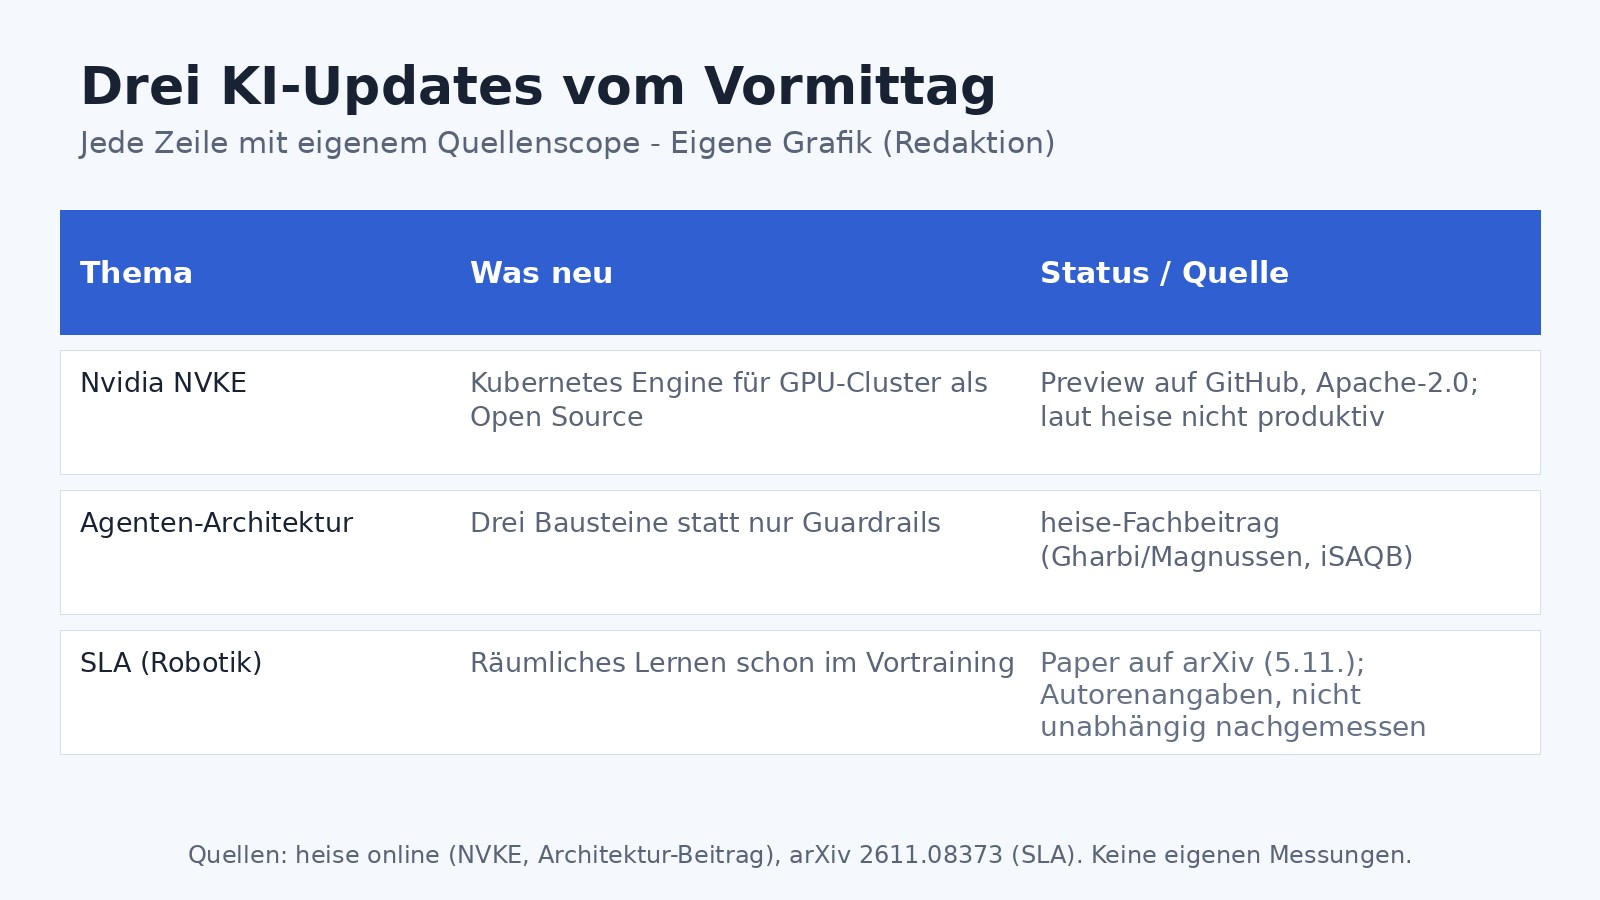
- Nvidia stellt mit NVKE eine Kubernetes-Engine für GPU-Rechenzentren als Preview auf GitHub bereit - Apache-2.0-lizenziert, aber laut heise noch nicht für den Produktivbetrieb empfohlen.
- Ein heise-Fachbeitrag zweier iSAQB-Architektur-Experten empfiehlt, kritische Agenten-Handlungen technisch unmöglich zu machen - statt nur Guardrails zu verschärfen.
- Das Robotik-Modell SLA soll laut Paper räumliches Verständnis schon im Vortraining lernen; in acht realen Testszenarien melden die Autoren 24 Prozentpunkte höhere Erfolgsraten als das Ausgangsmodell.
Mittagsüberblick vom 7. November 2026. Quellenstand: 09:52 Uhr MEZ. Heute: Nvidia legt einen Open-Source-Baukasten für GPU-Cluster vor, zwei Architektur-Experten erklären, warum Leitplanken allein KI-Agenten nicht zähmen, und ein neues Robotik-Modell will räumliches Verständnis von Anfang an mitlernen.
NVKE: Nvidias Kubernetes-Engine als Preview
Nvidia hat seine Kubernetes Engine NVKE als Preview auf GitHub vorgestellt, berichtet heise online. Betreiber eigener GPU-Rechenzentren können ihren Kunden damit Kubernetes als Managed Service anbieten - ähnlich wie AWS mit EKS. Ein zentraler Management-Cluster legt dem Bericht zufolge auf Anfrage isolierte Cluster auf Bare-Metal-Servern an, jeder mit eigener Control Plane, eigenem etcd und eigenen Node-Pools; Skalierung und Kubernetes-Upgrades laufen über die NVKE-API oder das Werkzeug nvkectl. Der Code steht unter Apache-2.0, doch Nvidia empfiehlt NVKE laut heise noch nicht für den Produktivbetrieb.
Der Bericht listet auch die offenen Baustellen: Laut NVIDIA-Dokumentation ist die API nach der Installation unverschlüsselt per HTTP erreichbar, und die Authentifizierung ist zunächst ausgeschaltet. Betreiber müssen den Zugriff absichern, etwa über einen eigenen TLS-Endpunkt und aktivierte JWT-Authentifizierung. Auch nach aktivierter Authentifizierung fehlt eine Autorisierung: Jeder zugelassene Aufrufer darf alle Workload-Cluster anlegen und löschen. Auch ein Upgrade-Verfahren für NVKE selbst und Backup- und Restore-Funktionen fehlen in der Preview noch. GPU-Treiber und zugehörige Software installiert separat Nvidias GPU Operator.
Agenten im Backoffice: Architektur statt nur Leitplanken
Wie lassen sich KI-Agenten sicher in Buchhaltung, Einkauf und Lieferantenmanagement einbinden? Ein Fachbeitrag auf heise online von Mahbouba Gharbi und Sönke Magnussen - beide kuratieren iSAQB-Module zu KI-Softwarearchitektur - gibt eine klare Antwort: nicht über strengere Guardrails allein. Mit Guardrails meinen sie hier kontextbasierte Verhaltensregeln; programmierte Kontrollen ordnen sie der algorithmischen Ausführung zu. Solche Regeln im Prompt würden vom Modell nur interpretiert und ließen sich durch widersprüchliche oder manipulierte Eingaben aushöhlen, schreiben die Autoren. Als besonders relevant für Backoffice-Szenarien nennen sie vier OWASP-Risiken: Prompt Injection, überzogene Handlungsvollmachten (Excessive Agency), das Umlenken übergeordneter Ziele (Agent Goal Hijack) und das Vergiften des Langzeitgedächtnisses (Memory Poisoning).
Der Beitrag empfiehlt stattdessen ein Designprinzip: Informationen, die ein Agent verarbeiten darf, strikt von seinen Handlungsmöglichkeiten trennen. Daraus leiten die Autoren drei Bausteine ab: erstens algorithmische Ausführung - das Sprachmodell interpretiert nur, ein deterministischer Planungsalgorithmus entscheidet und handelt; zweitens Human-in-the-Loop mit Freigabe-Gates und änderbaren, noch ausstehenden Kommandos; drittens Risikobeherrschung durch kontrollierten Kontext, Prüfung über unabhängige Kanäle und minimale Rechte. Kritische Fehler lägen ihrer Analyse zufolge selten an schlechten Guardrails, sondern am Systemdesign selbst.
SLA: Robotermodell lernt Räume schon im Vortraining
Ein Forschungsteam um Fuhao Li und Wenxuan Song stellt auf arXiv SLA vor, ein Spatial-Language-Action Model für Roboter. Übliche Vision-Language-Action-Modelle (VLA) erben ihre Bildrepräsentationen dem Paper zufolge aus 2D-Vortraining; räumliches Verständnis kommt oft erst beim Nachtraining dazu. SLA richtet die Ausrichtung auf räumliche Merkmale dagegen schon im kontinuierlichen Vortraining ein: Ausgehend von einer vortrainierten pi0.5-Policy gleicht das Modell seine visuellen Zwischenrepräsentationen an die eines eingefrorenen 3D-Wahrnehmungsmodells an. Die Zusatzbausteine kommen dem Paper zufolge nur im Training zum Einsatz. SLA startet aus den vortrainierten Gewichten; diese werden weitertrainiert, die ursprüngliche Inferenzarchitektur bleibt erhalten.
Die gemeldeten Ergebnisse: 87,4 Prozent Erfolgsrate auf LIBERO-Plus unter verschiedenen Störungen, 72,3 Prozent auf RoboTwin 2.0 (Clean2Random) und in acht realen Einsatzszenarien durchschnittlich 24,0 Prozentpunkte mehr Erfolg als die pi0.5-Ausgangsbasis. Alle Zahlen stammen von den Autoren und sind nicht unabhängig geprüft.
Häufige Fragen
Ist NVKE schon produktiv einsetzbar?
NVIDIA empfiehlt die Preview nicht für den Produktivbetrieb. Nach Installation fehlen TLS und aktivierte Authentifizierung; Betreiber müssen den Zugriff absichern. Auch nach aktivierter Authentifizierung fehlt die Autorisierung. Hinzu kommen fehlende Upgrade- und Backup-Verfahren für die Management-Ebene.
Warum reichen Guardrails laut dem heise-Beitrag nicht aus?
Der heise-Beitrag definiert Guardrails hier als kontextbasierte Regeln im Kontext des Sprachmodells - das Modell interpretiert sie nur, erzwingen kann es sie nicht. Die Autoren empfehlen deshalb eine Architektur, bei der kritische Handlungen technisch gar nicht ausführbar sind, etwa über deterministische Abläufe oder menschliche Freigaben.
Was ist an SLA neu?
Laut Paper lernt SLA räumliche Ausrichtung bereits im kontinuierlichen Vortraining statt erst beim Nachtraining. Die Zusatzkomponenten fallen für die Inferenz weg. Vortrainierte Gewichte dienen als Startpunkt und werden weitertrainiert; die Inferenzarchitektur bleibt erhalten. Die gemeldeten Verbesserungen sind Autorenangaben ohne unabhängige Prüfung.
Quellen
- NVKE: Nvidia bringt eigene Kubernetes Engine als Preview (heise online (iX, Kornelius Kindermann), abgerufen 2026-11-07)
- NVKE: Preview status and known limitations (NVIDIA-Dokumentation, abgerufen 2026-11-07)
- Sichere Architektur für KI-Agenten im Backoffice (heise online (Developer, Mahbouba Gharbi, Sönke J. Magnussen), abgerufen 2026-11-07)
- SLA: Scaling Spatial-Language-Action Model via Continual Pre-training (arXiv (Fuhao Li, Wenxuan Song u. a.), abgerufen 2026-11-07)
- NVKE: What is NVKE (NVIDIA, dsx-ai-factory (GitHub), abgerufen 2026-11-07)
Weitere Artikel
- Anthropic-Experiment: Claude-Agenten schreiben Trainingsdaten, die den Sicherheitsmonitor austricksen
- Eigener LLM-Proxy: Wer seine KI-Nutzung nicht misst, rätselt nur
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.