


KI am Mittag: Zuhören, suchen, verteilen
Die wichtigsten Fakten
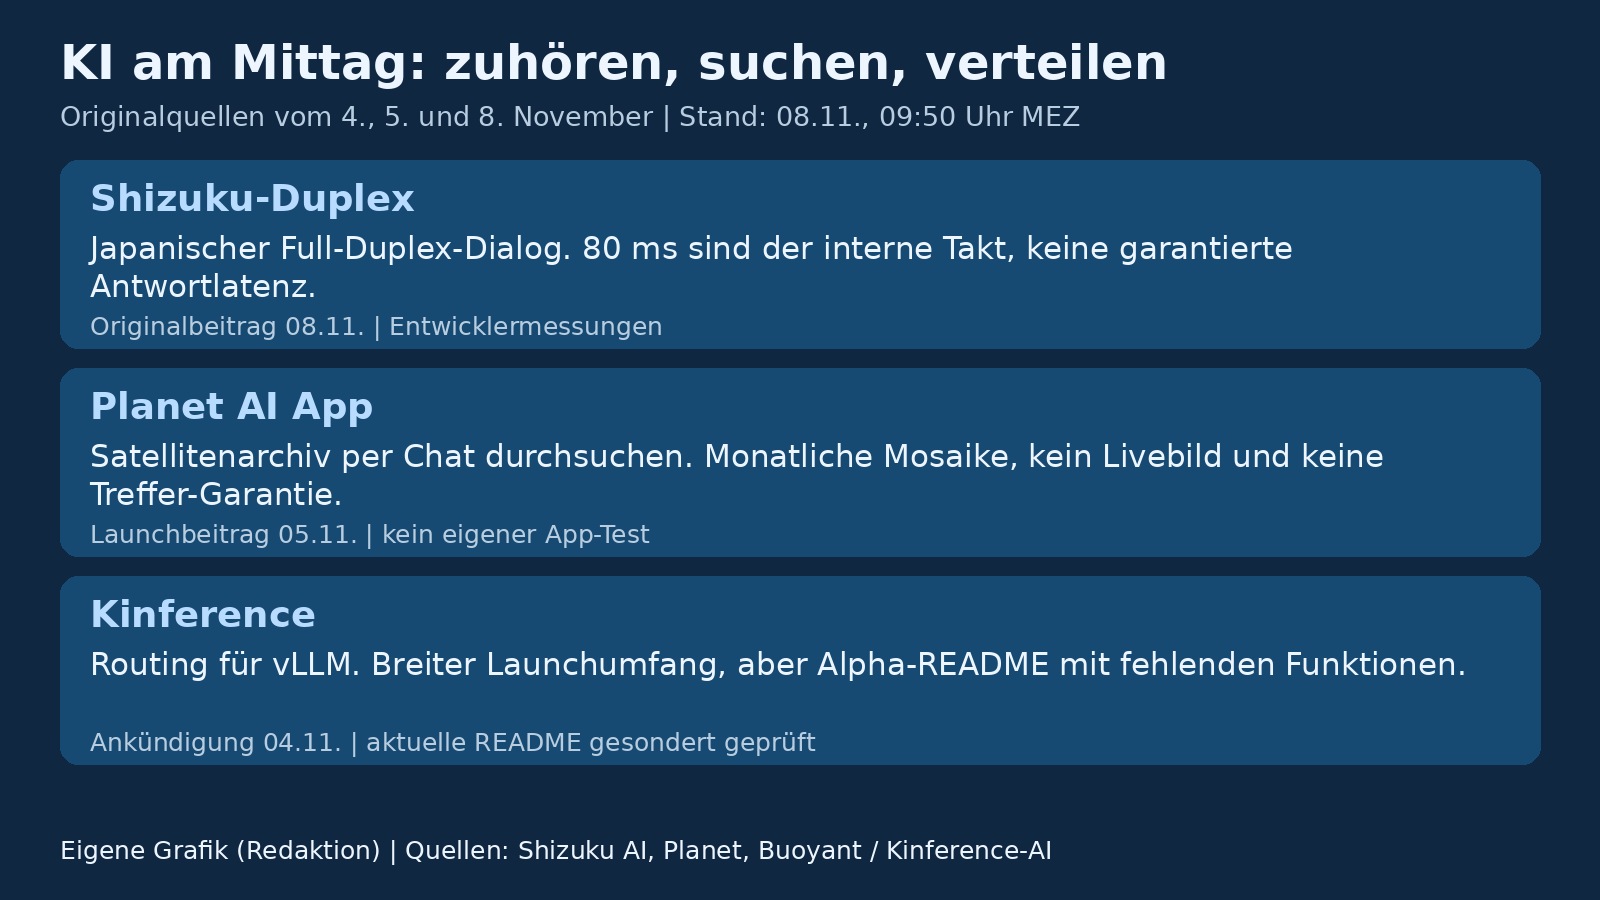
- Shizuku-Duplex soll gleichzeitig sprechen und zuhören. 80 ms sind der interne Verarbeitungstakt, nicht die Antwortlatenz. Die veröffentlichten Gesprächswerte stammen vom Entwickler.
- Planet beschreibt eine Chat-Suche in mehr als zehn Jahren Satellitenbildern. Die Suche arbeitet mit monatlichen Mosaiken und soll Hinweise für die weitere Analyse liefern.
- Buoyant bewirbt Kinference als Inferenzplattform für vLLM. Die aktuelle README nennt den Code jedoch Alpha und listet unter anderem Rate Limiting und semantische Klassifikatoren als noch fehlend.
Mittagsüberblick vom 8. November 2026. Quellenstand: 09:50 Uhr MEZ. Shizuku AI zeigt ein japanisches Sprachmodell für überlappende Gespräche. Zwei weitere noch nicht behandelte Themen aus den vergangenen Tagen: Planet verbindet Satellitenbilder mit einer Chat-Suche, und Kinference will Anfragen zwischen Inferenzservern verteilen. Bei Kinference ist der Abstand zwischen Ankündigung und dokumentiertem Codezustand besonders wichtig.
Shizuku-Duplex: Sprechen und Zuhören im selben Takt
Shizuku AI stellt im Originalbeitrag vom 8. November Shizuku-Duplex vor, ein japanisches Full-Duplex-Dialogmodell. Es hört auch während der eigenen Ausgabe weiter zu, kann zustimmende Kurzsignale geben und bei einer Unterbrechung stoppen. Ein Gesprächsmodell führt die Unterhaltung; ein asynchron arbeitendes Hintergrundmodell übernimmt schwierige Anfragen und Werkzeuge wie Websuche. Die Verarbeitung erfolgt laut Entwickler in 80-Millisekunden-Schritten. Das bezeichnet den internen Takt, nicht eine garantierte Antwortzeit.
In einer selbst zusammengestellten japanischen Evaluation meldet das Team 0,57 Sekunden mediane Zeit vom Sprechende bis zur Antwort und 89 Prozent rechtzeitige Stopps innerhalb von zwei Sekunden bei Unterbrechungen. Die Latenz stammt aus serverseitigen Aufnahmen ohne Netzwerkrundlauf. Gegenübergestellte Werte von GPT-Realtime und Gemini Live schließen dagegen Netzwerkzeit ein und sind daher nicht direkt gleichartig. Schwächen bleiben sichtbar: Bei Hintergrundsprache antwortete Shizuku im Test in 75 Prozent der Fälle, obwohl Nicht-Reagieren erwünscht war. Es handelt sich um Entwicklerergebnisse, nicht um eine unabhängige Prüfung. Der Beitrag zeigt Beispiele und Architektur, belegt aber keinen veröffentlichten Gewichte-Download.
Planet: Satellitenarchive mit Alltagssprache erkunden
Planet beschreibt im Launchbeitrag vom 5. November eine kartenbasierte KI-App, die mehr als zehn Jahre eigener Satellitenbilder erschließt. Nutzer können Orte anhand sprachlicher Beschreibungen suchen, Veränderungen im Zeitverlauf verfolgen und Bilder nebeneinander oder als Zeitraffer betrachten. Für die großräumige Suche übersetzt ein Sprachmodell die Anfrage in Abfragen einer Vektorkarte, die auf der KI-Auswertung monatlicher Bildmosaike beruht. Das ist keine Livekamera der Erde.
Laut Planet können Nutzer auch Bilder oder CSV-Dateien ergänzen und Agenten mit vertiefter Analyse beziehungsweise regelmäßigen Berichten beauftragen. Die Firma ordnet die Suche vor allem am Anfang einer Untersuchung ein: Sie soll relevante Orte und Veränderungen auffindbar machen. Das Bildmaterial bleibt zur Kontrolle einsehbar. Ob ein Suchtreffer tatsächlich etwa eine neue Baustelle oder einen Schaden zeigt, muss weiterhin geprüft werden. Der Beitrag liefert Produkt- und Anwenderbeschreibungen, keinen unabhängigen Genauigkeitsbenchmark; ein eigener Funktionstest der App liegt diesem Überblick nicht zugrunde.
Kinference: Launchversprechen treffen auf Alpha-Grenzen
Buoyant kündigte Kinference am 4. November als allgemein verfügbare Steuerungsschicht für Kubernetes und vLLM an. Die Idee: Anfragen anhand von Richtlinien, Warteschlangen und bereits vorhandenen KV-Cache-Inhalten zu einem passenden Inferenzserver leiten. Der Cache enthält Zwischenergebnisse des Modells; ihre Wiederverwendung kann unnötige Rechenarbeit vermeiden. Produktseite und begleitender vLLM-Blog bewerben darüber hinaus Tokenlimits, semantische Anfrageklassifikation und Anthropic-kompatiblen Verkehr.
Die aktuell gelesene README des öffentlichen Repositorys setzt deutlich engere Grenzen. Sie nennt Kinference Alpha-Software ohne längere Produktionserfahrung und führt Unterstützung für /v1/messages, Rate Limiting, semantische Klassifikatoren und mehrere Replikate ausdrücklich als noch fehlend auf. Dokumentiert sind eine gRPC-Schnittstelle zur Endpunktauswahl, KV-Cache-Ereignisse, Engine-Metriken und die Kopplung mit einem Proxy. Damit bleibt offen, welcher beworbene Umfang in welcher Auslieferung tatsächlich verfügbar ist. Für eine Einführung reicht die Launchbeschreibung allein nicht; die gewünschten Funktionen müssen am konkret eingesetzten Stand geprüft werden.
Häufige Fragen
Antwortet Shizuku-Duplex in 80 Millisekunden?
Das behaupten die verwendeten Zahlen nicht. 80 ms bezeichnen einen Verarbeitungsschritt. Die vom Entwickler gemessene mediane Antwortzeit beträgt 0,57 Sekunden, serverseitig und ohne Netzwerkrundlauf.
Sind Planet-Suchergebnisse bereits gesicherte Befunde?
Nein. Die App soll geeignete Orte und Veränderungen für eine Analyse auffindbar machen. Die Originalbilder dienen zur Kontrolle; ein unabhängiger Genauigkeitsnachweis ist im verwendeten Launchbeitrag nicht enthalten.
Ist der gesamte beworbene Kinference-Umfang bestätigt?
Nein. Launch und Produktseite nennen Funktionen, die die aktuelle öffentliche README noch als fehlend listet. Der Artikel trennt diese widersprüchlichen Dokumentationsstände und behauptet keinen vollständigen Produktivbetrieb.
Quellen
- Shizuku-Duplex: Japanese Full-Duplex Model for Natural Conversation (Shizuku AI, abgerufen 2026-11-08)
- Introducing the Planet AI App: Search. Explore. Act. (Planet, abgerufen 2026-11-08)
- Buoyant Announces Kinference: An Open Source Inference Serving Platform for Kubernetes (Buoyant, abgerufen 2026-11-08)
- Introducing Kinference: An Open Source Inference Control Plane for vLLM and Kubernetes (vLLM Blog / Buoyant, abgerufen 2026-11-08)
- Kinference-AI/kinference: README und Known limitations (GitHub / Kinference-AI, abgerufen 2026-11-08)
- Kinference: Produktbeschreibung und Policies (Kinference, abgerufen 2026-11-08)
Weitere Artikel
- Voxtral 3: Mistrals Sprach-Agenten hören, denken und antworten in Echtzeit
- Eigener LLM-Proxy: Wer seine KI-Nutzung nicht misst, rätselt nur
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.