


KI am Mittag: Fehlerdetektive, Gewichtslöschung, Widerspruch
Die wichtigsten Fakten
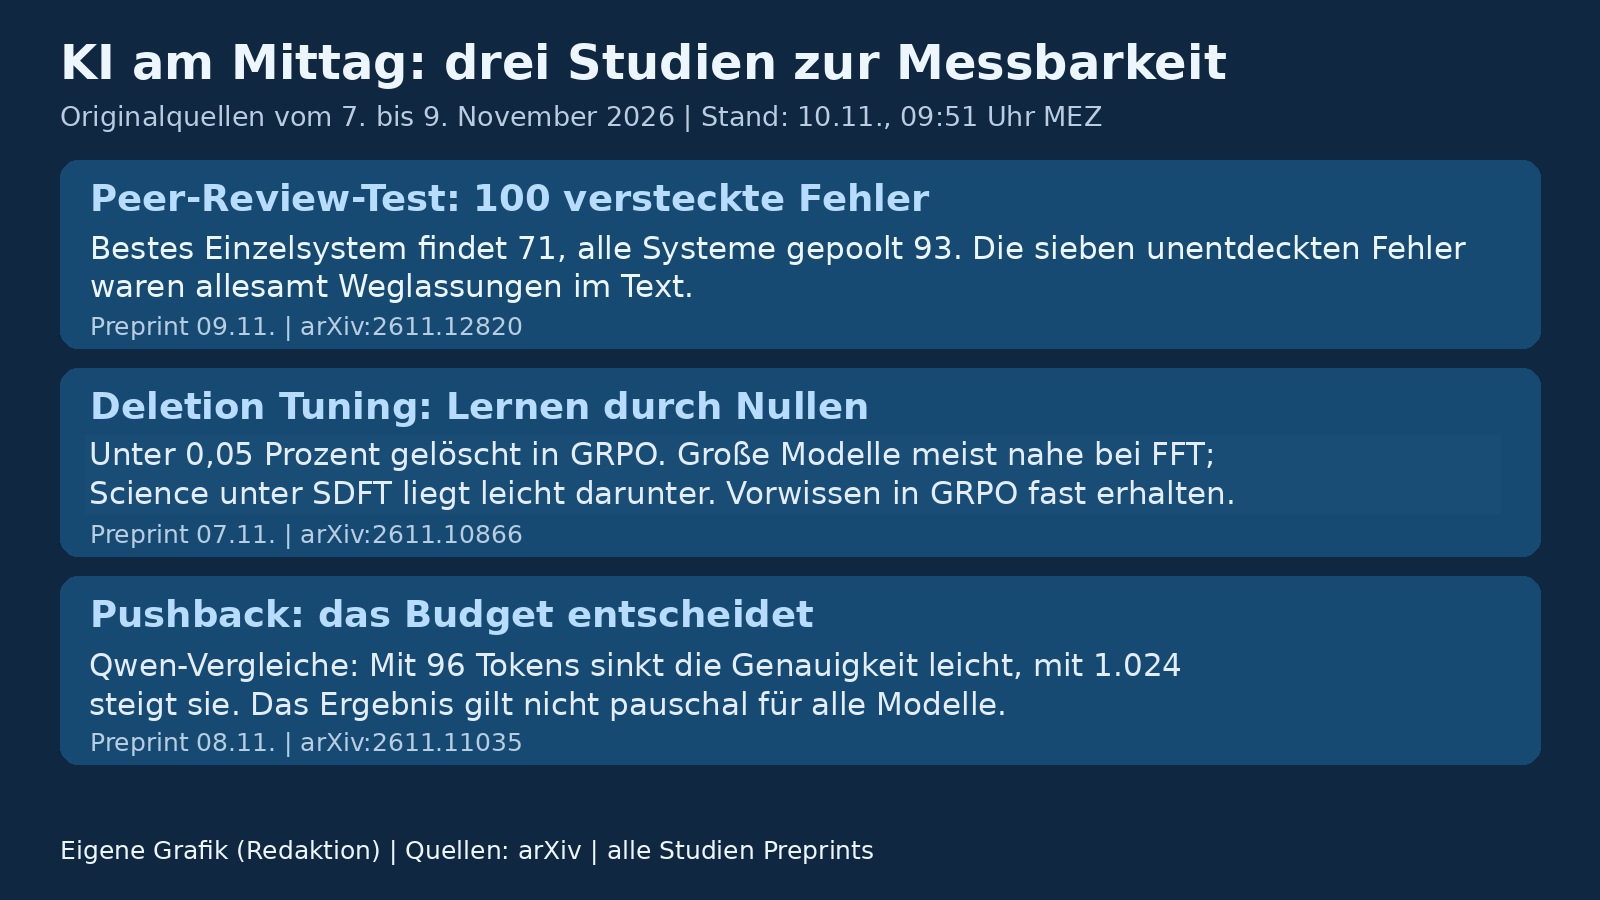
- 100 absichtlich eingebaute Fehler in zehn Psychologie-Papieren: Das beste Einzelsystem fand 71, der Pool aller Systeme 93. Die sieben unentdeckten Fehler waren allesamt Weglassungen, etwa entfernte Präregistrierungs-Angaben.
- Deletion Tuning lernt eine Löschmaske. In den GRPO-Läufen wurden weniger als 0,05 Prozent aller Gewichte gelöscht; bei großen getesteten Modellen liegt die Genauigkeit meist nahe bei oder über FFT. Science unter SDFT liegt leicht darunter. In GRPO-Tests blieb Vorwissen nahezu erhalten.
- Im untersuchten Qwen-Setup ändert das Antwortbudget den Effekt von Widerspruch: Mit kurzen Repliken sinkt die Genauigkeit leicht, mit 1.024 Tokens steigt sie in den drei verglichenen Qwen-Einstellungen um 3,8 bis 5,7 Punkte. Das ist kein Befund für alle Modelle.
Mittagsüberblick vom 10. November 2026. Quellenstand: 09:51 Uhr MEZ. Drei Studien, drei Prüfsteine für den Umgang mit KI-Systemen: ein Benchmark mit 100 versteckten Fehlern für die automatische Begutachtung von Fachartikeln, eine Nachtrainingsmethode, die Gewichte nur löscht statt sie zu verändern, und eine Untersuchung, warum kurze Antwortfenster die Messung von Anbiederung verzerren. Alle drei Arbeiten sind Preprints; wir haben die Ergebnisse nicht selbst repliziert.
Begutachtung im Test: 100 versteckte Fehler
Wie gut finden KI-Systeme Fehler in wissenschaftlichen Artikeln? Paul Litvak vom Robyn Dawes Institute hat dafür einen kontrollierten Maßstab gebaut: In zehn offen lizenzierte Psychologie-Papiere baute er hundert bekannte Fehler ein, zehn pro Paper, verteilt auf eine Taxonomie mit 62 Fehlerkategorien. Ein Teil der Fehler war eingefügt, ein Teil bestand aus gestrichenen Informationen, etwa einer gelöschten Angabe zur Berechnung des zentralen Messwerts. Die präparierten Paper gingen durch mehrere Frontier-Modelle (Claude und GPT teils mit und ohne zusätzliches Reasoning sowie Gemini) und durch die beiden kommerziellen Begutachtungswerkzeuge Reviewer3 und Refine.ink. Die Modellläufe stammen aus dem März und Juni 2026; die Hierarchie der Systeme ordnet der Autor selbst nur vorsichtig ein, weil kleine Abstände bei dieser Fehlerzahl nicht belastbar sind.
Das Ergebnis in Zahlen: Das beste Einzelsystem (GPT-5.5 mit hohem Reasoning-Aufwand) fand 71 der 100 Fehler, das schwächste (Reviewer3) 30. Bemerkenswert ist der Ensemble-Effekt: Die Modelle finden nur teilweise dieselben Fehler, deshalb steigert das Bündeln die Trefferquote deutlich. Alle Grundmodelle zusammen kamen auf 91, mit den Werkzeugen auf 93 Fehler. Refine.ink lieferte die meisten Alleinstellungstreffer, ist dem Paper zufolge aber pro gefundenem Fehler um Größenordnungen teurer. Sieben Fehler entgingen allen Systemen, und alle sieben waren Weglassungen: Kein System bemängelte von sich aus etwa entfernte Präregistrierungs-Hinweise. Das deckt sich mit dem bekannten Befund, dass Modelle fehlende Inhalte schlecht erkennen. Drei Wiederholungsläufe desselben Modells brachten keine zusätzlichen Treffer.
Die Grenzen benennt der Autor selbst: Falsch-positiv-Meldungen wurden nicht gemessen, die Fehlerverteilung echter Paper ist unbekannt, und die Studie deckt nur empirische Psychologie ab. Der Autor verweist außerdem auf eine UChicago-Arbeit mit ähnlicher Methode über acht arXiv-Fachklassen (Bestwert 71,6 Prozent). Diese zitierte Arbeit haben wir nicht separat geprüft. Paper, Fehlerliste, Modellausgaben und das vollständige Versuchsprotokoll liegen öffentlich auf GitHub, ausdrücklich als Startpunkt für einen breiteren Benchmark. Der Autor hat nicht alle 100 eingebauten Fehler vollständig von Hand überprüft.
Deletion Tuning: Nachtraining durch reines Löschen
Muss man einem vortrainierten Modell neue Werte beibringen, damit es Neues lernt? Forscher der New York University und der University of Calgary sagen: nein. Ihre Methode Deletion Tuning lernt ausschließlich eine Binärmaske über die Gate-Projektion der Transformer-Blöcke. Jedes Gewicht behält entweder seinen vortrainierten Wert oder wird auf null gesetzt; kein einziger neuer Wert wird geschrieben. Initialisiert wird mit einem Wanda-Pruning-Score, trainiert wird je Gewicht ein einzelner Logit, dessen Sigmoid im Lauf zum harten Schwellenwert geschärft wird.
Getestet wurde in drei Nachtrainingsregimen: Reinforcement Learning mit prüfbaren Belohnungen (GRPO), überwachtes Fine-Tuning und On-Policy-Distillation, über acht Modelle zweier Familien von 0,5 bis 30 Milliarden Parametern. In allen GRPO-Läufen löschte das Verfahren weniger als 0,05 Prozent aller Gewichte. Bei den größeren getesteten Modellen liegt es meist nahe bei oder über vollem Fine-Tuning: Llama-8B auf GSM8K 83,55 gegenüber 83,24 Prozent, Qwen-7B im SimpleRL-Zoo-Mittel 52,32 gegenüber 51,89, bis hinauf zum 30B-Mixture-of-Experts-Modell (58,54 gegenüber 58,43). Bei kleineren GRPO-Modellen erreichte die Methode rund 90 bis 99 Prozent der FFT-Genauigkeit. Eine Kontrolle zeigt, dass der Wanda-Startpunkt allein nahe am Basismodell bleibt: Die Gewinne stammen aus dem gelernten Maskieren, nicht aus der Initialisierung. Unter SDFT liegt ToolAlpaca mit 69,07 gegenüber 68,04 Prozent darüber, Science mit 70,61 gegenüber 71,20 aber leicht darunter.
Zwei praktische Vorteile fallen an: Im GRPO-Hauptvergleich belegt die komprimierte Maske bei Llama 1,0 bis 8,4 Megabyte (1B bis 8B). Über die sechs dort getesteten Backbones ist sie rund 3.600- bis 4.700-mal kleiner als der FFT-Checkpoint und kleiner als LoRA mit Rang 1. Und das Modell vergisst kaum: In den GRPO-Versuchen mit Llama blieb Deletion Tuning auf einer Sechs-Benchmark-Suite früherer Fähigkeiten während des gesamten Trainings innerhalb eines Punkts vom Ausgangswert, während FFT, LoRA und zufällige Sparse-Updates bis zu 5,4 Punkte verloren. Die Analyse der Update-Geometrie zeigt, dass die gelernten Masken dem FFT-Update näher kommen als LoRA oder zufällige Auswahl. Offen bleibt der Test am Stück (Continual Learning über Aufgabenfolgen) und der Speicherbedarf im Training, der über LoRA liegt.
Widerspruch: Anbiederung oder zweite Chance?
Ein Nutzer fragt nur: Bist du sicher? Bisherige Studien messen daran vor allem, wie oft Modelle eine richtige Antwort aufgeben, also Anbiederung zeigen. Ook Lee von der Hanyang-Universität misst gleichzeitig den Gegeneffekt: Wie oft wird eine falsche Antwort nach demselben Widerspruch korrigiert? Getestet mit vier offenen Modellen (Qwen3 in drei Größen, OLMo-2 7B) auf Multiple-Choice-Fragen aus MMLU und ARC-Challenge, die Endantwort exakt aus den Options-Logits gelesen.
Das Ergebnis kippt mit dem Antwortbudget. Durfte Qwen3-4B seine Replik auf höchstens 96 Tokens begrenzen, sank die Trefferquote nach Widerspruch leicht; mit 1.024 Tokens korrigierte das Modell 43 Prozent seiner falschen Antworten und die Trefferquote stieg um 5,7 Punkte. In den Qwen-Vergleichen mit beiden Budgets wuchs die Korrekturrate mit voller Replik um 6 bis 31 Punkte, während sich die Aufgaberate kaum änderte. Kurze Budgets verstecken also vor allem die Selbstkorrektur, statt Anbiederung zu erzeugen. Eine einfache Break-even-Regel sagt den Nettoeffekt voraus: Widerspruch hilft, wenn die Ausgangstrefferquote unter c/(c+k) liegt, mit Korrekturrate c und Aufgaberate k. Unter vollen Repliken zeigte allein OLMo-2 auf ARC im Punktschätzer einen negativen Nettoeffekt (-1,2 Punkte); das 95-Prozent-Intervall von -4,8 bis +2,4 schließt aber auch keinen Effekt ein.
Ein gemeinsames internes Signal beider Verhaltensweisen war in den Tests über die Konfidenz hinaus nur bei gekürzten Repliken nachweisbar: Eine Sonde, die auf Selbstkorrektur-Fällen trainiert wurde, sagte das Aufgeben richtiger Antworten nur bei gekürzten Repliken über die Konfidenz hinaus voraus, bei vollen Repliken nicht. In den Tests konnte Aktivierungs-Steering Anbiederung nicht selektiv dämpfen: Wo es wirkte, unterdrückte es die Selbstkorrektur gleich mit. Die Empfehlung des Autors an die Evaluationspraxis: volle Repliken erlauben, Korrekturraten neben Aufgaberaten berichten und die Break-even-Bedingung prüfen, bevor Widerspruch als schädlich gilt. Limitationen: Modelle bis 8 Milliarden Parameter in 4-Bit-Quantisierung, ein einziger einheitlicher Widerspruch, nur Multiple-Choice.
Häufige Fragen
Kann KI-Begutachtung menschliche Gutachter jetzt ersetzen?
Die Studie beantwortet das nicht. Sie misst nur das Auffinden eingebauter Fehler, nicht Falsch-Alarme, und nur in der empirischen Psychologie. Dass sieben Weglassungsfehler allen Systemen entgingen, zeigt zudem eine blinde Stelle genau dort, wo menschliche Gutachter gezielt nachfragen.
Ist Deletion Tuning ein Ersatz für LoRA?
Noch nicht pauschal. Bei den größten getesteten Modellen lag die Methode meist nahe bei oder über vollem Fine-Tuning, bei Science aber leicht darunter. Kleinere Modelle hatten teils größere Abstände. Der Adapter ist zwar winzig und vergisst wenig, doch der Trainings-Speicherbedarf liegt über LoRA, weil pro maskiertem Gewicht ein Logit trainiert wird.
Sollte man ein Modell nicht mehr infrage stellen, weil es sonst anbiedernd wird?
Im Gegenteil: Mit ausreichend Antwortraum verbesserte sich die Trefferquote nach Widerspruch in den meisten getesteten Einstellungen, weil die Modelle falsche Antworten reparierten. Problematisch sind eher stark verkürzte Antwortfenster, die diese Selbstkorrektur abschneiden.
Quellen
- How Well Does AI Peer Review Work? A Benchmark Built from 100 Planted Errors (arXiv (Paul Litvak, Robyn Dawes Institute), abgerufen 2026-11-10)
- The Surprising Effectiveness of Deleting Weights in LLM Post-Training (arXiv (New York University / University of Calgary), abgerufen 2026-11-10)
- Room to Reconsider: Reply Length Decides Whether Pushback Makes Language Models Sycophantic or Self-Correcting (arXiv (Ook Lee, Hanyang University), abgerufen 2026-11-10)
Weitere Artikel
- Stanford-Test: 22 von 50 LLM-Befunden gelten als abgelaufen
- Weight-Space Programming: Ein Sprachmodell, das neuronale Netze von Hand repariert
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.