


KI am Mittag: Der Agent wird Workflow, Neuronen zählen
Die wichtigsten Fakten
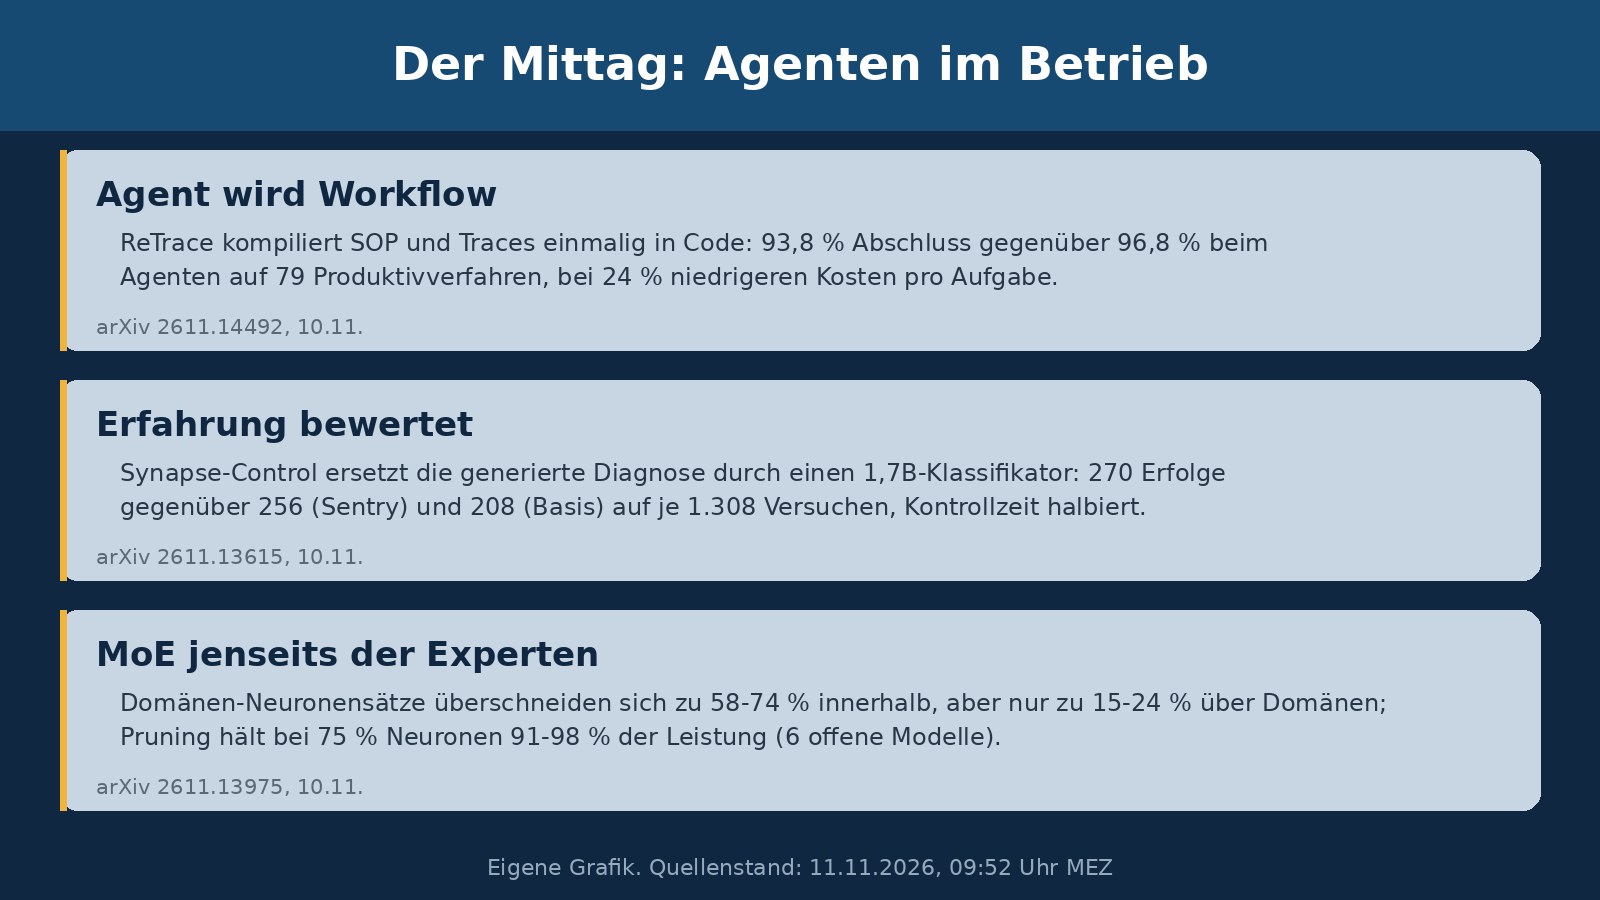
- ReTrace kompiliert SOP und Agenten-Traces in einen Workflow ohne Laufzeit-Planer: 93,8 Prozent Abschluss gegenüber 96,8 beim Agenten auf 79 Produktivverfahren, bei 24 Prozent niedrigeren Kosten pro Aufgabe; auf tau-2-bench 1,3 statt 170 Sekunden pro Aufgabe.
- Synapse-Control ersetzt die generierte Fehlerdiagnose durch einen 1,7B-Klassifikator: 270 Erfolge gegenüber 256 (Sentry) und 208 (Basis) auf je 1.308 Versuchen in AppWorld und WebShop, bei halbierter Kontrollzeit und 4.987 ersetzten Diagnoseaufrufen.
- MoE-Modelle organisieren ihre Domänenspezialisierung auf Neuronenebene: Die Neuronensätze einer Domäne überschneiden sich zu 58 bis 74 Prozent innerhalb und nur zu 15 bis 24 Prozent über Domänen hinweg; ein darauf aufbauendes Pruning hält bei 75 Prozent Neuronen 91 bis 98 Prozent der Leistung.
Mittagsüberblick vom 11. November 2026. Quellenstand: 09:52 Uhr MEZ. Drei neue Studien drehen sich um den Betrieb von KI-Systemen nach dem Training: wie aus protokollierten Agentenläufen feste Workflows ohne Planer zur Laufzeit entstehen, wie eine kleine Kontrollebene die Kosten wiederverwendeter Erfahrung senkt und wo in MoE-Modellen die Spezialisierung tatsächlich organisiert ist. Alle drei Arbeiten sind Preprints; der Quellenabgleich stützt sich auf die Originalarbeiten. Alle Leistungs- und Kostenzahlen sind Angaben der jeweiligen Autorenteams, keine eigenen Messungen.
ReTrace: Der Agent wird zur Baufirma, nicht zum Bewohner
Agenten, die bei jedem Schritt jeder Ausführung ein Sprachmodell fragen, sind bei hohen Stückzahlen langsam und teuer. Auf der im Paper unbenannten Produktivplattform der Autoren waren zwischen April und Juni 2026 von 5.115 Kunden-Automatisierungen 91,8 Prozent solcher Laufzeit-Planer, doch sieben der zehn am häufigsten ausgeführten Automatisierungen waren feste Workflows; bei Agenten mit drei bis fünf Werkzeugen fraß die Schrittwahl 37 bis 43 Prozent der Ausführungszeit. ReTrace liest daher die Begründungen, die der Agent mit jedem Werkzeugaufruf mitschreibt: Daraus extrahiert es Bedingung, Werkzeug und Datenquelle jedes Schritts, bündelt sie über mehrere Läufe zu einem Regeldokument mit Belegzitaten (Alternativen, die kein Lauf je ausführte, bleiben als unbezeugt markiert) und erzeugt daraus einmalig einen ausführbaren Workflow. Zur Laufzeit wählt Code den nächsten Schritt, kein Modell; einzelne Werkzeuge dürfen intern weiterhin Modelle nutzen.
Die Messwerte: Auf 79 Produktivverfahren erreichen die Workflows 93,8 Prozent Abschluss gegenüber 96,8 Prozent beim Agenten, bei 24 Prozent niedrigeren Kosten pro Aufgabe (0,096 statt 0,127 Dollar) und einer um 46 Prozent kürzeren Medianzeit (37 statt 68 Sekunden); dass die mittlere Zeit trotzdem steigt, liegt an Web-Verfahren, deren Werkzeugaufrufe beim Agenten zu 73 Prozent scheitern und manche Agentenläufe ohne einen einzigen erfolgreichen Aufruf als abgeschlossen zählen. Auf tau-2-bench (Telekom-Bereich, Sonnet 4.6) kommt ReTrace auf 75,8 Prozent Aufgabenerfolg gegenüber 80,6 Prozent, braucht aber 1,3 statt 170 Sekunden pro Aufgabe; drei Reparaturrunden an Trainingsfehlern heben eine separat mit zwei Traces gebaute Variante von 66,7 auf 81,2 Prozent. Auf acht SOP-Bench-Verfahren liegt es ohne Reparatur hinter Few-Shot (80,6 gegenüber 83,6 Prozent), mit Reparatur vorn (87,8 Prozent in 0,40 Sekunden gegenüber 85,5 in 46,6). Die Begründungen in den Traces tragen 6,2 beziehungsweise 8,8 Punkte bei, nicht aber auf den kurzen SOP-Bench-Prozeduren; mehr vollständige Traces senken irgendwann die Baurate (100 Prozent bei 16 Traces, 31 Prozent bei 32). Grenzen: nur neue Eingaben derselben Verfahren, kein Transfer; die Plattform kann Fehlläufe als abgeschlossen melden; die Trace-Stichprobe allein kann auf einem Verfahren 50 Punkte ausmachen. Faustregel der Autoren: Ab etwa 75 Ausführungen hat sich der Bau amortisiert.
Synapse-Control: Erfahrung bewerten statt diagnostizieren
Wiederverwendete Erfahrung hat ihren Preis: Systeme wie Sentry lassen vor jedem Ratschlag ein großes Modell eine Fehlerdiagnose schreiben; gemessen machten diese Hilfsaufrufe 21,4 Prozent (AppWorld) und 18,2 Prozent (WebShop) der Actor-Anfragezeit aus. Synapse-Control (Shanghai Jiao Tong University und Ant Group) nutzt eine Asymmetrie: Eine Diagnose zu erzeugen ist aufwendig, einen bereits gefundenen Ratschlag zu bewerten ist billig. Regeln stellen höchstens fünf passende Einträge aus Mikroverträgen (lokale Schnittstellenfakten wie Pflichtargumente) bereit, ein auf 32B-Lehrerlabels feinabgestimmter 1,7B-Klassifikator bewertet sie als hilfreich, unnötig oder schädlich, und eine Prompt Value Table mit Abklingzeit und Tokenbudget (2.048) bremst Wiederholungen; pro Schritt geht höchstens ein Hinweis an den Actor (Qwen3.5-9B, für alle Methoden identisch).
Auf je 1.308 Versuchen (AppWorld: 168 Aufgaben in sechs Reihenfolgen; WebShop: 100 in drei) erreicht Synapse-Control 270 Erfolge gegenüber 256 für Sentry und 208 ohne Unterstützung, ersetzt 4.987 generierte Diagnoseaufrufe und halbiert die Kontrollzeit pro Versuch (10,10 auf 5,03 beziehungsweise 8,72 auf 4,27 Sekunden); die Gesamtaufgabenzeit sinkt in WebShop um 21,4 Prozent gegenüber Sentry, die Eingabetoken pro Erfolg um 27,5 Prozent gegenüber der Basis. Der Klassifikator lässt auf zurückgehaltenen Kandidaten 94,0 Prozent (AppWorld) und 98,15 Prozent (WebShop) präzise zu; ein schädlicher Kandidat rutscht durch. Die Verlaufskontrolle streicht rund zwei Drittel der wiederholten Hinweise; gelernte statt lexikalischer Auswahl hält 97,7 beziehungsweise 99,2 Prozent des Scores bei 11,2 beziehungsweise 5,8 Prozent weniger Eingabetoken. Grenzen: ein einziger Actor, lokaler Serving-Fokus, Lehrerlabels aus einem 32B-Modell, kalibrierte Schwelle je Umgebung.
MoE: Spezialisierung über Expertengrenzen hinweg
Sind die Experten eines MoE-Modells Fachabteilungen oder nicht? Die Literatur widerspricht sich: Routing-Präferenzen für Domänen stehen gegen Befunde, wonach das Routing vor allem Token-Identität und Syntax folgt. Ein Team von NTU, Tencent und NUS legt die Messlatte eine Ebene tiefer: RAMP gewichtet die Aktivierung jedes Neurons mit dem Routing-Koeffizienten seines Experten und der Norm seiner Ausgabeprojektion. Über sechs offene Modelle (drei Qwen3-Generationen, GLM-4.7-Flash, Qwen1.5-MoE, OLMoE) überschneiden sich die wichtigsten Neuronensätze einer Domäne zu 58 bis 74 Prozent mit weiteren Stichproben derselben Domäne, aber nur zu 15 bis 24 Prozent über Domänen hinweg; 66,4 bis 83,4 Prozent der domänenexklusiven Neuronen liegen konzentriert in wenigen Experten, und diese Anreicherung korreliert mit den Routing-Präferenzen (medianer Spearman 0,37 bis 0,67). Beide Befundlagen stimmen also: Die Domänenorganisation existiert, nur nicht an Expertengrenzen. Im Training reorganisieren sich die Neuronen im Pre-Training weiter, während das Routing schon stabil wirkt (Übergänge mit höchstens 5 Prozent Routing-Verschiebung: 209 von 240 bei OLMoE); nach dem Supervised Finetuning bleiben die Rangfolgen praktisch stehen (Korrelationen über 0,997).
Praktisch wird das beim Pruning: RAMPr wählt Neuronen über Expertengrenzen hinweg und hält bei 75 Prozent verbliebenen Neuronen 91,1 bis 97,6 Prozent der Leistung (90 Prozent: 95,3 bis 100,8), bei 50 Prozent noch 83,0 bis 88,5 Prozent in vier von sechs Modellen; Qwen3 (61,0) und GLM-4.7 (66,2) fallen stärker. Beide Fisher-Baselines liegen in allen sechs Modellen darunter; gegen das Experten-Pruning REAP gewinnt die domänenbalancierte Variante auf GLM-4.7 bei 75 Prozent um 2,91 Punkte, während REAP auf Qwen3 bei 50 Prozent mehr erhält (76,7 Prozent). Im gemessenen Serving-Setup (Batch 32, 2.048 Eingabetoken) sinkt der residente Speicher bei 50 Prozent Neuronen um 36 bis 43 Prozent, der Batched-Prefill steigt um 17 bis 39 Prozent, der Decode bleibt praktisch unverändert. Die Kalibrierung ist ein Hebel: Für Qwen3 bei 50 Prozent mit Kalibrierung auf fünf Generierungsdomänen statt allen elf Domänen springt MBPP von 4,0 auf 66,8. Grenzen: sechs offene Modelle, 128 Kalibrierungstexte je Domäne, AIME aus der Wertung ausgeschlossen.
Häufige Fragen
Wann lohnt es sich, einen Agenten in einen Workflow zu kompilieren?
Bei Verfahren, die oft und gleichförmig laufen. Die Autoren schätzen aus ihren Messwerten, dass sich der Bau nach etwa 75 Ausführungen amortisiert; die sieben meistgenutzten Workflows ihrer Plattform liefen in drei Monaten 297.000 bis 528.000 Mal. Für seltene oder sich ändernde Verfahren bleibt der Laufzeit-Agent die flexiblere Wahl; bei geändertem SOP oder Werkzeugen muss der Workflow neu gebaut werden.
Ersetzt der 1,7B-Klassifikator das große Modell?
Nein. Er übernimmt nur die Kontrollebene: ob ein bereits gefundener Erfahrungsratschlag zum sichtbaren Zustand passt und wann er zugestellt wird. Planung und Aktionen bleiben beim unveränderten Actor. Genau diese Arbeitsteilung macht den Gewinn aus: Bewerten ist rechnerisch viel billiger als Diagnostizieren.
Kann man ein MoE-Modell einfach auf die Hälfte kürzen?
Nicht ohne Verluste, und es kommt auf das Modell an. Bei 50 Prozent verbliebenen Neuronen hielten vier von sechs untersuchten Modellen 83 bis 88 Prozent ihrer Leistung, zwei fielen auf 61 beziehungsweise 66 Prozent. Bei 75 Prozent Neuronen blieben alle sechs zwischen 91 und 98 Prozent. Die Zusammensetzung der Kalibrierungsdaten entscheidet mit, welche Fähigkeiten erhalten bleiben.
Quellen
- ReTrace: Distilling Tool-Using Agents into Planner-Free Workflows (arXiv (Hou, Kuo u.a.; Columbia University, Amazon), abgerufen 2026-11-11)
- Synapse-Control: Making Agent Experience Actionable with Lightweight Runtime Control (arXiv (Huang, Zheng u.a.; Shanghai Jiao Tong University, Ant Group), abgerufen 2026-11-11)
- Understanding Mixture-of-Experts Language Models Beyond Expert Boundaries (arXiv (Zhou, Zheng u.a.; NTU, Tencent, NUS), abgerufen 2026-11-11)
Weitere Artikel
- Wie Claude träumt: Anthropic erklärt das Gedächtnis seiner Agenten
- Action Index: Web-Agenten lernen Abkürzungen und werden 98-mal billiger
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.