


KI am Mittag: Tiefer rechnen, Nullmodelle, Etiketten-Zweifel
Die wichtigsten Fakten
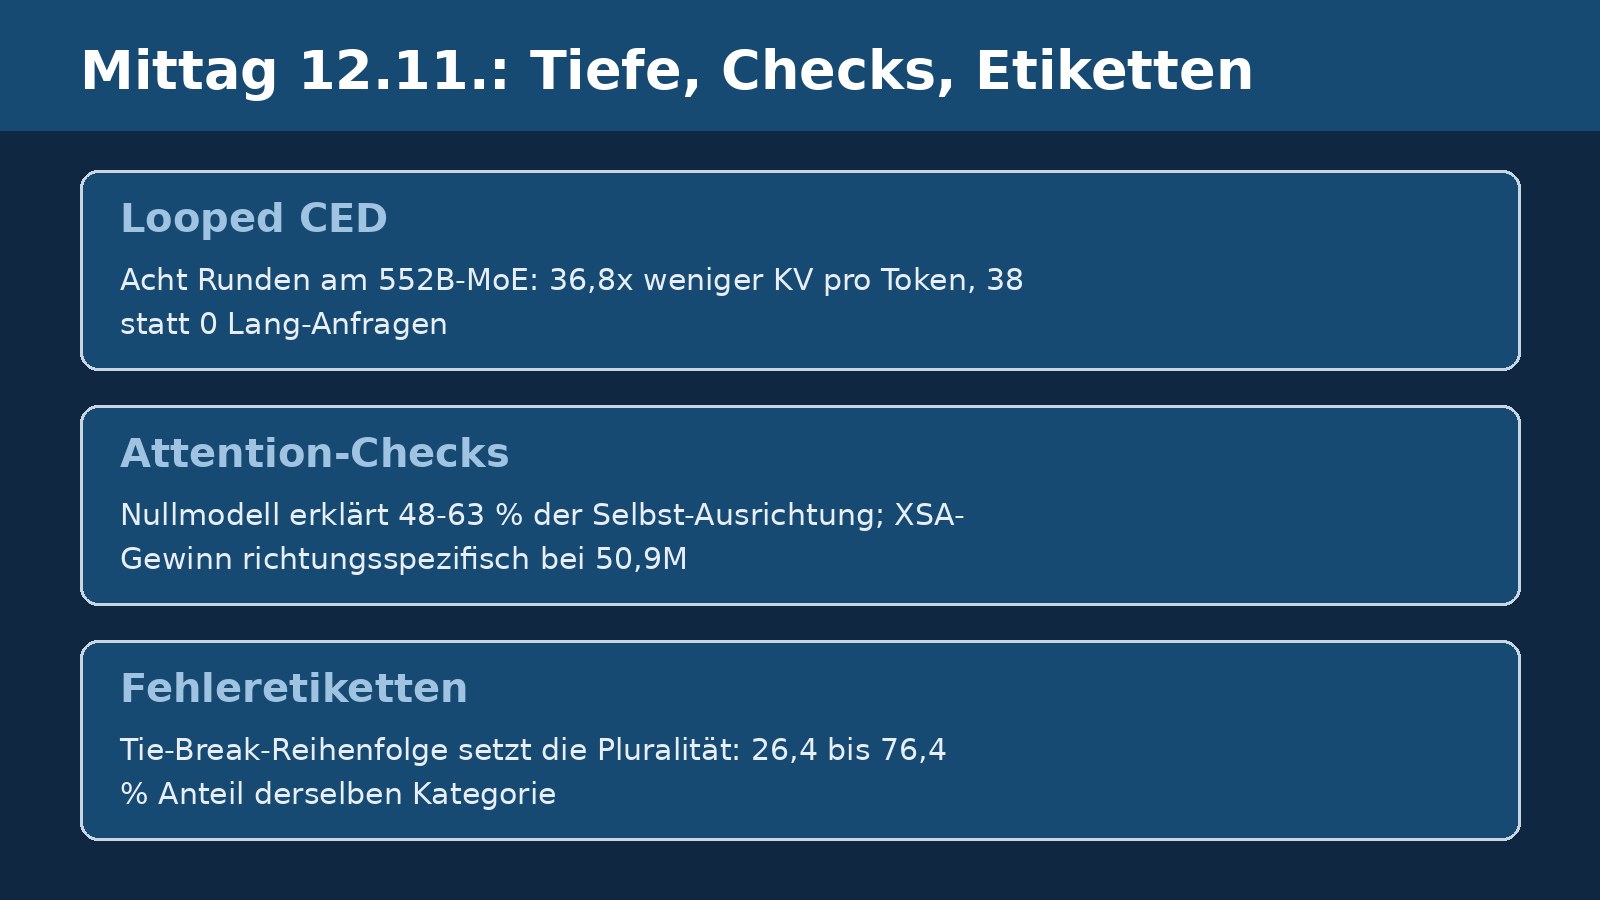
- Looped CED: Rekurrenz gehört in den Encoder; Fixpunkt-Training macht den KV-Cache rundeninvariant. DeepSeek-V4.1-Flash mit 8 Runden: 36,8-fach weniger KV pro Token, 38 statt null 128K-Anfragen, 3,6-facher Durchsatz (4xGB200). Der 552B-Kostentest nutzt nicht zum Loopen trainierte Dummy-/Originalgewichte; verlustfreies Sharing auf dieser Skala ist angenommen, nicht als Qualitätsergebnis gezeigt.
- Drei Checks für Attention-Eingriffe: Ein Positions-Nullmodell erklärt 48 bis 63 Prozent der Selbst-Kosinus-Ausrichtung (9 Modelle, 5.408 Köpfe); der XSA-Trainingsgewinn ist bei 50,9M Parametern richtungsspezifisch (-0,0029 nats, Holm p = 0,0023).
- Fehlertaxonomie unter Messvorbehalt: 50,1 Prozent der Fehler tragen Belege für mehrere Kategorien; die Tie-Break-Reihenfolge verschiebt die Pluralität in 11 von 12 Modellen, Inspector und Muttersprachler einigen sich zur Kategorie kaum (Kappa 0,093). Promptvergleich: 0,147 zu 0,636 auf denselben 106 bestimmt gelabelten Paaren; keine unabhängige Wahrheitsinstanz.
Mittagsüberblick vom 12. November. Quellenstand: 10:00 Uhr MEZ. Heute: rekurrente Modelltiefe ohne wachsenden KV-Cache, ein Prüfrahmen für Attention-Eingriffe und die Messgrenzen von Fehlertaxonomien. Die folgenden Zahlen sind Befunde der jeweiligen Autoren aus Preprints, keine von uns nachgemessenen Produktwerte.
Rekurrente Tiefe: Der Encoder looppt, der Cache bleibt
Jiaqi Leng und Kollegen (UC San Diego, Tsinghua, Nanjing) beantworten für gelooppte Sprachmodelle zwei Fragen: wo die Rekurrenz sitzen muss und wie der KV-Cache rundenübergreifend geteilt wird. Ihr Befund zum Wo: Die Schleife gehört in den Encoder eines Causal Encoder-Decoder-Stacks, weil nur so jede Runde die globale KV-Quelle verfeinert; ein Decoder-Loop liest statische Projektionen erneut, und reine lokale Fenster-Attention ohne globale Verfeinerung schneidet bei Langstreckenabhängigkeiten schlechter ab. Zum Wie: Training mit stochastischer Rekurrenztiefe treibt den Encoder-Loop in einen Fixpunkt, ab dem alle Runden den KV-Cache der letzten Runde mit nahezu gleicher BPB in den kleinen Qualitätsmodellen teilen. Die Qualitätswerte: Bei 90M-, 150M- und 340M-Parametern gleicht der gelooppte CED den gelooppten dichten Transformer auf 0,001 BPB, behält dabei nur ein Sechstel des globalen KV und schöpft 89, 86 und 93 Prozent des Loop-Gewinns der dichten Variante aus; die Langkontext-Skalierung bleibt erhalten.
Der Serving-Kostentest der Autoren: DeepSeek-V4.1-Flash (552 Milliarden Parameter), 8 Runden gelooppt, auf 4xGB200 unter SGLang. Der KV-Bedarf pro Token fällt von 60,0 auf 1,6 KB (36,8-fach), der nutzbare Pool wächst auf 5,11 Millionen Token; bei 8K/1K-Anfragen steigt der Durchsatz von 50,9 auf 185,1 Token pro Sekunde und GPU (3,6-fach); bei 128K-Kontext scheitert die Basis mit Speichermangel, der gelooppte CED bedient 38 Anfragen gleichzeitig (16,5-facher Durchsatz bei 4 Runden); im Agenten-Trace mit 512 parallelen Sitzungen sinkt die mediane Zeit bis zum ersten Token (TTFT) gegenüber CED mit Per-Round-KV von 345,1 auf 11,6 Sekunden (29,7-fach). Die Kosten nennt das Paper: 8 Runden bedeuten 4,15-fache Schichtdurchläufe und 3,95-fache Dekodierschritt-Latenz, die gemessene GB200-Prefill-Steigung liegt bei T=8 beim 5,12-fachen des ungelooppten CED (Appendix I, Tabelle 13). Die dort ebenfalls genannten 2,6 bis 2,9 betreffen die Decoder-Loop-Implementierung, nicht diesen Encoder-Loop. Die BPB-Parität ist nur an 90M bis 340M gezeigt; auf 8xH200 hält der Loop bei 1M Kontext die Anfragekapazität des ungelooppten CED und dekodiert bei 524K Kontext 3,5-fach schneller als pro-Runde-KV. Wichtig: Diese 552B-Tests verwenden Dummy- oder ursprüngliche Gewichte, die nicht zum Loopen trainiert wurden. Die Per-Round-KV-Basis wird bei gleichem Rechenaufwand über eine begrenzte KV-Pool-Größe emuliert. Gemessen werden Servingkosten, nicht Antwortqualität; verlustfreies Last-Round-Sharing wird auf 552B aus den kleinen Qualitätsmodellen angenommen. Das ist kein end-to-end trainiertes, qualitätsvalidiertes 552B-Produkt.
Drei Checks, bevor die Säge an die Attention geht
Basavaraj R M und Aryan Bharat Kumar (beide unabhängige Forschende) kritisieren ein verbreitetes Muster: Eine interne Statistik ist groß, man entfernt sie architektonisch und meldet einen Gewinn. Ihr Gegenentwurf sind drei Checks, angewandt auf XSA, das Entfernen der Komponente eines Attention-Kopfs entlang seines eigenen Value-Vektors. Check 0, Auflösbarkeit: Der Eingriffseffekt pro Kopf ist in GPT-2 reliabel messbar (Split-Half 0,795), in Pythia-160M (0,419) und Pythia-410M (0,531) abgeschwächt, während die Strukturstatistik in allen drei nahezu perfekt reliabel ist (über 0,99); welche Statistik den eigenen Eingriff vorhersagt, ist modellabhängig. Check 1, geometrisches Nullmodell: Ein Nullpartner von früheren Positionen erklärt 48 bis 63 Prozent der Kosinus-Ausrichtung zwischen Kopfausgabe und eigenem Value (neun Multi-Head-Modelle, 5.408 Köpfe, 124M bis 6,9B Parameter; Selbst-Kosinus 0,483 bei GPT-2, 0,340 bei Pythia-6,9B). Unter Grouped-Query-Attention ist die Ausrichtung gruppenspezifisch mit Überschuss gegenüber dem jeweils passenden Nullmodell von plus 0,24 bis 0,27 innerhalb und minus 0,11 bis 0,19 zwischen Gruppen; das negative Vorzeichen meint den Überschuss, nicht zwingend den rohen Kosinus.
Check 2, gematchter Eingriff: In einem vorregistrierten Faktoriell mit drei Armen und acht Seeds bei 400 Millionen Token pro Lauf zeigt die feste, beliebige Rang-1-Richtung keinen statistisch nachweisbaren Unterschied zur Basislinie (plus 0,0011 nats, p = 0,197), während die Selbst-Richtung den Validierungsverlust senkt (minus 0,0029 nats, Holm-korrigiert p = 0,0023) und die Kontrollrichtung direkt schlägt (minus 0,0040 nats, p = 0,0018). Bei 50,9 Millionen Parametern zeigt der eigene-Value-Arm also einen Vorteil gegenüber dieser statischen Kontrolle; zugleich belegt eine große Kosinus-Ausrichtung allein keine Redundanz in eingefrorenen Modellen. Grenzen nennen die Autoren selbst: kein Trainingsergebnis jenseits von 50,9M, keine Aussage zum sicheren Pruning in produktiven Modellen. Code, Rohdaten und Prüfskripte sind öffentlich (GitHub und Zenodo laut Paper); laut Autoren lassen sich 33 numerische Claims aus den archivierten Dateien reproduzieren. Wir haben deren Experimente und Checker nicht selbst ausgeführt. Der Kontrollvergleich trennt Richtungswahl nicht vollständig von Projektionsstärke: XSA ist eingabeabhängig, die Kontrollrichtung statisch; eine pro Token wechselnde Kontrolle bleibt offen.
Eine Fehlerkategorie zerlegt sich bei der Kontrolle
Madhu Sudhan Rao Beesetty (PayPal) begann eine ganz übliche Taxonomie-Studie: Er definierte Compositional Collapse (das Modell bemerkt einen strukturellen Teil der Aufgabe und lässt ihn dann fallen) und maß ihn bei zwölf Modellen in elf Sprachen auf dem öffentlichen MGSM-Symbolic-Benchmark (2.316 bewertete Datensätze aus acht Aufgabenstrukturen). Ergebnis eins: 50,1 Prozent der Fehler tragen Belege für mehr als eine Kategorie; weil der Klassifikator pro Eintrag nur ein Etikett vergibt, setzt die Reihenfolge der Tests die Pluralität. Das Umkehren zweier Tests kippt sie in elf von zwölf Modellen; über alle sechs wirksamen Reihenfolgen schwankt der Collapse-Anteil zwischen 26,4 und 76,4 Prozent und gewinnt in genau der Hälfte.
Ergebnis zwei: Muttersprachler aller elf Sprachen (179 Transkripte) stimmen mit dem Inspector bei der Antwortkorrektheit fast perfekt überein (Kappa 0,932), bei der Kategorie kaum (0,093). Ein zweiter Muttersprachler je Sprache bewertete 142 Einträge erneut; auf den 121 eindeutigen Paaren einigen sich die Menschen untereinander mit Kappa 0,659, jeder einzelne mit dem Inspector höchstens 0,094. Derselbe Inspector (Claude Sonnet 5) mit den menschlichen Anweisungen wortwörtlich steigt auf denselben 106 bestimmt gelabelten Paaren von 0,147 auf 0,636; der Mensch-Mensch-Referenzwert von 0,659 bezieht sich auf 121 Paare; die Lücke steckt also weitgehend im Prompt, nicht im Modell. Ergebnis drei: Im stratifizierten menschlichen Prüfsample, nicht im gesamten Korpus, vergibt der Inspector Collapse 1,81-mal so oft wie Muttersprachler, aber nur 1,17-mal außerhalb einer einzigen Runde, in der bengalische und chinesische Übersetzungen eine tragende Klausel verlieren; der Defekt ist den Maintainern gemeldet. Grenzen: eine Kategorie, Grundschulmathematik, ein Instrument. Empfohlen werden vier billige Checks, bevor Fehleranteile modellübergreifend verglichen werden: Mehrfachbelegung ausweisen, Tie-Break permutieren, auf geteilter Stichprobe validieren, systematische Differenzen prüfen. Diese Übereinstimmung belegt Reproduzierbarkeit unter den jeweiligen Anweisungen, nicht die Wahrheit eines Labels. Ein unabhängiger Ground-Truth-Rater fehlt, und Menschen teilen Definition und Beispiel.
Häufige Fragen
Was bringt das Loopen konkret im Betrieb?
Im Serving-Kostentest der Autoren (DeepSeek-V4.1-Flash, 8 Runden, 4xGB200): 38 statt null gleichzeitige 128K-Anfragen, 3,6-facher Durchsatz bei 8K/1K und 29,7-fach niedrigere mediane Zeit bis zum ersten Token (TTFT) gegenüber CED mit Per-Round-KV im Trace mit 512 parallelen Sitzungen, erkauft mit 3,95-facher Dekodierschritt-Latenz. Die 552B-Gewichte wurden nicht zum Loopen trainiert; Antwortqualität wird dort nicht validiert.
Kann man Self-Attention-Anteile jetzt gefahrlos streichen?
Nein, daraus folgt keine Freigabe: Der Trainingsgewinn ist bei 50,9M Parametern gezeigt; die eigene-Value-Richtung schlägt diese statische Kontrolle, wobei sich auch Projektionsstärke und Eingabeabhängigkeit unterscheiden; eine große Kosinus-Ausrichtung allein belegt keine Redundanz, und für produktive Modelle leiten die Autoren keine Sicherheit ab.
Sind veröffentlichte Fehleranteile damit wertlos?
Nicht wertlos, aber prozedurabhängig: Bei 50,1 Prozent Mehrfachbelegung setzt die Testreihenfolge die Pluralität. Die vier empfohlenen Checks (Mehrfachbelegung, Tie-Break-Permutation, geteilte Validierung, Differenz-Audit) helfen, die Belastbarkeit solcher Vergleiche zu prüfen.
Quellen
- Looping Deeper Without Growing the KV Cache: Recurrent Depth for Causal Encoder-Decoders (arXiv (Jiaqi Leng, Minshen Zhang, Zhaofeng Sun, Yu-Yang Qian, Peng Zhao, Hao Zhang; UC San Diego, Tsinghua, Nanjing), abgerufen 2026-11-12)
- Sanity Checks for Attention Surgery: Null Models and Matched Interventions for Representation-Motivated Design (arXiv (Basavaraj R M, Aryan Bharat Kumar), abgerufen 2026-11-12)
- Agreeing on the Answer but Not the Reason: Measurement Limits of LLM Reasoning Failure Taxonomies (arXiv (Madhu Sudhan Rao Beesetty, PayPal), abgerufen 2026-11-12)
Weitere Artikel
- Raschkas Gratis-Videokurs: Reasoning-Modelle von Grund auf selbst bauen
- DeepInfer: DeepSeek legt seine Inferenz-Engine offen
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.