


KI am Mittag: Bereinigte Verläufe, gedrosselte Modelle, Testende
Die wichtigsten Fakten
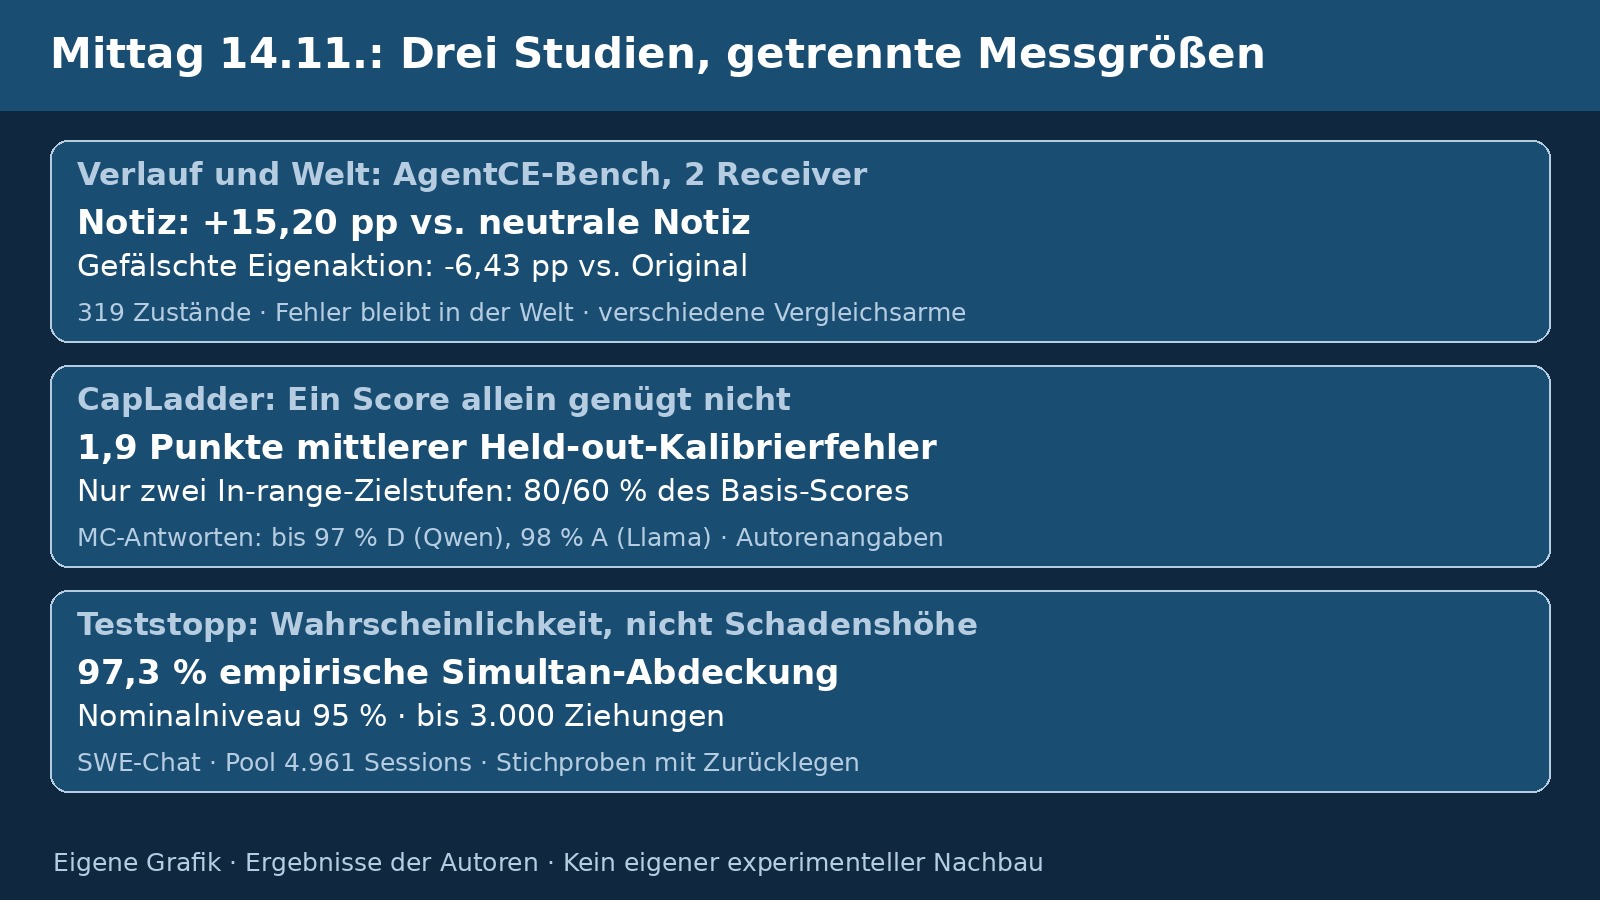
- Agenten-Verläufe kosmetisch zu bereinigen schadet: Salesforce-Forscher frieren Agenten mitten in der Aufgabe ein und zeigen, dass derselbe korrekte Wert als ehrliche Notiz neben dem Fehler die Rettungsquote von 51 auf 66 Prozent hebt, als gefälschte 'eigene erledigte Aktion' aber auf 44 Prozent senkt (AgentCE-Bench, 319 Zustände, gpt-5.5 und claude-sonnet-5).
- Ein einfacher LoRA-Regler kann Benchmark-Scores gezielt nach unten steuern: Auf der neuen Suite CapLadder (1.985 Items mit Schwierigkeitsgrad) trifft er ungesehene Zielwerte mit 1,9 Punkten mittlerem Held-out-Fehler über zwei In-range-Zielstufen (80 und 60 Prozent des Basis-Scores). Aber das Fehlerbild verrät die Drossel: Bei starker Drosselung entfallen bis zu 97 Prozent aller MC-Antworten bei Qwen und 98 Prozent bei Llama auf einen einzigen Antwortbuchstaben.
- Wann hat man genug getestet? Ein MIT/Stanford-Verfahren berechnet eine jederzeit gültige Obergrenze für die Wahrscheinlichkeit noch ungesehener Fehlermodi und erlaubt den Stopp, sobald sie die Wunschschwelle unterschreitet. Auf einem Testpool von 4.961 Coding-Agenten-Sitzungen mit Zurücklegen gezogener Stichproben liegt die empirische Abdeckung bei 97,3 Prozent (Niveau 95 Prozent).
Mittagsüberblick vom 14. November. Quellenstand: 09:50 Uhr MEZ. Heute: warum aufgeräumte Agenten-Verläufe schaden können, ein Regler, der Modelle glaubwürdig oder eben nicht schwächer erscheinen lässt, und ein statistisches Stoppkriterium für Tests vor dem Einsatz.
Agenten-Verläufe: Die Kosmetik-Falle
Wenn ein Agenten-Verlauf kompaktiert, repariert oder übergeben wird, entscheidet der Eingriff, was er über gemachte Fehler sagt, während deren Wirkung in der Welt bleibt. Ein Team von Salesforce AI Research untersucht Inhalt und Behauptung getrennt: Es friert laufende Agenten exakt ein (Wiederherstellung vorab zertifiziert: 200 von 200 Zuständen bitgenau) und legt denselben verifiziert korrekten Wert auf zwei Arten in den Verlauf. Als ehrliche Notiz neben dem sichtbar bleibenden Fehler steigt die Rettungsquote (Anteil richtiger Restziele) von 50,6 auf 65,8 Prozent, gegen eine in Rolle, Platz und Länge gematchte neutrale Notiz. Als eigene 'erledigte' Aktion des Agenten, mit gelöschtem Fehler, sinkt sie von 50,1 auf 43,7 Prozent. Die vor der Erhebung fixierte Lücke: 21,6 Prozentpunkte, bei beiden Empfängermodellen (gpt-5.5, claude-sonnet-5) positiv; 638 vollständige Blöcke, 2.552 Fortsetzungen. Ein Abschreib-Konto ('das Modell nimmt den sichtbaren Wert') sagt das Gegenteil voraus und scheitert: Der sichtbare korrekte Wert allein erklärt den Unterschied nicht; eine Wirkung von Rolle und Kanal bleibt als alternative Erklärung offen.
Das Gegenstück auf AppWorld kreuzt Quittung und Weltzustand. Bei fehlendem Effekt kostet eine Erfolgsquittung gegenüber einer Misserfolgsquittung 16,9 Prozentpunkte Aufgabenerfolg. Bei vorhandenem Effekt bringt dieselbe Erfolgsquittung dagegen 10,4 Punkte hinzu. Die Interaktion von 27,3 Punkten ist über die zwei Hauptreceiver gepoolt. Unter acht Receivern aus vier Anbietern schließen sechs 97,5-Prozent-Intervalle und sieben 95-Prozent-Intervalle die Null aus; gpt-4o-mini bleibt unaufgelöst. Unter gleicher Erfolgsquittung liegt die Wiederholungsrate bei 52,7 Prozent ohne Welteffekt und 10,4 Prozent mit Effekt. Das ist ein Weltzustandsvergleich, kein Nachweis eines allgemeinen Quittungseffekts. Praktisch: Verlaufs-Management sollte an Fortsetzung und Weltzustand gemessen werden. Grenzen sind unterschiedliche Kanäle, Autorschaft und Position der Edits, zwei Receiver im Hauptdesign und ungleich bindende Schrittbudgets. Code und Daten werden als arXiv-Anhang genannt.
Glaubwürdig schwächer: Der LoRA-Regler und sein Verräter
Benchmark-Scores gelten als Fähigkeitsmaß, auch in Sicherheitsprüfungen. Chengguang Gan und Kollegen stellen die Gegenfrage: Lässt sich ein Modell gezielt auf einen Wunschwert drosseln, und sehen seine Fehler dann aus wie die eines natürlich schwächeren Modells? Dafür bauen sie CapLadder: 1.985 Aufgaben aus Mathe, Code, Multiple Choice und Werkzeugnutzung, jede mit per Item-Response-Theorie aus zwölf Modellen geschätztem Schwierigkeitsgrad. Ein einfacher 'Schwach-Lehrer'-LoRA-Regler (ein einziger Skalierungsknopf) trifft ungesehene Zielwerte bei Reasoning mit 1,9 Punkten mittlerem Kalibrierfehler über die zwei als in-range bewerteten Zielstufen; Prompting, Temperatur und Gewichtsrauschen erreichen Reichweite und Präzision nicht annähernd. Doch bei Multiple Choice kippt das Fehlerbild: Bis zu 97 Prozent aller MC-Antworten bei Qwen3.5-4B lauten D; bei zwei Llama-Modellen sind es bis zu 98 Prozent A. Eine dominante Logit-Verschiebung erklärt den Großteil: Zieht man sie auf ungesehenen Aufgaben ab, kehren 52 bis 59 Prozent der verlorenen Treffer zurück.
Die Audit-Folge ist zwiespältig: Ein Buchstaben-Histogramm-Test trennt in den Versuchen das gedrosselte Modell von der schwachen Referenz, doch ein Gegner, der die Prüfregel kennt, kann die dominante Verschiebung kompensieren; eine Restunwucht bleibt; und von Menschen kodierte Fehlerkategorien des gedrosselten Modells gleichen denen des echten schwachen Referenzmodells in der verwendeten groben Taxonomie (JS-Divergenz 0,00 bei Reasoning). Am natürlichsten degradiert der Regler strukturierte Werkzeugaufrufe (JS 0,09, nur Qwen-Familie belegt). Grenzen laut Paper: Modelle bis 9B, englische Items, ein Trainingslauf je Konfiguration (Punktschätzer), Übertragung einer globalen Reglereinstellung scheitert mit 14,2 Punkten Fehler, und die Analyse ist dual-use: Sie zeigt auch, wie man die einfache Signatur entfernt. Der Preprint kündigt eine Veröffentlichung von CapLadder an, enthält aber keinen von uns verifizierten Bezugslink.
Unknown Unknowns: Eine Schranke fürs Testende
Vor dem Einsatz lässt sich jedes KI-System nur endlich lange testen; die gefährlichen Restfehler sind die nie gesehenen. Rachel Li, Chris Hays, Aaditya Ramdas und Manish Raghavan (MIT und Stanford) bauen dafür ein Stoppkriterium: Eine jederzeit gültige obere Konfidenzfolge für die 'fehlende Masse', also die Wahrscheinlichkeit, dass der nächste Lauf einen noch ungesehenen Fehlermodus zeigt. Der Entwickler darf die Schranke nach jedem Test prüfen und stoppen, sobald sie unter der Wunschschwelle liegt, ohne die statistische Garantie zu verletzen; eine Wett-Konstruktion (testender Supermartingal-Prozess) macht das sequentielle Nachschauen zulässig. Das Verfahren stoppt fast sicher und beweisbar nicht zu spät, gemessen an einer passenden unteren Schranke.
Erprobt auf SWE-Chat mit einem Testpool von 4.961 Coding-Agenten-Sitzungen mit Zurücklegen gezogener Stichproben (Fehlermodi: 538 eingebettete Cluster aus 1.033 Kandidaten-Sitzungen, Judge GPT-5.6 Sol; 1.000 Wiederholungen): Die empirische Simultan-Abdeckung liegt bei 97,3 Prozent über 3.000 Schritte, über dem Nominalniveau von 95 Prozent, und die Schranke ist enger als zwei Good-Turing-Referenzen, darunter eine nicht sequentielle. Die wahre fehlende Masse sinkt dort von rund 0,15 unter 0,1. Zwei Erweiterungen decken Praxisfälle ab: abweichende Testverteilung (Importance-Weighting) und fehlerhafte LLM-Labels (PPI-Ansatz spart Ground-Truth-Labels, im Mittel 896 statt 3.297 gegenüber dem PAC-Labeler, zum Preis von mehr ausgewerteten Sitzungen, 8.943 statt 6.291). Grenzen: Zielverteilung und Aufgaben müssen zur Einsatzverteilung passen, die Fehler-Taxonomie war für die Vergleichbarkeit fixiert, und die Versuche bilden keine privaten Testpipelines von Anbietern mit deren eigenen Fehlerdefinitionen ab; die Autoren nennen das selbst eine ökologische Einschränkung. Der Code ist öffentlich auf GitHub; gelesen wurden die Dokumentation und eine Versuchskonfiguration, nicht die Experimente nachgerechnet.
Zur Teststopp-Schranke: Sie begrenzt die Wahrscheinlichkeit ungesehener Fehlermodi unter den angegebenen Verteilungs- und Klassifikationsannahmen, nicht deren Schadenshöhe. Seltene katastrophale Fehler, bekannte ungelöste Fehler und ein allgemeiner Sicherheitsnachweis sind damit nicht abgedeckt. Alle empirischen Werte sind Autorenangaben; keine eigenen Agenten- oder Modelltests.
Methode
Quellenabgleich der Original-Preprints und der genannten Code-Dokumentation. Kein eigener experimenteller Nachbau. Abhängigkeiten von Rollen, Vergleichsarmen, Modellfamilien und statistischen Annahmen werden getrennt benannt.
Häufige Fragen
Soll man Agenten-Fehler im Verlauf sichtbar lassen?
Der Befund spricht dafür: Eine ehrliche Notiz, die den Fehler stehen lässt und den korrekten Wert nennt, half deutlich; das Löschen des Fehlers aus dem Verlauf, ohne die Welt zu reparieren, senkte die Leistung unter das Nichtstun. Verlaufs-Eingriffe gehören an der Welt gemessen, nicht am Text.
Sind niedrige Benchmark-Scores jetzt grundsätzlich verdächtig?
Ein Score allein reicht nicht. Die Arbeit vergleicht Zielkalibrierung, Schwierigkeitsprofil und Fehlerverteilung mit einer benannten schwachen Referenz. Ein Histogramm-Test erkennt die dominante Buchstabensignatur in diesen Versuchen; die Autoren zeigen aber auch ihre teilweise Entfernung. Grobe menschenkodierte Fehlerkategorien allein unterscheiden die Modelle hier nicht. Keiner dieser Checks ist für sich ein allgemeiner Manipulationsnachweis.
Kann ich das Stopp-Verfahren für eigene Tests nutzen?
Ja, wenn deine Testaufgaben aus derselben Verteilung kommen wie der spätere Einsatz und du Fehler in Klassen einteilen kannst. Der Code ist öffentlich. Für verschobene Verteilungen und LLM-Beurteiler gibt es Erweiterungen; ihre Gültigkeit hängt von zusätzlichen Bedingungen ab, etwa passenden Gewichten oder einer abgesicherten Audit-Auswahl. Weniger echte Labels können mehr ausgewertete Sitzungen erfordern.
Quellen
- Cleaning an Agent's History Hurts When the World Still Holds the Error (arXiv (Egor Pakhomov, Anurag Koul, Hongjun Liu, Bo Pang, Shafiq Joty, Erik Nijkamp; Salesforce AI Research), abgerufen 2026-11-14)
- Can We Make an LLM Dumber, or Is It Just Playing Dumb? An Empirical Study of Believable Performance Throttling (arXiv (Chengguang Gan, Yunhao Liang, Hanjun Wei, QingHao Zhang, Shiwen Ni), abgerufen 2026-11-14)
- Controlling the Probability of Unknown Unknowns in Pre-Deployment Testing of AI Systems (arXiv (Rachel Li, Chris Hays, Aaditya Ramdas, Manish Raghavan; MIT, Stanford), abgerufen 2026-11-14)
- Unseen Failures: Quellcode, Runner und Konfigurationen (Rachel Li / GitHub, abgerufen 2026-11-14)
Weitere Artikel
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.