


KI am Mittag: Beweis-Kosten, Risikoprofile, Akrasie-Argument
Die wichtigsten Fakten
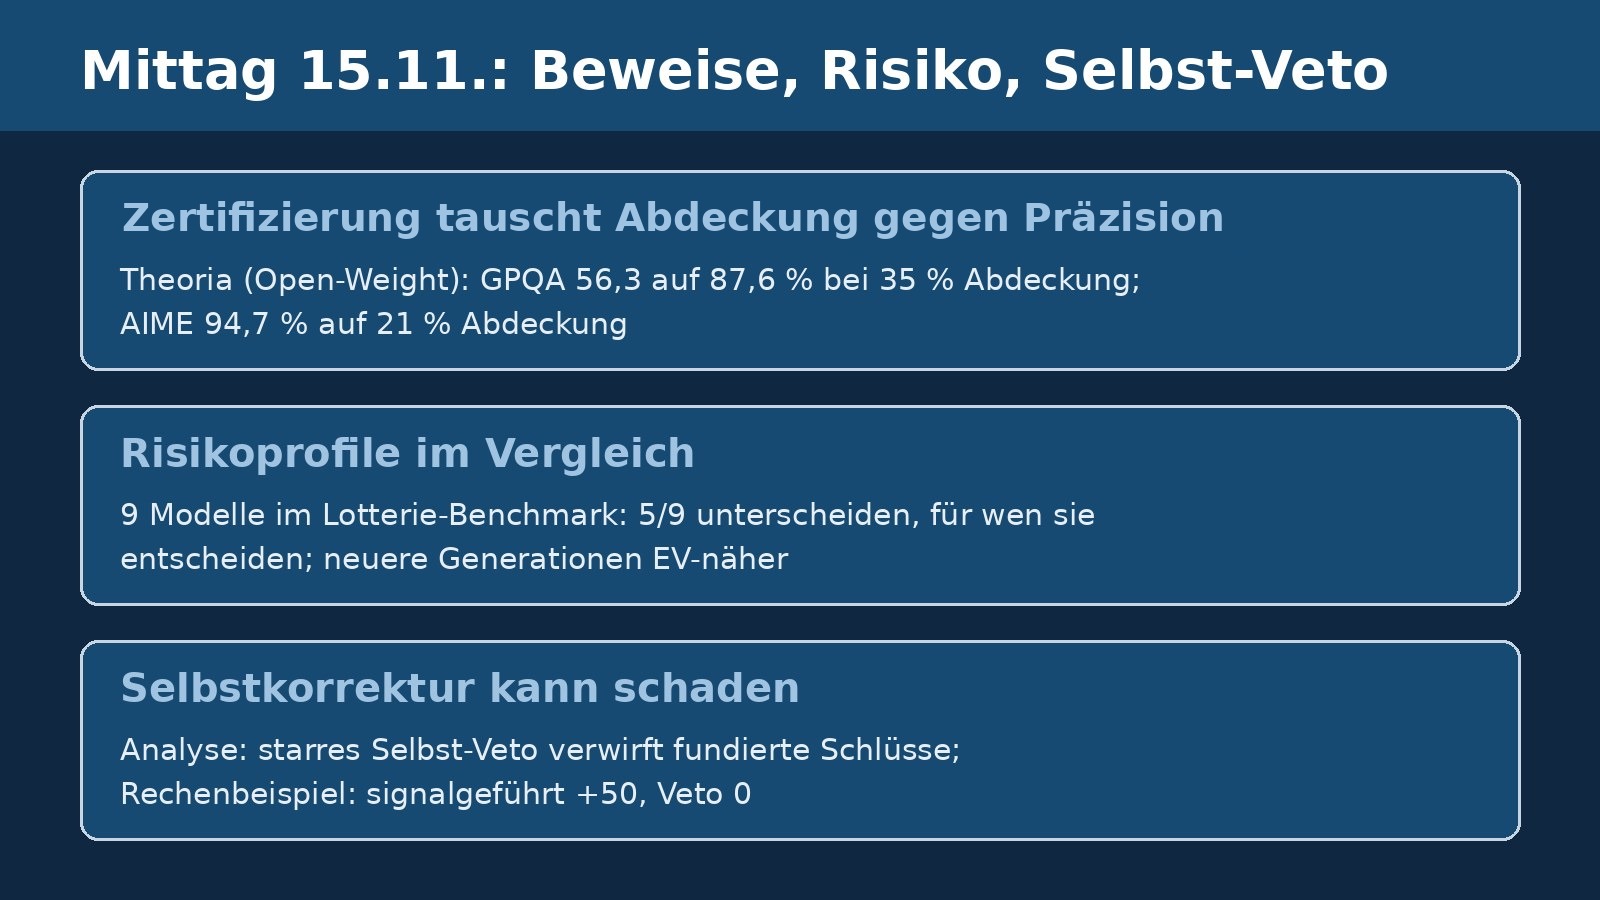
- Beweisprüfung ist ein Tauschgeschäft: Die Theoria-Pipeline (Open-Weight-Modelle) hebt die Trefferquote der ausgewählten Antworten bei GPQA von 56,3 auf 87,6 Prozent, beantwortet dabei aber nur 35 Prozent der Versuche; bei AIME 94,7 Prozent auf 21 Prozent Abdeckung. Gegen token-gematchtes Self-Consistency-Voting ist der Vorteil im Sample nicht aufgelöst (+4,8 Punkte, Intervall -8,2 bis +18,5).
- Risikoprofile wandern: Rethink Priorities misst neun aktuelle Modelle mit Lotterie-Aufgaben; fünf von neun unterscheiden, für wen sie entscheiden (stets am vorsichtigsten für Menschen), acht von neun reagieren auf externe Stakes. Über Generationen werden Modelle stabiler und Erwartungswert-näher; die Claude-Opus-Linie bleibt Ausnahme mit mehr Risikoaversion und Kontextsensitivität, Opus 5.5 fiel im Versuch durch massenhafte Antwortverweigerung auf.
- Selbstkorrektur kann schaden: Eine Argumentationsanalyse (Agolli, CUNY) zeigt an einem Rechenbeispiel, dass ein Agent mit internem Fehlersignal fundierte Schlüsse besser behalten kann, wenn er seine eigene negative Selbstbewertung manchmal ignoriert (signalgeführt +50 gegenüber 0 bei striktem Veto); ein allgemeiner Veto ist damit in dem Beispiel nicht die beste Regel.
Mittagsüberblick vom 15. November. Quellenstand: 09:50 Uhr MEZ. Heute: eine Betriebsanalyse schrittweiser Beweisprüfung auf Open-Weight-Modellen, ein Benchmark für Risikoverhalten von Sprachmodellen und eine philosophische Analyse, die einen Grundsatz der Selbstkorrektur infrage stellt.
Was kostet es, jede Antwort beweisen zu lassen?
Vier unabhängige Forscher um Abhinav Gupta untersuchen die Theoria-Pipeline: Ein Formalisierer schreibt die Antwort eines Lösers in getypte Schritte um, LLM-Judges prüfen jeden Schritt, ein Reparatur-Loop läuft vor der Entscheidung 'zertifiziert oder abgelehnt'. Auf Open-Weight-Stacks (Qwen3-14B, gpt-oss-20b, Phi-4) hebt die Zertifizierung die Trefferquote der ausgewählten Antworten deutlich: bei 100 GPQA-Fragen von 56,3 Prozent Basis auf 87,6 Prozent [Intervall 77,7 bis 95,8] in der starken Konfiguration, allerdings bei nur 35,0 Prozent beantworteten Versuchen. Bei AIME-2025 (30 Aufgaben) erreicht die starke Konfiguration 94,7 Prozent auf lediglich 19 Zertifizierungen aus 90 Versuchen; auf dem nahe an der Decke laufenden MATH-500 bleiben 0,2 bis 4,8 Punkte Gewinn bei 13,3 bis 26,7 Punkten Abdeckungsverlust. Das sind Auswahl-Effekte auf zertifizierten Teilmengen, keine zusätzlich gelösten Aufgaben. Der faire Vergleich mit Self-Consistency-Voting unter gleichem Ausgabe-Token-Budget (k = 8) endet unentschieden: 82,9 Prozent Präzision bei 35 Prozent Abdeckung gegen 87,6 Prozent der Pipeline; die gepaarte Differenz von +4,8 Punkten hat ein Intervall von -8,2 bis +18,5 und löst weder Überlegenheit noch Gleichwertigkeit auf.
Die Arbeit benennt zwei versteckte Betriebskosten. Erstens ist eine 'Ablehnung' selten eine bewusste Prüfungsentscheidung: In einem 100-Aufgaben-Diagnoselauf endeten 60 der 88 abgeschlossenen Fälle in ungültiger Formalisierung, 52 davon erreichten nie einen Judge; bei AIME-strong entfielen auf 90 Versuche 19 Zertifizierungen, 2 Ablehnungen und 69 Ausführungsfehler. Telemetrie muss Konstruktionsfehler, Judge-Ablehnung und Laufzeitfehler trennen. Zweitens klafft Antwort-Korrektheit und Beweisgültigkeit auseinander: Externe LLM-Prüfer ohne Antwortschlüssel akzeptierten nur 61,0 bis 67,6 Prozent der zertifizierten Ketten, während der Antwort-Abgleich 87,6 Prozent ergab; bei 25 von 105 Fällen stimmt die Antwort, während der Prüfer den Beweis ablehnt. Open-Weight-Prüferpaare akzeptieren 89 bis 94 Prozent der Ketten, stimmen aber kaum miteinander überein (Kappa nahe null), was Übereinstimmung, nicht Richtigkeit misst. Die Autoren fordern getrennte Berichte zu Ausführungsfehlern, Präzision der Auswahl und unabhängig geprüfter Beweisgültigkeit; eine menschliche oder Lean-Kernel-Grundwahrheit fehlt. Code und anonymisierte Laufprotokolle sind öffentlich (GitHub, Inhalt geprüft).
Wie risikobereit sind aktuelle Modelle?
Rethink Priorities hat neun aktuelle Modelle (Claude Opus 5 und Sonnet 5, GPT-5.6, Gemini 3.8 Flash, Llama 4 Maverick, Qwen3-8B, DeepSeek V4 Pro, Kimi K3, GLM-5.2) mit Lotterie-Aufgaben aus der Verhaltensökonomie vermessen: Sicherheitsäquivalente zwischen sicherer Option und 50:50-Wette, je 50 Wiederholungen. Ergebnisse im Detail: Fünf der neun Modelle unterscheiden, wem die Konsequenzen zufallen, und sind dabei stets am vorsichtigsten, wenn es um einen Menschen geht; Kimi schaltet für einen Menschen 1,82 Token früher auf die sichere Option als für sich selbst, Opus um 1,10. Acht von neun reagieren, wenn Token-Folgen an externe Stakes gekoppelt werden (Geld, GPU-Kerne, Verhaltenssteuerung); von 42 belastbaren Kontrasten überstehen 20 die Holm-Korrektur, 18 davon Richtung mehr Vorsicht. GPT-5.6 Sol reagiert in diesen Zellen auf keinen Begünstigten- oder Konsequenz-Wechsel. Bei steigenden Einsätzen (10 Dollar bis 10 Millionen) werden die vier Frontier-Modelle risikoaverser (Sonnet von 10 auf 24 Prozent Risikoprämie), während Qwen3-8B und Llama 4 über alle Skalen nahe am Erwartungswert bleiben.
Im Generationenvergleich (15 OpenAI-Modelle über fünf Generationen für Stabilität; sieben Familien alt gegen neu für Konsistenz) zeigt sich ein gekoppelter Trend: Neuere Modelle sind stabiler gegenüber Umformulierungen, konsistenter über Kontexte und näher am Erwartungswert; GPT rückt im Sicherheitsäquivalent von 7,57 (GPT-4.1) auf 9,49 (GPT-5.6, EV = 10). Die Analyse der Denkketten (13.538 Abweichungen, zwei externe Judge-Modelle) legt nahe, dass ältere Modelle den Erwartungswert meist korrekt berechneten, aber öfter dem Szenario folgten; neuere gehen direkter zur Rechnung. Zwei Gegenbeispiele: Die Opus-Linie bleibt risikoaverser und kontextsensitiver, und Opus 5.5 wurde komplett aus der Auswertung ausgeschlossen, weil es massenhaft Antworten verweigerte, bei Entscheidungen über das eigene System bis zu 100 Prozent der Aufrufe, abhängig von der Optionsreihenfolge (Autonomie-Aufgabe: 89 Prozent Verweigerung bei Wette zuerst, 1 Prozent bei sicherer Option zuerst); die Autoren nennen die Ursache ungeklärt und warnen vor einem Auseinanderdriften in Überverweigerung oder strikte Erwartungswert-Maximierung. Grenzen: nur 50:50-Wetten, A/B-Format, kein Nachweis, dass Lotterie-Verhalten agentisches Verhalten vorhersagt; die Verweigerungsursache bei Opus 5.5 ist unbekannt.
Darf ein Agent seine eigene Warnung ignorieren?
Die dritte Arbeit ist konzeptionell: Eno Agolli (CUNY Graduate Center) untersucht 'epistemische Akrasie', den Zustand, in dem ein System eine Schlussfolgerung behält, die seine eigene Selbstbewertung für ungerechtfertigt hält. Üblich ist die Regel, die Bewertung müsse die Schlussfolgerung verwerfen dürfen, etwa als Veto. Agollis Gegenargument: Bei Sprachmodellen kann der Prozess, der Schlüsse behält oder verwirft, Informationen nutzen, die der Selbstbewertung nicht zur Verfügung stehen. Er stützt das auf externe Befunde, darunter Studien, in denen einfache Klassifikatoren Modellfehler aus internen Zuständen besser lasen als die Selbstauskunft des Modells (in einem Fall Trenngüte 0,85 gegen 0,74) und dass formuliertes Vertrauen Enthaltungsentscheidungen nicht zuverlässig steuert; er betont selbst die Grenze: Gemessen wurde Antwort-Korrektheit, nicht die Stichhaltigkeit der Argumentation.
Das Kernstück ist ein Rechenbeispiel: 1.000 Fälle mit Warnung eines zu 90 Prozent zuverlässigen Gutachters, darunter 100 fundierte Schlüsse mit irreführender Warnung. Striktes Veto (jede gewarnte Schlussfolgerung aufgeben) erzielt 0 Punkte, bedingungsloses Behalten -800; ein Agent, dessen internes Signal bei 95 Prozent der fundierten und 5 Prozent der nicht fundierten Fälle auftritt, behält signalgeführt 140 Schlüsse und erzielt +50. Der Autor verallgemeinert die Schwelle: Signalgeführtes Behalten schlägt das Veto genau dann, wenn das Signal fundierte Fälle hinreichend besser trennt als die Warn-Quote es verlangt. Die Folgerung ist eng gefasst: Eine negative Selbstbewertung bleibt als Markierung für weitere Prüfung wertvoll, muss aber nicht die Lösch-Autorität besitzen; pauschales Erzwingen von Übereinstimmung zwischen Schluss und Bewertung kann die Fehlerkorrektur verschlechtern. Die Arbeit führt keine eigenen Experimente durch, skizziert aber vier prüfbare Testdesigns.
Häufige Fragen
Lohnt sich schrittweise Beweisprüfung im eigenen Stack?
Im getesteten Setup hing es vom Regime ab: Bei schwierigen Fragen mit Baseline-Trefferquoten um 50 Prozent stieg die Präzision der ausgewählten Antworten stark, bei fast gelöstem MATH-500 kaum. Gegen ein Voting mit gleichem Token-Budget war kein Vorteil belegt. Wer die Pipeline betreibt, muss Ausführungsfehler getrennt von Judge-Ablehnungen messen, sonst liest er Abdeckungsverlust als Prüfungsschärfe.
Sind neuere Modelle bei Risiko-Entscheidungen berechenbarer?
Innerhalb dieser Lotterie-Aufgaben ja: Sie antworteten stabiler und näher am Erwartungswert. Das ist zweischneidig: Wer Kontextsensitivität braucht (etwa Vorsicht bei rechtlichen Nebenbedingungen), bekommt sie bei den meisten getesteten Spitzenmodellen nicht; und fünf Modelle behandelten Entscheidungen für Menschen vorsichtiger als für sich selbst. Ob Lotterie-Verhalten Verhalten in echten Agenten-Einsätzen vorhersagt, ist offen.
Soll ein Agent bei eigener negativer Selbstbewertung seine Antwort verwerfen?
Die Analyse sagt: nicht als starre Regel. Wenn der behaltende Prozess ein verlässliches Fehlersignal hat, kann Behalten trotz Warnung besser abschneiden als Veto; die Warnung sollte dann weitere Prüfung auslösen statt Löschung. Das ist ein argumentatives Ergebnis mit Rechenbeispiel, keine Messung an einem realen System; die passenden Experimente sind erst skizziert.
Quellen
- When Is Proof-Step Verification Worth Its Cost? Operating Requirements of Certify-or-Decline Verification for Open-Weight Mathematical Reasoning (arXiv (Abhinav Gupta, Ben Slivinski, Yashica Patodia, Michael Saldivar; unabhängige Forscher), abgerufen 2026-11-15)
- Benchmarking AI risk behaviors (arXiv (Luhan Mikaelson, Robert Adragna, Emmett Brosowsky, Hayley Clatterbuck; Rethink Priorities), abgerufen 2026-11-15)
- Can an AI Agent Be Epistemically Akratic? Higher-Order Evidence & the Limits of Self-Correction (arXiv (Eno Agolli; CUNY Graduate Center, Saul Kripke Center), abgerufen 2026-11-15)
Weitere Artikel
- Preprint: Alle 16 untersuchten evolvierten Agenten verloren auch zuvor gelöste Aufgaben
- OpenAI meldet KI-Beweise: ETH widerlegt, Kakeya gelöst, QCD rigoros
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.