


KI am Morgen: OpenAI testet Helfer an Alltagsaufgaben
Die wichtigsten Fakten
- OpenAI hat LifeVal veröffentlicht, einen Test für Alltagsaufgaben wie Betreuung, Behördengänge und Essensplanung. Die gezeigten Ergebnisse stammen von OpenAI selbst und sind nicht unabhängig geprüft.
- NorthCUA ist eine offene Modellfamilie (Apache 2.0), die Computer und Browser per Maus und Tastatur bedient. Die Erfolgswerte stammen aus dem eigenen Bericht und wurden laut Modellkarte nicht an den veröffentlichten Gewichten nachgemessen.
- Flower Labs verspricht mit Endeavor 1.1 Rechenleistung auf GPUs in der EU und das Recht, Antworten und Denkspuren zu behalten und für eigene Modelle zu nutzen. Auch diese Angaben stammen vom Anbieter.
Morgenüberblick vom 3. November 2026. Quellenstand: 06:37 Uhr MEZ. Drei Meldungen zum Frühstück: OpenAI misst seine Modelle jetzt an Aufgaben aus dem Alltag, eine offene Modellfamilie steuert Computer per Maus und Tastatur, und ein europäischer Anbieter verspricht mehr Kontrolle über die eigene KI-Arbeit.
OpenAI testet ChatGPT am Alltag
OpenAI hat am 2. November LifeVal vorgestellt, einen Test für Aufgaben, bei denen sich Menschen nach eigenen Angaben am meisten Hilfe von KI wünschen. Als Grundlage nennt das Unternehmen zwei große Zeitverwendungsstudien (die American Time Use Survey und die Multinational Time Use Study) sowie eine eigene demografisch repräsentative Umfrage unter 3.995 Teilnehmenden. Die Aufgaben decken Betreuung, Gesundheit, Bildung, Haushaltsverwaltung, persönliche Finanzen, Einkaufen und Behördengänge ab.
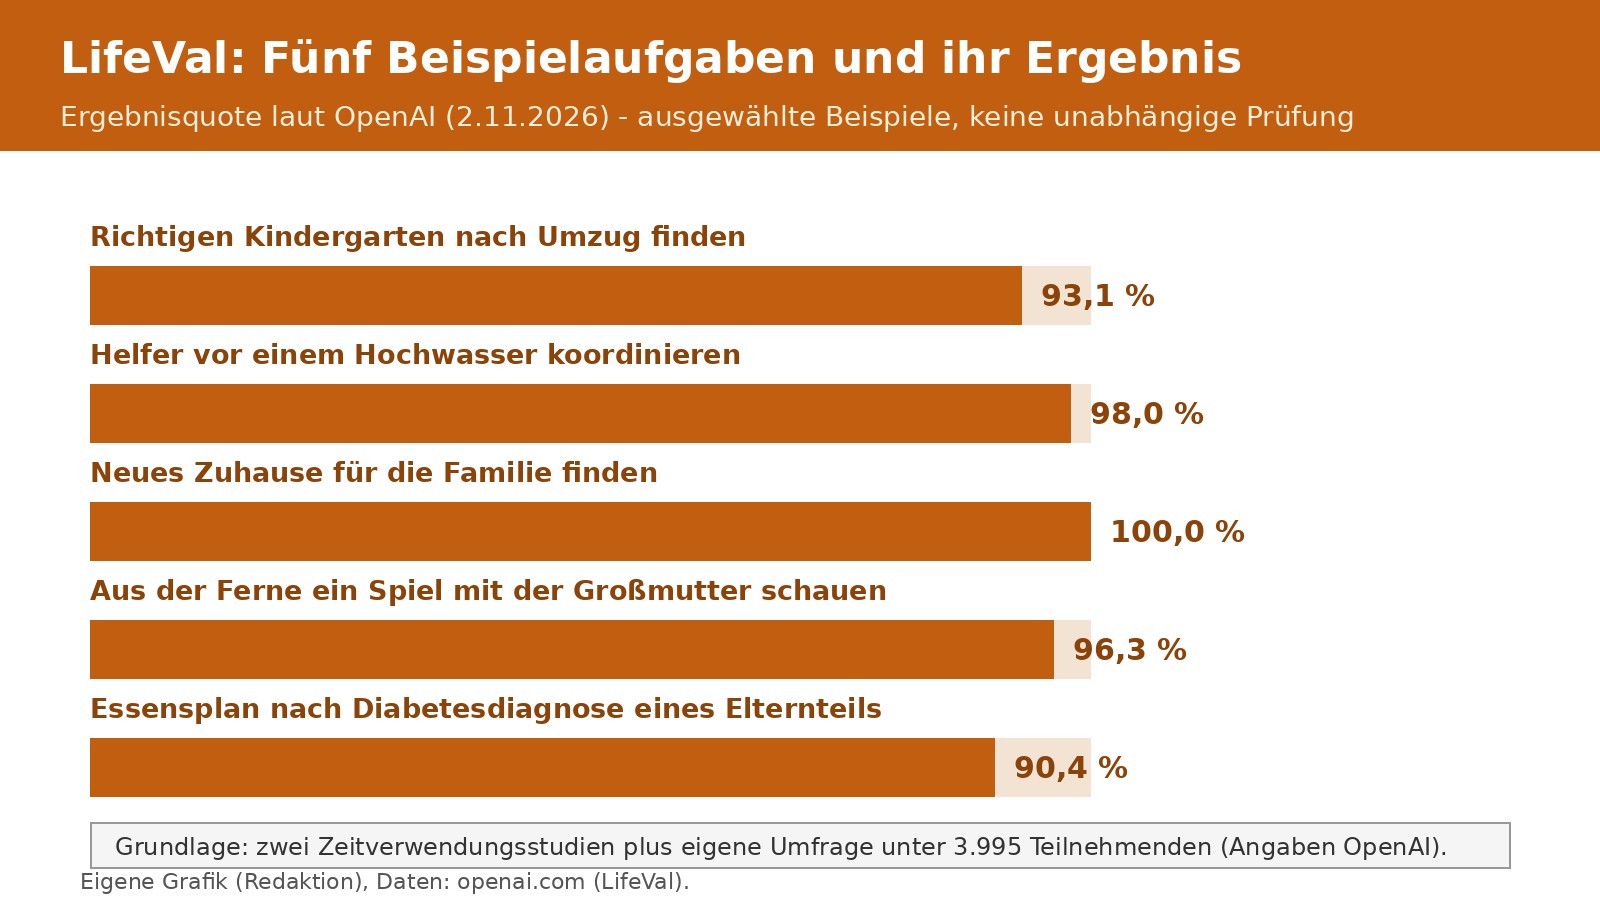
Auf seiner Seite zeigt OpenAI fünf Beispiele mit Ergebnisquoten seiner aktuellen Modelle: den richtigen Kindergarten nach einem Umzug finden (93,1 Prozent), Helferinnen und Helfer vor einem Hochwasser koordinieren (98,0 Prozent), ein neues Zuhause für die Familie finden (100 Prozent), aus der Ferne ein Spiel mit der Großmutter schauen (96,3 Prozent) und einen Essensplan nach einer Diabetesdiagnose erstellen (90,4 Prozent). OpenAI schreibt, es nutze den Test seit einem Jahr intern, um die Modelle bei Browser-Nutzung, Computer-Nutzung und Verknüpfungen mit anderen Diensten zu verbessern - weg vom Chatfenster, hin zu einem Assistenten, der Dinge erledigt.
Wichtig zur Einordnung: Alle Zahlen stammen von OpenAI selbst, eine unabhängige Prüfung gibt es nicht. Das Unternehmen zeigt nur ausgewählte Beispiele und veröffentlicht auf der Seite weder ein Gesamtergebnis noch einen Vergleich mit Modellen anderer Anbieter. Sekundärberichte (etwa von neuralbrew und unite.ai) geben dieselben Angaben wieder.
Offenes Modell steuert Rechner per Maus
Mit NorthCUA ist eine offene Modellfamilie erschienen, die Desktop-Programme und Browser eigenständig bedient: Nano mit 9 Milliarden Parametern, Mini mit 35 Milliarden und Pro mit 397 Milliarden Parametern (davon 17 Milliarden pro Token aktiv), aufgebaut auf Qwen3.5 und unter der Apache-2.0-Lizenz veröffentlicht. Laut Modellkarte meldet das Team in seinem 121-seitigen technischen Bericht Erfolgsquoten von 78,90 bis 88,64 Prozent auf dem Desktop-Test OSWorld-Verified und 67,16 bis 73,89 Prozent auf dem Web-Test WebArena-Verified, je nach Modellgröße.
Die Modellkarte auf Hugging Face weist ungewöhnlich deutlich auf die Grenzen hin: Die Werte stammen aus dem Bericht und wurden nicht an den veröffentlichten Modelldateien nachgemessen; für den neueren Test OSWorld 2.0 liegt nur ein mittlerer Teilpunktestand vor (66,80 Prozent für Pro), und beim WebTestBench stehen die NorthCUA-Ergebnisse noch aus. Eine im Umlauf befindliche Behauptung, NorthCUA schlage geschlossene Billionen-Parameter-Modelle, lässt sich an der Modellkarte nicht belegen.
Flower Labs: KI-Ausgaben behalten und prüfen
Das europäische Unternehmen Flower Labs hat heute Endeavor 1.1 vorgestellt, sein drittes Modell in diesem Jahr. Nach eigener Rechnung erreicht es mit 97,18 Punkten den höchsten Wert in einem selbst definierten Benchmark-Mix (gleich gewichtet: GPQA, AIME 2026, HumanEval und IFEval) und liegt damit vor GPT-5.6 Sol (96,25) und Claude Fable 5 (95,30). Gegenüber der Vorgängerversion steigt GPQA von 92,0 auf 94,4 und HumanEval von 98,2 auf 99,9 Punkte. Alle Werte sind Anbieterangaben ohne unabhängige Prüfung, und der Benchmark-Mix stammt vom Anbieter selbst.
Sachlich neu: Die Rechenleistung lässt sich wahlweise auf GPUs in der Europäischen Union buchen, mit Dienstgütevereinbarungen und Support von Flower. Das Modell verarbeitet jetzt auch Bildeingaben, und Kunden sollen die Denkspuren des Modells einsehen sowie alle Ausgaben und Spuren behalten und zum Trainieren eigener Modelle nutzen dürfen. OpenAI zeige nur Zusammenfassungen der Denkspuren und Anthropic halte sie meist zurück, schreibt Flower - das ist die Darstellung des Anbieters. Weitere regionale Angebote für Großbritannien, den Nahen Osten, Asien und Afrika sind angekündigt.
Häufige Fragen
Ist LifeVal ein unabhängiger Test?
Nein. OpenAI hat den Test selbst gebaut und berichtet die Ergebnisse selbst. Gezeigt werden nur fünf ausgewählte Beispielaufgaben; ein Gesamtergebnis, ein Vergleich mit anderen Anbietern und eine Fremdprüfung fehlen.
Kann ich NorthCUA selbst ausprobieren?
Die Modellgewichte stehen unter der Apache-2.0-Lizenz auf Hugging Face (Organisation beipo-ai), der kleinste Ableger hat 9 Milliarden Parameter. Beachten Sie: Die berichteten Erfolgsquoten wurden laut Modellkarte nicht an diesen veröffentlichten Dateien nachgemessen.
Was bedeutet EU-Inferenz bei Endeavor 1.1?
Die Rechenleistung für das Modell läuft auf GPUs in der Europäischen Union, mit Dienstgütevereinbarungen und Support von Flower Labs. Laut Anbieter dürfen Kunden die Ausgaben und Denkspuren behalten und damit eigene Modelle trainieren.
Quellen
- Introducing LifeVal (OpenAI, abgerufen 2026-11-03)
- OpenAI LifeVal: Everyday tasks as a personal assistant benchmark (neuralbrew, abgerufen 2026-11-03)
- OpenAI's LifeVal Evaluation Tests AI on Practical Everyday Tasks (unite.ai, abgerufen 2026-11-03)
- NorthCUA-Pro (Modellkarte) (Hugging Face (beipo-ai), abgerufen 2026-11-03)
- NorthCUA: Open 397B Computer-Use Model (Alert) (AI Weekly, abgerufen 2026-11-03)
- Introducing Endeavor 1.1 (Flower Labs, abgerufen 2026-11-03)
Weitere Artikel
- Walmart öffnet sich für Shopping-Agenten, mit festen Regeln
- Yelp ruft jetzt für dich im Restaurant an
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.