


KI am Morgen: Agenten testen, Karten streamen
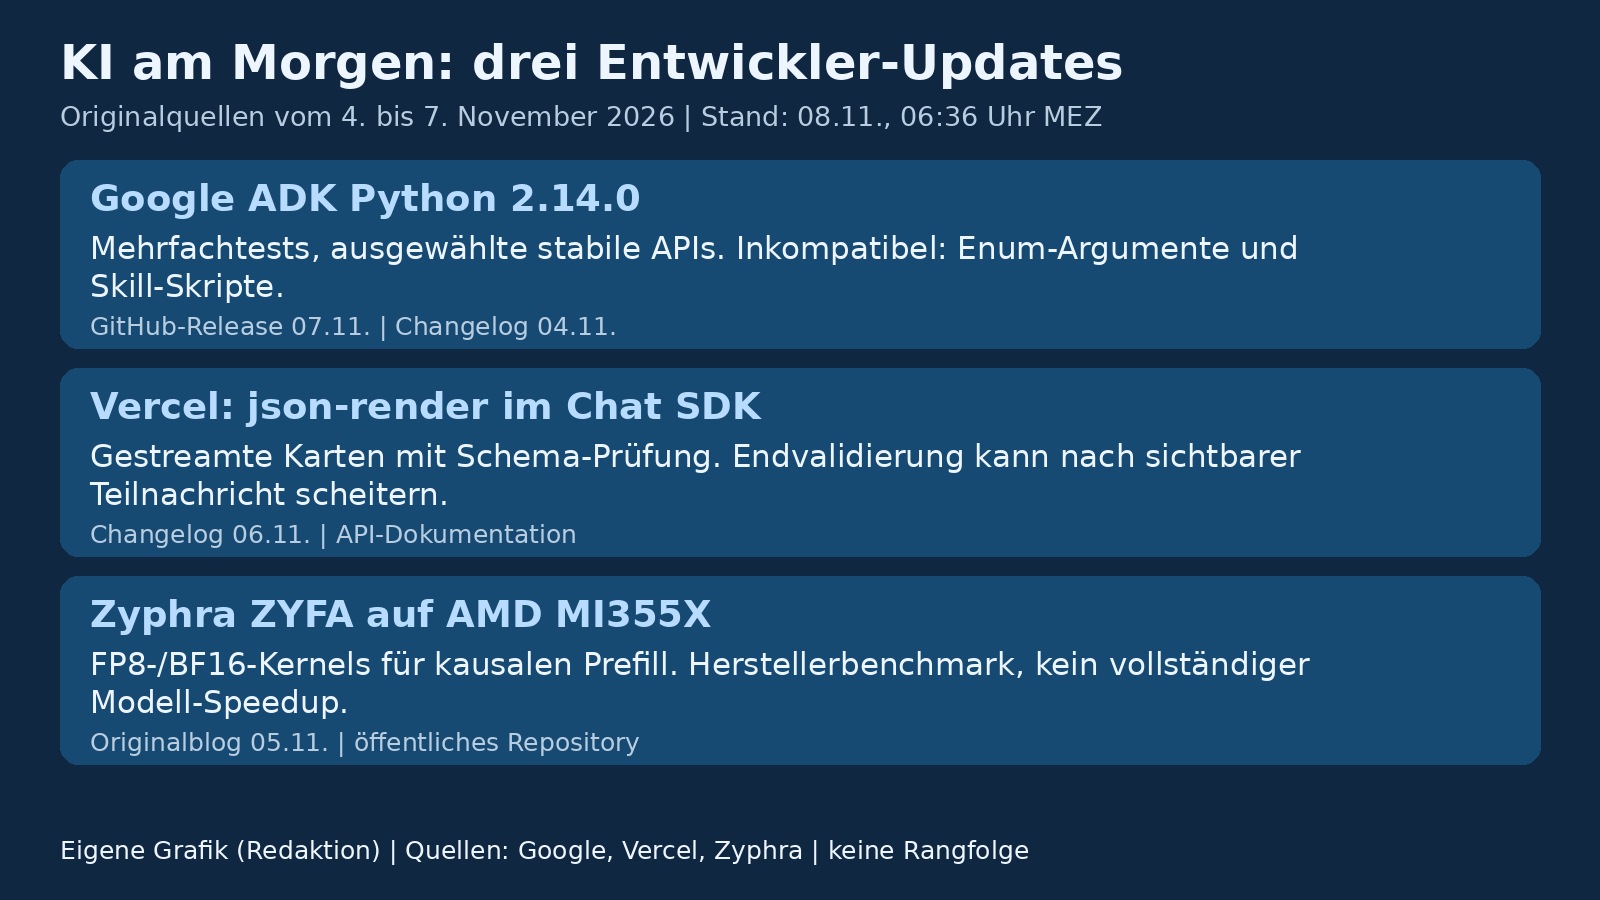
Die wichtigsten Fakten
- Google ADK Python 2.14.0 stabilisiert ausgewählte Module und ergänzt wiederholte Tests. Beim Update ändern sich unter anderem Enum-Argumente und die Ausführung von Skill-Skripten.
- Vercels json-render erzeugt Chat-SDK-Karten aus JSON und aktualisiert sie während der Ausgabe. Die abschließende Schema-Prüfung kann erst nach einer bereits sichtbaren Teilnachricht scheitern.
- Zyphra meldet für ZYFA 1,16- bis 1,76-fachen FP8-Kerneldurchsatz gegenüber AITER auf erfassten Modellaktivierungen. Das ist kein Speedup eines vollständigen Sprachmodells.
Morgenüberblick vom 8. November 2026. Quellenstand: 06:36 Uhr MEZ. Drei Entwickler-Updates aus den vergangenen Tagen: Google ergänzt Tests und Integrationen für Agenten, Vercel lässt strukturierte Chat-Karten während der Generierung wachsen, und Zyphra untersucht schnellere Attention-Kernels auf AMD-Hardware.
Google ADK: Mehrfachtests und Änderungen beim Umstieg
Google hat ADK Python 2.14.0 als GitHub-Release bereitgestellt. Die Releaseveröffentlichung trägt den 7. November, der zugehörige Changelog den 4. November. Laut diesen Notizen verlassen ausgewählte Ausführungsumgebungen, die A2A-Integration sowie App-, Evaluations- und Simulationsmodule den experimentellen Status. Das betrifft benannte Teile des Python-Frameworks, nicht pauschal sämtliche ADK-Komponenten oder den A2A-Standard.
Mit MultiRunConfig und Parallelitätssteuerung können Entwickler jeden Testfall mehrfach ausführen und Ergebnisse zusammenfassen. ToolArgsMatcher vergleicht Werkzeugargumente exakt, ohne Beachtung der Großschreibung, mit numerischer Toleranz oder per semantischem Modellurteil. TeamsRunner bindet Microsoft-Teams-Chats und -Kanäle an; ein OpenAIDecisionsClassifier ergänzt Entscheidungen über Workflows und Werkzeugfreigaben. Beim Umstieg sind aber Anpassungen nötig: Enum-Argumente kommen nun als Enum-Mitglieder statt als rohe Zeichenketten an. Im Umgebungsmodus nimmt RunSkillScriptTool keine freie command-Zeichenkette mehr an, sondern strukturierte Argumente und validierte Skriptpfade. Das ist eine konkrete Schnittstellenänderung, keine allgemeine Sicherheitsgarantie.
Vercel: Chat-Karten wachsen während der Generierung
Vercel beschreibt in seinem Changelog vom 6. November eine Verbindung von Chat SDK und json-render. Der Agent schreibt eine JSON-Spezifikation aus einem typisierten Komponentenkatalog; daraus entsteht eine Karte, die Adapter in das native Format der jeweiligen Plattform übertragen, etwa Slack Block Kit oder Teams Adaptive Cards. Zum Katalog gehören unter anderem Tabellen, Diagramme und Schaltflächen.
streamCard veröffentlicht eine erste Karte, sobald deren Wurzelelement Inhalt hat, und bearbeitet die Nachricht mit eintreffenden Elementen weiter. Standardmäßig geschieht das höchstens einmal je 500 Millisekunden. Die Dokumentation nennt eine wichtige Grenze: Scheitert die abschließende Validierung, kann bereits eine Teilnachricht sichtbar sein. toCard prüft Schema und Struktur, aber nicht den Wahrheitsgehalt der Inhalte. Plattformgrenzen bleiben ebenfalls bestehen: Slack wandelt laut Vercel beispielsweise eine zweite Tabelle in einen Codeblock um; mit expliziten limits lässt sich eine solche Spezifikation stattdessen ablehnen.
Zyphra meldet schnellere Prefill-Kernels auf MI355X
Zyphra stellt im Originalbeitrag vom 5. November ZYFA vor: FP8- und BF16-Attention-Kernels für AMD Instinct MI355X. Sie bearbeiten den kausalen Vorwärtsdurchlauf beim Prefill, also die Verarbeitung des Eingabetextes vor der Generierung. Für FP8 meldet Zyphra auf Aktivierungen aus jeweils einer Schicht von Mistral-7B, Qwen3-8B und DeepSeek-V2-Lite bei 16K Tokens den 1,16-, 1,17- und 1,76-fachen Durchsatz gegenüber den jeweiligen AITER-Standardkernels. Gemessen wurde unter anhaltender Last nach dem Aufwärmen.
Die Zahlen sind Herstellermessungen, keine unabhängige Bestätigung und kein vollständiger Modellvergleich. Der Blog nennt einen einzelnen Knoten mit acht MI355X, ROCm 7.2.3 und AITER 0.1.19 als Versuchsumgebung. Zufallsdaten liefern andere Verhältnisse als reale Aktivierungen, weil der GPU-Takt von den Operanden abhängt. Laut README fehlen unter anderem Decoding, paged KV-Caches, unterschiedlich lange Sequenzen im selben Batch und der Rückwärtsdurchlauf. Der öffentlich lesbare Code ist damit ein spezialisierter Prefill-Baustein, kein universeller Ersatz für jede Attention-Implementierung.
Häufige Fragen
Ist mit ADK 2.14.0 das gesamte Framework stabil?
Die Release Notes erklären bestimmte Module und Integrationen für stabil. Daraus folgt weder ein stabiler Status für jedes ADK-Feature noch eine Aussage über die Entwicklung des A2A-Standards insgesamt. Zudem enthält das Update inkompatible Änderungen.
Verhindert die Kartenvalidierung falsche KI-Aussagen?
Nein. toCard prüft Komponenten-Props und Struktur gegen ein Schema. Ob die Inhalte stimmen, ist eine andere Frage. Bei gestreamten Karten kann ein Fehler erst nach Veröffentlichung einer Teilnachricht auffallen.
Beschleunigt ZYFA ein komplettes Modell um den Faktor 1,76?
Das ist nicht belegt. Der Höchstwert stammt aus Zyphras FP8-Kernelmessung auf einer erfassten DeepSeek-V2-Lite-Schicht bei 16K Tokens auf MI355X. Decoding und weitere Ausführungsformen sind nicht abgedeckt.
Quellen
- ADK Python v2.14.0: Release Notes (Google / GitHub, abgerufen 2026-11-08)
- Chat SDK agents can now stream generative UI with json-render (Vercel, abgerufen 2026-11-08)
- @json-render/chat: API-Dokumentation (json-render, abgerufen 2026-11-08)
- ZYFA: Fast and Accurate FP8 Attention on AMD MI355X (Zyphra, abgerufen 2026-11-08)
- Zyphra/zyfa: README und Implementierung (Zyphra / GitHub, abgerufen 2026-11-08)
Weitere Artikel
- Wie Claude träumt: Anthropic erklärt das Gedächtnis seiner Agenten
- Oumi FAiE: Ein Agent, der KI-Agenten baut, trainiert und verbessert
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.