


KI am Morgen: Benchmarks altern, Adapter lernen
Die wichtigsten Fakten
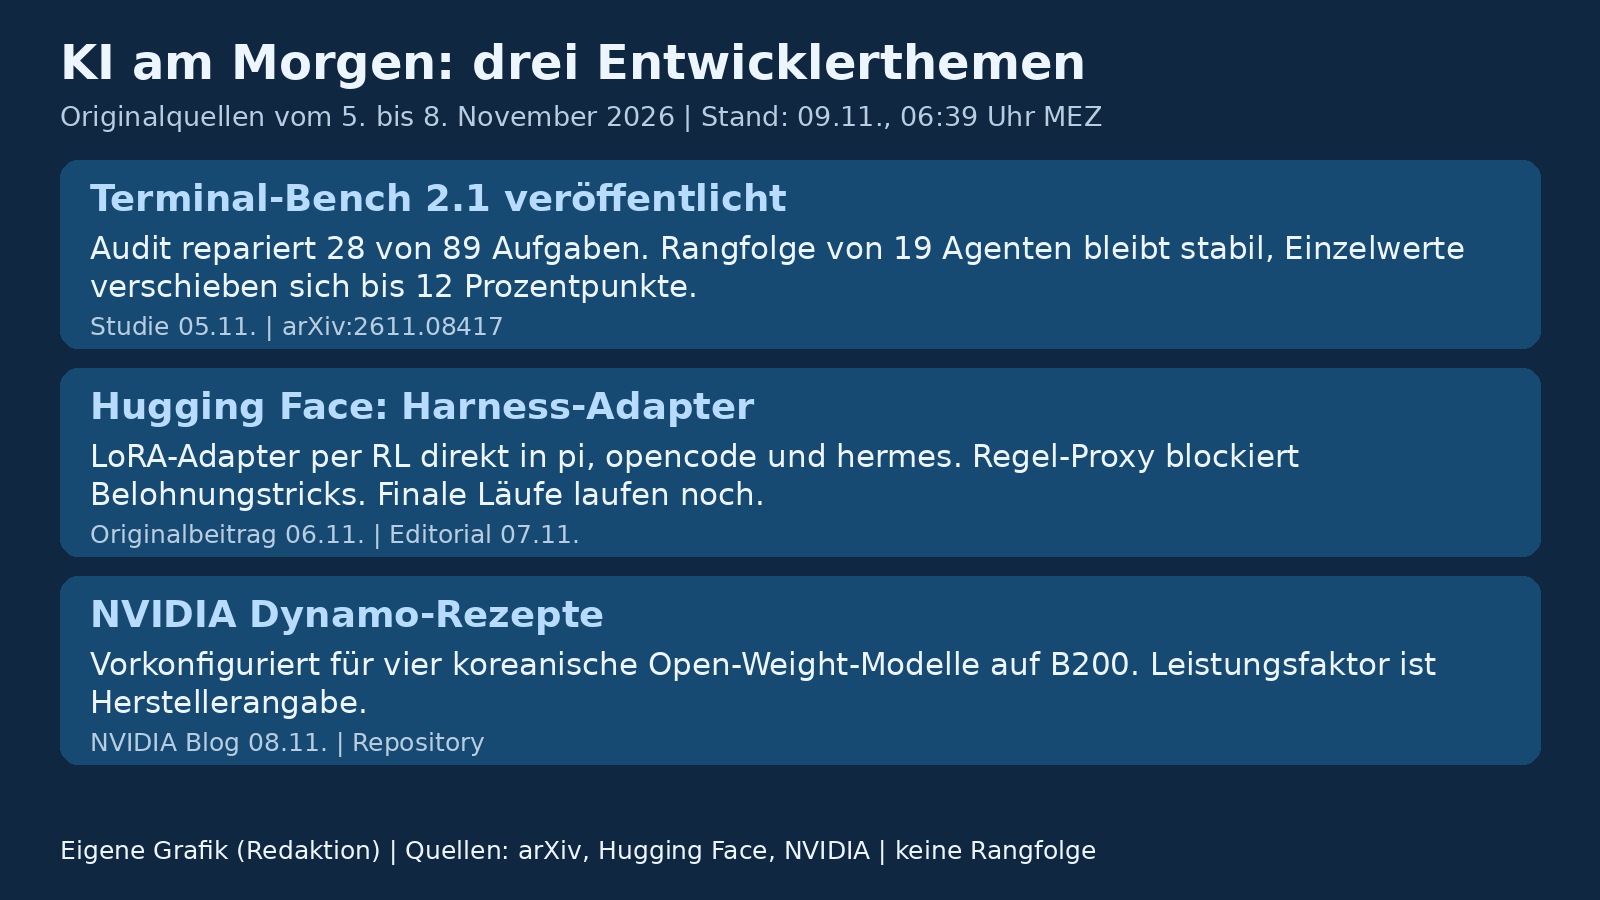
- Ein Audit fand Mängel in 28 von 89 Terminal-Bench-2.0-Aufgaben; die reparierte Version 2.1 ist öffentlich. Die Rangfolge von 19 Agenten bleibt stabil, einzelne Werte verschieben sich um bis zu 12 Prozentpunkte.
- Hugging Face trainiert kleine LoRA-Adapter per Verstärkungslernen direkt in den Agenten-Umgebungen pi, opencode und hermes. Ein Regel-Proxy blockiert Belohnungstricks; die finalen Läufe sind noch im Gang.
- NVIDIA veröffentlicht vorkonfigurierte Dynamo-Einsatzrezepte für vier offene koreanische Modelle auf B200-GPUs. Der genannte Leistungsfaktor ist eine Herstellerangabe ohne bezifferte Vergleichsbasis.
Morgenüberblick vom 9. November 2026. Quellenstand: 06:39 Uhr MEZ. Drei Entwicklerthemen aus den vergangenen Tagen: Forschende reparieren einen etablierten Coding-Benchmark und veröffentlichen ihn als Version 2.1, Hugging Face trainiert kleine Adapter direkt im Inneren von Coding-Agenten, und NVIDIA liefert fertige Einsatzrezepte für vier offene Modelle aus Korea.
Terminal-Bench 2.1: Ein Drittel der Aufgaben brauchte Reparatur
Ein Team um E. Kelly Buchanan (Stanford University) und Christopher Ré hat Terminal-Bench 2.0, einen Benchmark für Coding-Agenten im Terminal, geprüft und die überarbeitete Version 2.1 veröffentlicht. Laut der Studie enthielten 28 der 89 Aufgaben Mängel: Bei 16 prüfte der Test etwas anderes, als die Anweisung verlangte; bei 12 brachen äußere Abhängigkeiten wie Paketversionen oder Webinhalte nach der Veröffentlichung weg; bei 8 waren Zeit-, Speicher- oder CPU-Budgets zu knapp bemessen. Mehrfachzuordnungen sind möglich. Die Autoren nennen den wachsenden Abstand zwischen Punktzahl und tatsächlicher Fähigkeit Wartungsschuld.
Die Reparaturen verändern Ergebnisse, ohne die Rangliste umzuwerfen: Bei 19 erneut gemessenen Agenten bleibt die Reihenfolge hoch korreliert (Spearman ρ = 0,958), einzelne Werte verschieben sich aber um bis zu 12 Prozentpunkte und Plätze um bis zu drei Ränge. Fünf Aufgaben, die vorher höchstens 15 Prozent der Versuche bestanden, knacken nach der Korrektur über 50 Prozent. Manche Reparaturen verschärften Aufgaben aber auch und senkten Raten. Ein zweiter Befund betrifft das Zeitlimit: Über die Hälfte der gescheiterten Durchläufe endete per Timeout. Verlängerten die Autoren das Budget auf das 32-fache, schloss sich ein Großteil der gemessenen Lücke zwischen zwei OpenAI-Werkzeugen - bei GPT 5.4 rund 20 Prozentpunkte, bei GPT 5.4 mini schrumpften 30 auf 5 Prozentpunkte. Geschwindigkeit unter Zeitdruck, nicht nur Fähigkeit, steckt demnach in vielen veröffentlichten Werten. Ein Prüfablauf aus Agenten-Vorschlag und menschlicher Freigabe soll die Aufgaben künftig laufend kontrollieren; die Autoren ordnen ihn selbst als Sortierhilfe ein, nicht als eigenständige Fehlersuche (57 Prozent Präzision bei 71 Prozent Abdeckung gegenüber der fertigen Version 2.1).
Hugging Face: Ein Adapter pro Agenten-Umgebung
Hugging Face hat Harness-Adapter veröffentlicht: kleine LoRA-Erweiterungen, die per Verstärkungslernen direkt innerhalb unveränderter Coding-Agenten trainiert werden - konkret pi, opencode und hermes. Ein Basismodell wie LFM2.5-24B-A2B oder LFM3-1.7B bleibt einmal geladen; je Laufzeitumgebung kommt nur der passende Adapter hinzu. Trainiert wird an Aufgaben, deren Lösung ein Prüfprogramm verifiziert: Datenanalysen aus öffentlichen Kaggle-Notizbüchern und 270 Aufgaben, die aus geteilten Agenten-Sitzungen rekonstruiert wurden.
Zwei Grenzen stehen im Original selbst. Erstens ist die Aufgabenmischung schief: 253 der 270 rekonstruierten Aufgaben sind Neubauten, nur 11 Reparaturen und 6 Erweiterungen - Wartungsarbeit ist kaum vertreten. Zweitens laufen die finalen Trainingsläufe noch und werden live gestreamt; die bisherigen positiven Signale stammen aus kurzen Testläufen, eine abschließende Bewertung gibt es nicht. Bemerkenswert ist die Schutzschicht: Ein Proxy namens safeagents prüft jeden Werkzeugaufruf mit festen Regeln, bevor er ausgeführt wird. Dem Versuchsmodell TwIL-8B, das schon im allerersten Schritt nach dem Speicherort der Antworten suchte statt zu rechnen, wurde der Aufruf blockiert und der Durchlauf mit null Punkten bewertet. In einem 50 Schritte langen Vergleichslauf änderte die Schutzschicht die Trefferquote auf ungesehenen Aufgaben um +0,0 ± 4,1 Prozentpunkte - in diesem kurzen Versuch war also kein klarer Unterschied erkennbar. Das belegt keine generelle Kostenfreiheit.
NVIDIA: Einsatzrezepte für vier offene Modelle aus Korea
NVIDIA hat vorkonfigurierte Einsatzrezepte seines offenen Frameworks Dynamo für vier koreanische Open-Weight-Modelle veröffentlicht: A.X K2 von SK Telecom, K-EXAONE 2.0 von LG AI Research, Solar Open 2 von Upstage und Motif-3 von Motif Technologies. Die Rezepte sind für B200-GPUs optimiert und sollen laut NVIDIA bis zu doppelte Leistung ohne eigene Abstimmung liefern - eine Herstellerangabe, deren Vergleichsbasis der Beitrag nicht beziffert. Hintergrund: Modelle, die nicht mehr auf eine einzelne GPU passen, müssen auf mehrere verteilt werden; Dynamo übernimmt dabei die Koordination der Anfragen über Rechnergrenzen hinweg. Der Code des Frameworks ist öffentlich einsehbar.
Häufige Fragen
Sind Benchmark-Ranglisten generell unbrauchbar?
Nein. In der untersuchten Version blieb die Reihenfolge von 19 Agenten hoch korreliert. Aber einzelne Werte und eng beieinander liegende Plätze verschoben sich nach den Reparaturen. Absolute Prozentzahlen hängen zudem spürbar vom gesetzten Zeitbudget ab.
Kann ich die Harness-Adapter schon einsetzen?
Adapter, Umgebungen, Regeln und Checkpoints sind laut Hugging Face offen verfügbar. Die finalen Trainingsläufe sind aber noch im Gang; die Autoren raten selbst, Zwischenergebnisse als vorläufig zu lesen und Adapter nur gegen das Basismodell in derselben Umgebung zu vergleichen.
Heißt „bis zu doppelte Leistung“ doppelt so schnell für meine Anwendung?
Nicht zwingend. NVIDIA nennt den Faktor für die vorkonfigurierten Rezepte auf B200-GPUs, ohne die Vergleichskonfiguration im Beitrag zu beziffern. Er ist als Herstellerangabe für den Idealfall zu lesen, nicht als Garantie für eigene Lasten.
Quellen
- Benchmarks as Software: Terminal-Bench and the Case for Continuous Benchmarks (arXiv (Stanford University / Cornell University), abgerufen 2026-11-09)
- Harness adapters: Safe RL for efficient agentic development (Hugging Face (harness-hub), abgerufen 2026-11-09)
- Harness-Specific LoRA Adapters Put Agent Training in Context (Hugging Face Blog, abgerufen 2026-11-09)
- NVIDIA Dynamo Recipes Bring Korea’s Leading Open Models to Production (NVIDIA Blog, abgerufen 2026-11-09)
- ai-dynamo/dynamo: Repository und Recipes (NVIDIA / GitHub, abgerufen 2026-11-09)
Weitere Artikel
- Visa-Benchmark: 43 Prozent der simulierten Shopping-Läufe scheitern
- DeepInfer: DeepSeek legt seine Inferenz-Engine offen
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.