


KI am Morgen: Lernen ohne Merkmale, Korrektur im Takt, geprüfte Prüfer
Die wichtigsten Fakten
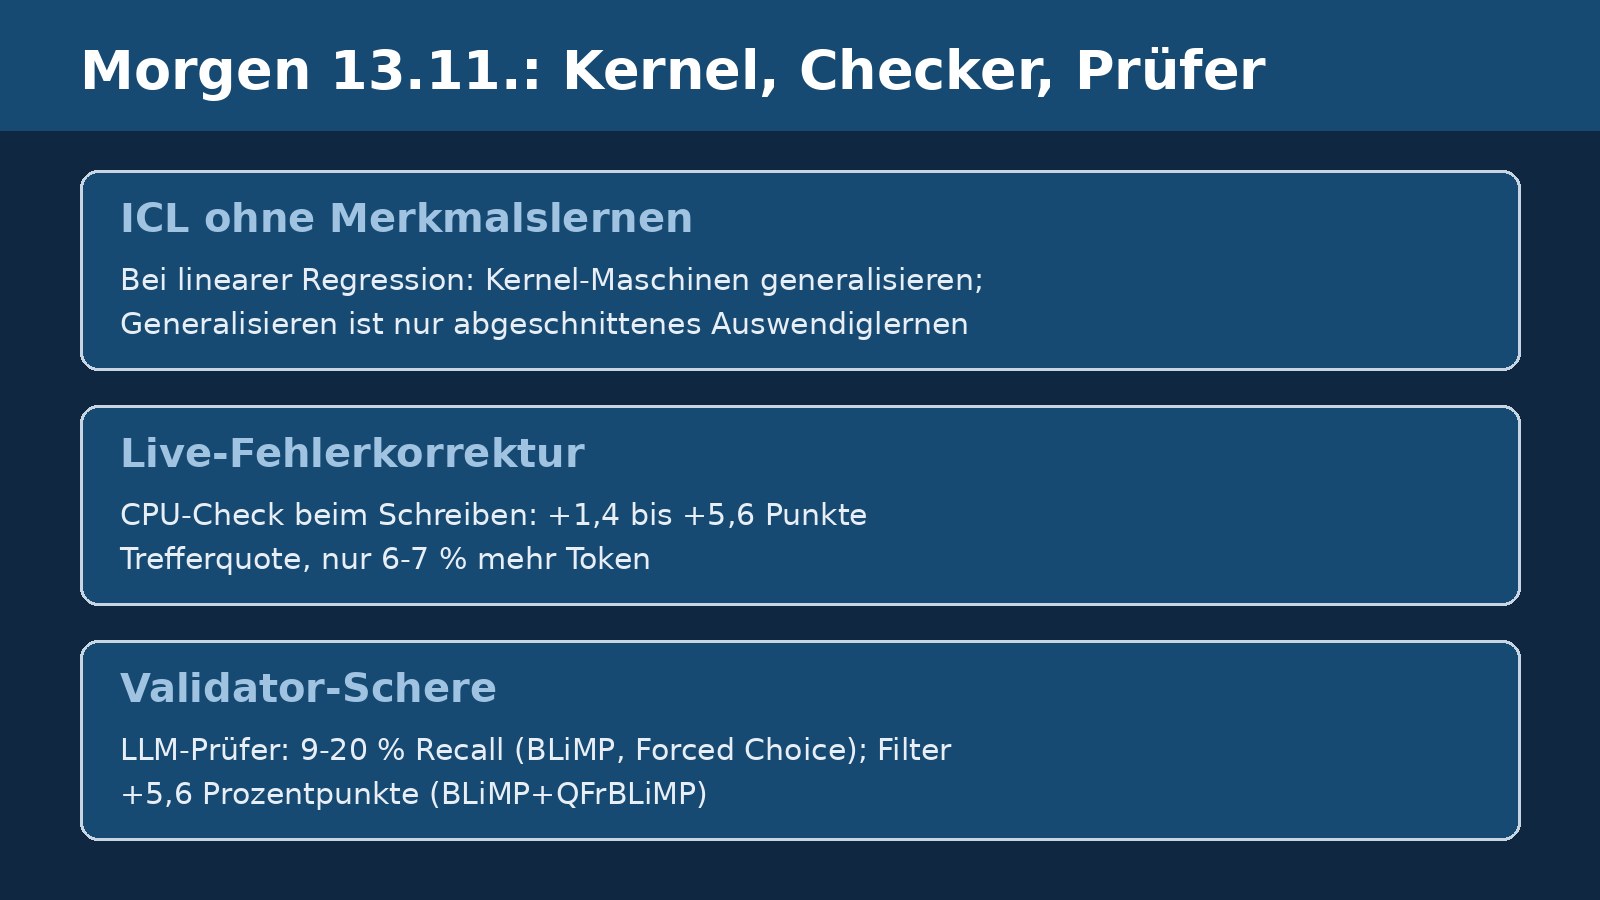
- In-Context-Lernen ohne Merkmalslernen: Kernel-Maschinen generalisieren in einer künstlichen linearen Regressionsaufgabe mit gaußschen Inputs. Die generalisierende Lösung ist näherungsweise eine Low-Degree-Trunkierung der memorisierenden. Die Übertragung auf Sprachaufgaben ist offen.
- Fehlerkorrektur im laufenden Text (Technion): Ein CPU-basierter Computer-Algebra-Checker prüft Gleichungen, während das Modell weiter schreibt. Auf 2.700 Symbolik-Aufgaben steigt die Trefferquote um 1,4 bis 5,6 Punkte bei nur 6 bis 7 Prozent mehr Token; pro Prüfung rund 25 Millisekunden CPU.
- BLiMP: Forced-Choice-Validatoren stimmen zu 93,7-95,3% mit gehaltenen Menschenmehrheiten überein, finden aber nur 9-20% der Labels ohne Mehrheitssupport (ein Mensch 47%). Der Gemini-RATE-Filter hebt Accuracy über BLiMP+QFrBLiMP im Mittel um 5,6 Prozentpunkte gegenüber Zufallsentfernung.
Morgenüberblick vom 13. November. Quellenstand: 06:40 Uhr MEZ. Heute: eine Theorie des In-Context-Lernens ohne Merkmalslernen, Echtzeit-Fehlerkorrektur während des Denkens und eine Warnung vor LLM-Validatoren in Benchmarks.
In-Context-Lernen: Generalisieren ist hier nur zu wenig Auswendiglernen
Woran erkennt man, ob ein Modell eine Aufgabe aus dem Kontext versteht oder nur Statistiken des Trainings auswendig gelernt hat? Joseph Turnbull und Jamie Simon (UC Berkeley und Imbue) zerlegen dafür eine bekannte Testaufgabe (lineare Regression im Kontext nach Raventós und Kollegen) in die Eigenbasis rotationsinvarianter Kernel-Maschinen. Das Ergebnis: Mit wachsender Stichprobe lernen diese einfachen Modelle nacheinander Komponenten des Auswendiglernens mit immer höherem Grad; die generalisierende Lösung ist näherungsweise eine abgeschnittene Version davon. Erst generalisiert das Modell, dann kippt es mit mehr Training ins Auswendiglernen. Weil Kernel-Maschinen keinerlei Merkmale lernen, ist Merkmalslernen für diese In-Context-Regressionsaufgabe nicht nötig; die frühere Erklärung, mehr Aufgabenvielfalt führe zur Generalisierung, gilt demnach unabhängig von der Transformer-Architektur.
Der Brückenschlag zu echten Modellen: GPT-2-artige Transformer (zwölf Schichten, trainiert mit Adam auf 256 Aufgaben) lernen auswendig, indem sie nicht-gaußsche Statistiken der Trainingsaufgaben nutzen, genau in der Reihenfolge, die die Kernel-Theorie vorhersagt. Entfernt man die vierte Kumulante aus dem Aufgabenpool, bleibt der Transformer während des gesamten Trainings generalisierend. Die Autoren grenzen selbst ein: Die Analyse gilt nur für lineare Regression mit gaußschen Eingaben; für natürlichsprachliches In-Context-Lernen ist die Übertragung offen. Code ist öffentlich (github.com/JoeyTurn/kernels_can_icl).
Der Checker schreibt mit: Fehlerkorrektur ohne zweites Modell
Rotem Elimelech, Michael Shalyt und Ido Kaminer (Technion) prüfen mathematische Zwischenschritte, während das Modell sie schreibt: Ein Extraktor zieht fertige Gleichungen aus dem Textstrom, ein Computer-Algebra-System bewertet sie numerisch auf der CPU (22 bis 25 Millisekunden pro Prüfung), und nur ein Fehlurteil unterbricht die Generierung; die Fortsetzung hinter dem Fehlschritt wird verworfen, eine kurze Korrektur-Notiz angehängt, dann schreibt das Modell weiter. Maximal drei Rücksetzer pro Frage. Getestet auf 2.700 leichten bis mittleren Aufgaben des ASyMOB-Benchmarks mit drei offenen Modellen (Qwen3-30B-A3B-Instruct, Qwen3-4B-Instruct, Gemma-4-12B-it), je fünf Durchläufe: Die Trefferquote steigt bei allen drei (62,4 auf 68,0; 23,4 auf 24,8; 45,2 auf 48,2 Prozent), also um 1,4 bis 5,6 Punkte, bei nur 6 bis 7 Prozent mehr Token pro Antwort. In den Antworten mit erkanntem Fehler steigt die Quote um 6,0 bis 10,2 Punkte, in den übrigen bewegt sie sich nicht messbar. Das misst Prüf-CPU-Zeit und Tokenverbrauch, nicht den gesamten Zeitaufwand: Unterbrechen, erneute Promptverarbeitung und Cacheverwaltung können zusätzlich kosten. Kontrollierte End-to-End-Latenz- und Durchsatzvergleiche stehen aus.
Wichtig ist der Scope: Geprüft werden nur lokal prüfbare Gleichungen; ob ein Schritt zur Aufgabe passt oder auf einer falschen Prämisse aufbaut, erkennt der Checker nicht, und ein Bestehen ist numerische Übereinstimmung, kein Beweis. Die Evaluation stammt aus einem Benchmark und zwei Modellfamilien, und der Benchmark (ASyMOB) kommt aus derselben Arbeitsgruppe; wir haben die Experimente nicht selbst reproduziert. Der Ansatz ist bewusst komplementär: Er konkurriert nicht mit besseren Modellen, weil der Prüfer modellunabhängig ist und ohne GPU auskommt.
Wenn der Validator das Ergebnis schönt
Guofang Tang (Ghostcloud) untersucht LLMs als Ersatz für menschliche Label-Prüfung bei Minimalpaaren. Getestet werden BLiMP (348 Paare mit je rund 20 Crowd-Urteilen) und QFrBLiMP (1.693 Paare mit je zwölf Muttersprachlern). Auf BLiMP stimmen Forced-Choice-Validatoren zu 93,7-95,3 Prozent mit gehaltenen Menschenmehrheiten überein, etwas häufiger als ein Fünfer-Panel mit 93,4 Prozent. Sie finden aber nur 9-20 Prozent der Labels ohne Mehrheitssupport; ein einzelner menschlicher Prüfer findet 47 Prozent. Diese Recall-Spanne gilt nicht für QFrBLiMP. In der getrennten Downstream-Auswertung mit Gemini RATE als Primärfilter über beide Datensätze sind menschlich gestützte, aber vom Validator markierte Paare für zehn offene Modelle im Mittel 18,9 Prozentpunkte schwerer. Entfernt man die markierten Paare, steigt die Accuracy im Mittel um 5,6 Prozentpunkte gegenüber Zufallsentfernung (95-%-Intervall 4,6 bis 6,7). Hohe Übereinstimmung allein sagt deshalb wenig darüber, welche kritischen Paare ein Validator findet.
Die Rangfolge der Modelle bleibt dabei nahezu stabil (Kendall-Tau mindestens 0,87), in diesem Test verschieben sich vor allem Absolutwerte und die Sichtbarkeit von Fehlern. Der Autor benennt die Grenzen offen: nur drei Datensätze mit Einzelurteilen, das vorregistrierte Haupturteil ist wegen kleiner Fallzahl (19 kritische Paare in BLiMP) ein schwaches Pass, QFrBLiMP blieb wegen niedriger Split-Half-Reliabilität (0,454) deskriptiv, und der Mechanismus ist korrelativ gezeigt, nicht kausal. Code, Validator-Ausgaben und Modellwerte sind laut Paper veröffentlicht; ein Repository-Link ist im Text nicht genannt.
Häufige Fragen
Heißt das, große Modelle verstehen Kontext gar nicht?
Das sagt die Arbeit nicht. Sie zeigt für eine künstliche Regressionsaufgabe: Generalisieren kann schon eine einfache Kernel-Maschine, und Auswendiglernen läuft über vorhersagbare Statistiken. Für natürlichsprachliches In-Context-Lernen ist die Übertragung offen.
Was kostet die Live-Korrektur im Betrieb?
Nach den Messungen der Autoren: 22 bis 25 Millisekunden CPU pro Prüfung, keine weiteren Modellaufrufe, 6 bis 7 Prozent mehr Token pro Antwort und im Mittel 1,4 bis 15,6 verworfene Token pro Rücksetzer. Der Gewinn: 1,4 bis 5,6 Punkte Trefferquote auf dem getesteten Symbolik-Benchmark. Das ist keine Messung der gesamten Antwortlatenz oder eines allgemeinen Kostenvorteils gegenüber einem Verifier-Modell.
Sind LLM-validierte Minimal-Paar-Benchmarks jetzt unbrauchbar?
In diesen Tests steigen die Absolutwerte nach LLM-Filterung, während die Rangfolge der zehn offenen Modelle nahezu gleich bleibt (Kendall-Tau mindestens 0,87). Das garantiert keine stabilen Rangfolgen in anderen Benchmarks. Die Studie empfiehlt menschliche Nachprüfung markierter Paare statt automatischer Entfernung und warnt davor, hohe Übereinstimmung allein als Validierung zu lesen.
Quellen
- You Don't Need Feature Learning to Do In-Context Learning (arXiv (Joseph Turnbull, Jamie Simon; UC Berkeley, Imbue), abgerufen 2026-11-13)
- Catch It Where It Happens: Real Time Error Correction During LLM Reasoning (arXiv (Rotem Elimelech, Michael Shalyt, Ido Kaminer; Technion - Israel Institute of Technology), abgerufen 2026-11-13)
- LLM Validation Makes Minimal-Pair Benchmarks Easier for Language Models (arXiv (Guofang Tang; Ghostcloud), abgerufen 2026-11-13)
Weitere Artikel
- Googles Sleep-Framework: Sprachmodelle sollen im Schlaf weiterlernen
- Raschkas Gratis-Videokurs: Reasoning-Modelle von Grund auf selbst bauen
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.