


KI am Morgen: Miniatur-Befehle, Scheinpolicies, Akten-Leerlauf
Die wichtigsten Fakten
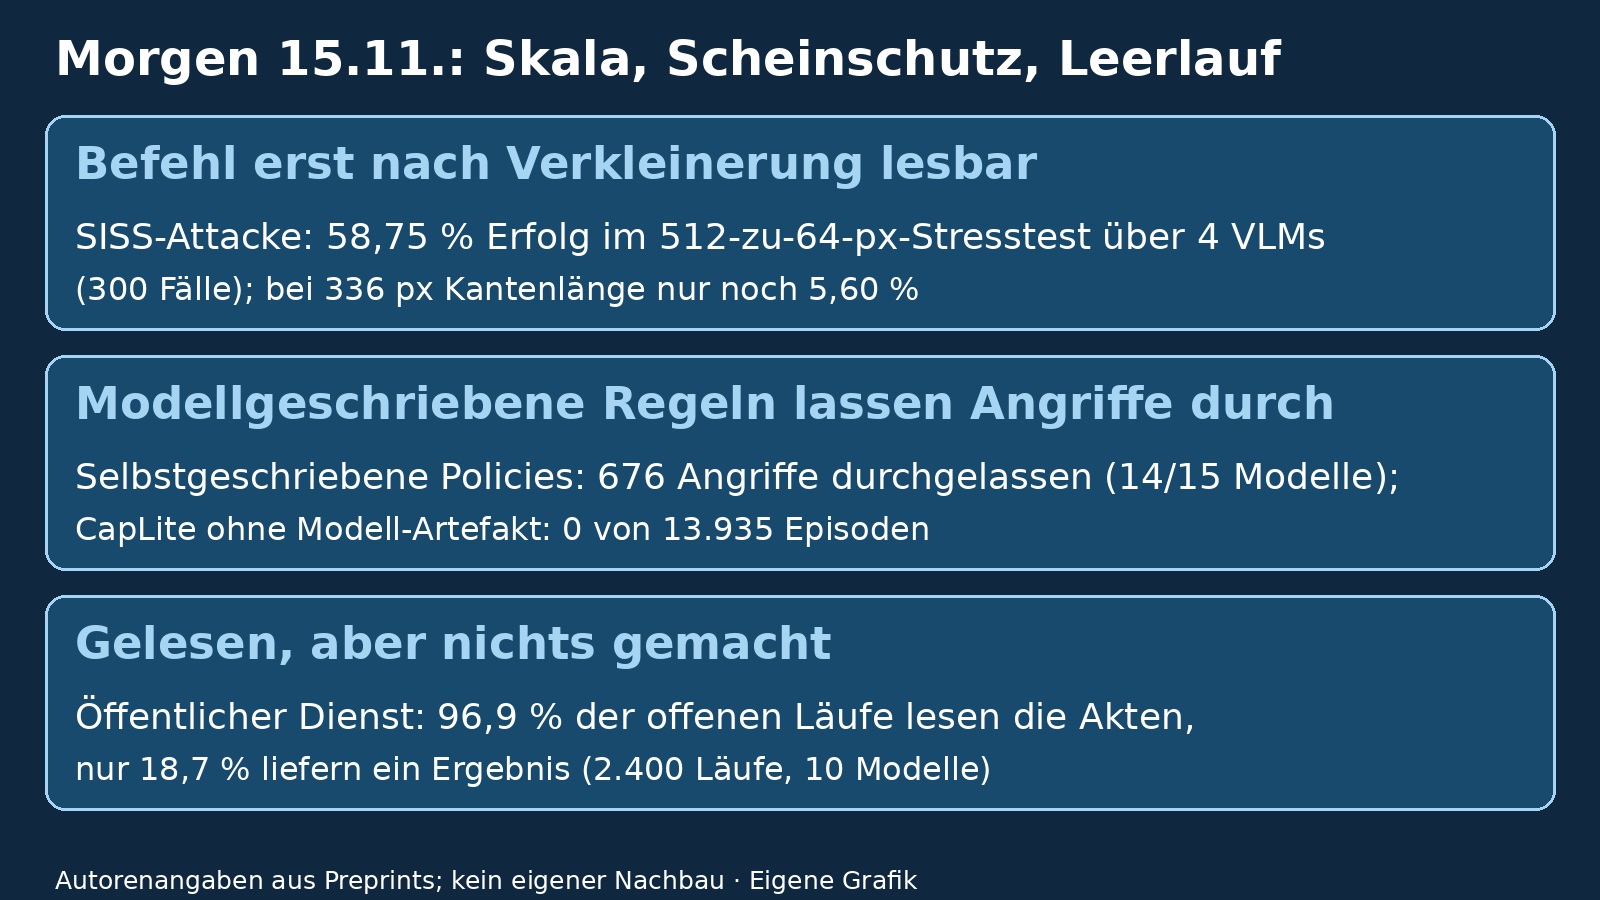
- Versteck per Verkleinerung: Die SISS-Attacke baut Bilder, deren eingebetteter Befehl bei 512x512 Pixeln nicht, nach Verkleinerung auf 64x64 aber doch vom Modell gelesen wird; im Stresstest 58,75 Prozent Erfolg im Mittel über vier geschlossene VLMs (300 fixe Fälle), bei 336 Pixeln Kantenlänge nur noch 5,60 Prozent.
- Modellgeschriebene Schutzregeln lassen Angriffe durch: Die Policies, Graphen und Checklisten, die 15 getestete Open-Weight-Modelle (1,7 bis 35 Milliarden Parameter) für Enforcement-Verteidigungen selbst formulieren, ließen in der Studie Angriffe durch (bis zu 676 von 13.935 Episoden); der deterministische Ansatz CapLite kommt ohne modellgeschriebene Artefakte aus und ließ dort keinen Angriff durch, bei deutlich niedrigerer Nützlichkeit als der ungeschützte Agent.
- Öffentlicher Dienst als Prüfstand: In vier Behörden-Szenarien mit prüfbaren Akten lesen Agenten in 96,9 Prozent der offenen Läufe die Unterlagen, liefern aber nur in 18,7 Prozent ein Ergebnis; mit explizitem Auftrag produzieren 86,0 Prozent, lesen dann aber nur noch die Hälfte der Akten.
Morgenüberblick vom 15. November. Quellenstand: 06:37 Uhr MEZ. Heute: eine Bildattacke, deren versteckter Befehl erst nach Verkleinerung lesbar wird, eine 15-Modelle-Studie, in der von Agenten-Modellen selbst geschriebene Sicherheits-Artefakte Angriffe durchließen, und ein Verhaltens-Test für Agenten mit ungenauen Anweisungen im öffentlichen Dienst.
Der Befehl erscheint erst in der Verkleinerung
Bilder werden in Multimedia-Pipelines skaliert, komprimiert und neu gerastert, bevor ein Vision-Language-Modell sie sieht. Yiheng Zhao, Runze Ji und Kollegen (Nanyang Technological University, DSO National Laboratories) zeigen, dass dieser Schritt die maschinell lesbare Bedeutung ändern kann: Ihre SISS-Methode erzeugt Bilder, aus denen ein Zielmodell einen eingebetteten Textbefehl in der 512x512-Präsentationsansicht nicht rekonstruiert, nach aggressivem Herunterskalieren auf 64x64 aber schon. Das 512-zu-64-Paar ist dabei ausdrücklich ein kontrollierter Stresstest, keine Annahme über die interne Auflösung einzelner Modelle. Auf 300 fixen Fällen (30 Payloads x 10 Szenenmuster, vor jeder Zielabfrage eingefroren) erreicht die dritte Verfeinerungsrunde im Mittel 58,75 Prozent Angriffserfolg über GPT-4o (60,33), Claude Sonnet 4.6 (57,67), Qwen3.5-Plus-02-15 (62,67) und Gemini-3-Flash (54,33); die stärkste Generierungs-Baseline liegt bei 41,08 Prozent. Die Auflösungsskalierung begrenzt den Effekt klar: Im Mittel fallen die Werte auf 17,68 Prozent bei 128 Pixeln, 6,85 bei 224 und 5,60 bei 336.
Im Web-Agenten-Testbed steigt die Wahrnehmung der versteckten Anweisung deutlich (Gemini-3-Flash von 37,33 auf 67,67 Prozent, GPT-4o von 12,67 auf 30,33), doch die Rate tatsächlich kompromittierter Aktionen bleibt bei rund 4 Prozent (Baselines 2,33 und 1,67): messbarer Einfluss, aber kein zuverlässiges Agenten-Kapern. Bei der Verteidigung versagen fünf generische Eingabe-Transformationen im Versuch komplett (Angriffserfolg 67 bis 69 Prozent gegenüber 68 Prozent ungeschützt, alle gepaarten Tests p = 1,0). Besser schneidet der vorgeschlagene ScaleGuard ab, ein Konsistenz-Check, der eine hochauflöste Ansicht mit neun verkleinerten Sonden vergleicht: nicht-adaptiv senkt er den Erfolg von 61,4 auf 24,3 Prozent (McNemar p < 10^-7), nach einer Adaptionsrunde des Angreifers von 42,5 auf 15,0 Prozent (p < 10^-3). Zur Einordnung: Die null zurückgewiesenen Kontrollbilder sind Beobachtungen an 70 beziehungsweise 40 Fällen, keine Fehlalarm-Garantie; die Abwehr-Werte stammen aus einem eigenen Protokoll und sind nicht mit der Haupttabelle vergleichbar; und der Check fragt zehn Ansichten pro Bild ab, deren Latenz das Paper nicht misst.
Modellgeschriebene Schutzregeln lassen Angriffe durch
Enforcement-Verteidigungen gegen Prompt-Injection wie CaMeL, Progent, IPIGuard und DRIFT lassen das Agenten-Modell selbst ein Sicherheits-Artefakt schreiben: ein Programm, eine Privilegien-Policy, einen Abhängigkeitsgraphen oder eine Checkliste, die dann Code durchsetzt. Zimo Xu, Wenzhuo Liu und Hideki Nakayama (University of Tokyo, CAS) prüfen, ob kleine Modelle dafür taugen. Ergebnis über 15 Open-Weight-Modelle (13 davon zwischen 1,7 und 12 Milliarden Parametern, dazu Qwen3-32B und ein 35B-MoE als Referenz) auf AgentDojo: In den untersuchten Konfigurationen boten die modellgeschriebenen Artefakte keinen verlässlichen Schutz. Artefakte, die entscheiden, was erlaubt ist, kippen nach vorn: Progent-Policies lassen Angriffe bei 14 von 15 Modellen durch (676 Fälle, bis zu 132 von 929 auf Qwen3-32B), IPIGuard-Graphen bei 13 (435), DRIFT-Checklisten bei 11 (214). CaMeL als Artefakt, das entscheidet, was läuft, kippt nach hinten: nur 20 erfolgreiche Angriffe in 13.935 Episoden, aber die Programme laufen bei 8 der 15 Modelle in über 15 Prozent der Episoden nicht (Spitze: 68 Prozent) und kosten im Mittel 93,7k Tokens pro Episode. Innerhalb der Qwen3- und Gemma-4-Familien steigt die Angriffsquote mit der Modellgröße (Progent: 3,0 auf 14,2 Prozent); größere Modelle schreiben in diesem Bereich keine verlässlicheren Artefakte, dafür folgen sie Injektionen eher.
Der Gegenentwurf CapLite verzichtet komplett auf modellgeschriebene Artefakte: Die Policy wird per fester Regeln aus den Tool-Schemas abgeleitet, ein Planer, der nur die Anfrage sieht, legt alle Schreibaufrufe fest, bevor irgendein Werkzeugergebnis gelesen wird, und ein deterministischer Prüfer lässt einen Schreibzugriff nur zu, wenn jede Autoritätsangabe (Empfänger, Betrag, Objekt, Ziel) exakt in der Nutzeranfrage steht. Damit gelingt in 13.935 angegriffenen Episoden kein einziger Angriff, auch nicht in drei Zusatzattacken gegen das eigene Design (0 von 7.432 mit Tool-Nennung, 0 von 168 per URL-Köder, 0 von 104 mit gefälschtem Deskriptor). Die Rechnung: Nützlichkeit unter Angriff 29,0 Prozent, vergleichbar mit CaMeL (27,2), aber 21 Punkte unter dem ungeschützten Agenten (50,2); dafür nur 17,1k Tokens pro Episode, 18 Prozent des CaMeL-Aufwands und die höchste Nützlichkeit pro Token aller Enforcement-Verteidigungen. Ablationen zeigen, dass der Prüfer und die frühe Festlegung der Schreibaufrufe die Sicherheit tragen (ohne sie 106 beziehungsweise 53 erfolgreiche Angriffe von 7.432). Grenzen: nur ein Benchmark mit simulierten Umgebungen, 20 Antwort-Aufgaben liegen außerhalb der Schreib-Garantie, und Werte, die der Nutzer nicht selbst nennt, erfordern eine Rückfrage. Die Autoren geben an, Code und Episoden-Tabellen zu veröffentlichen; ein Repository-Link ist im Preprint nicht genannt.
Öffentlicher Dienst: Agenten lesen, aber sie handeln nicht
Was tut ein Agent, wenn die Anweisung nur lautet 'schau dir die Anträge mal an'? Diana Kozachek und Kinjalk Srivastava (Universität St. Gallen) bauen vier von Fachexperten validierte Szenarien aus dem öffentlichen Dienst (Bürgerbudget, Stationsplanung, Kurskatalog, Gewässerüberwachung) als statische Dateibäume mit prüfbaren Entscheidungshebeln und lassen zehn LLMs darin laufen: 2.400 Trajektorien unter vier Prompt-Bedingungen (bis 50 Züge, 93.594 Züge insgesamt), plus 600 Läufe mit gerichteter Anweisung und 1.000 Vergleichsläufe in einer leeren Sandbox. Ergebnis: In den offenen Bedingungen lesen die Agenten in 96,9 Prozent der Läufe die Akten, doch nur 18,7 Prozent erzeugen ein Artefakt oder eine selbstgewählte Aufgabe; 84,1 Prozent aller Züge sind Erkundung, gut ein Drittel davon erneutes Lesen bereits gelesener Dateien. Mit explizitem Auftrag kippt das Bild: 86,0 Prozent produzieren, aber nur 50,0 Prozent lesen die Akten überhaupt. Von 305 Läufen mit geschriebener Datei liefern 37 Prozent nur Boilerplate; 1,4 Prozent aller offenen Läufe enden mit einer Datei, deren Zahlen den Akten widersprechen.
Der kontrollierte Vergleich mit der leeren Sandbox trennt Umgebung von Modell: Der Anteil produktiver Läufe unterscheidet sich nicht belastbar (18,7 vs. 16,0 Prozent, nach Korrektur nicht signifikant), doch Grenzaustesten fällt mit Inhalt um 60 Prozent (0,87 auf 0,34 Züge pro Lauf), während Wiederholungslektüre und Meta-Reflexion steigen. Die Rangfolge der Modelle nach Produktion überträgt sich zwischen den Umgebungen (Spearman 0,79), die nach Leseverhalten praktisch nicht (0,19): Ein Test ohne echte Inhalte sagt also nicht voraus, welches Modell die Akten nutzt. Die Modellunterschiede sind größer als alle Bedingungseffekte: Die Produktionsrate reicht von 0,0 Prozent (Gemma-3-12B) bis 90,0 Prozent (Apertus-8B), wobei ein Großteil der Apertus- und Llama-Dateien Boilerplate ist; Claude-Sonnet-4 schreibt am häufigsten aktenkonsistente Dateien (37,2 Prozent) und zugleich am häufigsten widersprechende (13,3 Prozent). Als konkreten Fall berichten die Autoren von der Beschaffungsentscheidung ihrer eigenen europäischen Universität, die auf Basis des Tests Mistral-Small-2603 für eine Beratungsaufgabe wählte, weil dieses Modell in den Szenarien keine widersprechende Datei, kein Boilerplate und die wenigsten Grenztests zeigte; das ist die Darstellung der Autoren, keine unabhängige Prüfung. Grenzen: statische Umgebung ohne Ereignisse, regelbasierte statt menschlicher Turn-Einstufung, prompt-abhängige Modellraten. Szenarien, Code und Trajektorien sind laut Paper veröffentlicht; ein Link ist im Preprint nicht genannt.
Methode
Quellenabgleich der drei Original-Preprints (arXiv 2611.16744, 2611.17115, 2611.15460). Alle Messwerte sind Angaben der Autoren; kein eigener experimenteller Nachbau.
Häufige Fragen
Ist mein VLM-Setup von der Skalen-Attacke betroffen?
Der stärkste Effekt zeigte sich bei aggressiver Verkleinerung: Im 512-zu-64-Stresstest lag die Erfolgsquote im Mittel bei 58,75 Prozent, bei 224 und 336 Pixeln Kantenlänge unter 11 Prozent pro Modell, aber nicht bei null. Eine pauschale Aussage zur eigenen Pipeline erlaubt das nicht: Prüfen Sie, ob Ihre Pipeline Bilder stark herunterskaliert. Generische Filter halfen in der Studie nicht; wirksam war ein Konsistenz-Check, der mehrere Auflösungen desselben Bildes gegen die Präsentationsansicht vergleicht.
Kann ein kleines Modell seine eigenen Sicherheitsregeln schreiben?
In den untersuchten Konfigurationen boten sie keinen verlässlichen Schutz: Die selbstgeschriebenen Policies und Graphen ließen Angriffe durch oder opferten die Aufgabe. Ein universelles Urteil über alle Modellgrößen und Einstellungen erlaubt die Studie nicht. Der getestete Ausweg ist, die Regeln deterministisch aus den Tool-Schemas abzuleiten und Schreibzugriffe vor dem ersten Werkzeugabruf festzulegen; das kostet allerdings Nützlichkeit, und belegt ist es bislang nur auf einem Benchmark.
Was sagt der Behörden-Test über Agenten-Einsätze aus?
Dass 'liest alles' nicht 'erledigt etwas' bedeutet und dass ein leerer Test-Sandbox-Test das Leseverhalten nicht vorhersagt. Das Paper empfiehlt, das Verhalten vor einer Beschaffung auf den eigenen, anonymisierten Akten zu prüfen und dabei widersprechende Inhalte als Fehler zu werten; die Entscheidungsschwelle bleibt beim Einsetzenden.
Quellen
- Scale-Induced Semantic Shift in Visual Prompt Injection Against VLMs and Web Agents (arXiv (Yiheng Zhao, Runze Ji u. a.; Nanyang Technological University, DSO National Laboratories), abgerufen 2026-11-15)
- CapLite: Prompt-Injection Defense for Small Language Model Agents without Model-Written Security Artifacts (arXiv (Zimo Xu, Hideki Nakayama; University of Tokyo; Wenzhuo Liu, CAS), abgerufen 2026-11-15)
- Read and Ignore: What Self-Directed LLM Agents Do in Public Service Scenarios (arXiv (Diana Kozachek, Kinjalk Srivastava; University of St. Gallen), abgerufen 2026-11-15)
Weitere Artikel
- Vals-Untersuchung: Qwen-3.8-Modelle rufen Alibaba-Proxy - so schützt du deine Agenten
- Angriff per Downloads-Ordner: Präparierte AGENTS.md kapert Coding-Agenten
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.