


62,7 oder 99,9 Prozent: Wie der Harness über GPT-6 Astras ARC-AGI-3-Ergebnis entscheidet
Die wichtigsten Fakten
- Auf der verifizierten ARC-Prize-Ergebnisseite erreicht GPT-6 Astra auf ARC-AGI-3 mit dem Standard-Harness 62,7 Prozent (maximale Reasoning-Stufe, rund 26.098 US-Dollar je Lauf) und mit dem Provider-Adapter-Harness 99,9 Prozent (hohe Reasoning-Stufe, rund 18.817 US-Dollar).
- Der Standard-Harness lässt das Modell nur selbst gewählte Notizen zwischen den Schritten weitertragen. Der Provider-Adapter erhält den opaken Reasoning-Zustand des Modells zwischen den Anfragen und komprimiert längere Verläufe.
- ARC Prize verifiziert und dokumentiert beide Konfigurationen offen; der OpenAI-Eintrag umfasst zwölf Harness-Konfigurationen. Ein Regelverstoß ist nicht belegt.
- Für Benchmark-Vergleiche heißt das: Ein Score ohne Angabe von Harness und Kosten pro Lauf verliert seine Aussagekraft.
Kurz gesagt: Wie gut ist OpenAIs GPT-6 Astra wirklich auf ARC-AGI-3, dem Benchmark für interaktive Reasoning-Aufgaben? Die verifizierte Ergebnisseite von ARC Prize beantwortet das mit zwei Zahlen: 62,7 Prozent mit dem Standard-Harness, 99,9 Prozent mit dem Provider-Adapter-Harness. Beides ist korrekt, und genau darin liegt die Lehre.
Die zwei Zahlen
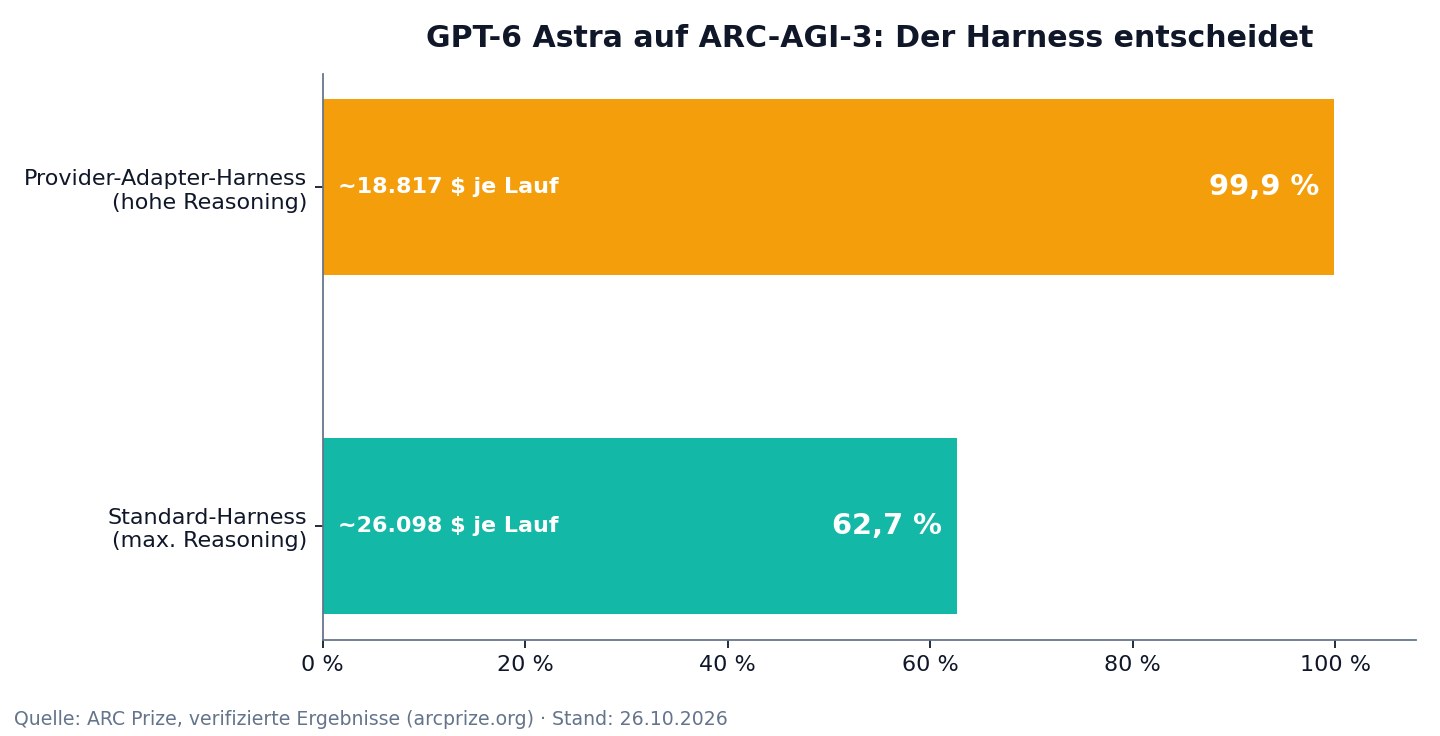
Beim Standard-Harness führt das Modell selbst gewählte Notizen durch die Umgebung: Es entscheidet, welche Strategienotizen es zwischen den Schritten behalten will. Der Provider-Adapter-Harness dagegen erhält den opaken Reasoning-Zustand des Modells zwischen den Anfragen und nutzt Kompaktierung für längere Verläufe, das Modell kann also frühere Arbeit direkt weiterverwenden. Der OpenAI-Eintrag stammt vom 2. September 2026 und umfasst zwölf Harness-Konfigurationen bei Tokenpreisen von 10 US-Dollar je Million Eingabe- und 50 US-Dollar je Million Ausgabetokens.
Warum der Adapter so viel besser abschneidet
ARC-AGI-3 besteht aus interaktiven Umgebungen mit langen Horizonten: Das Modell muss Regeln durch Ausprobieren entdecken und über viele Schritte verfolgen. Laut dem ARC-Prize-Blog führt Astra dabei Strategienotizen zu Objekten, Koordinaten, Regeln und offenen Plänen und entwickelt eine eigene kompakte Notation für die Umgebungen. Mit dem Adapter muss es dieses Verständnis nicht bei jeder Anfrage neu aufbauen. Dass der Adapter-Lauf zugleich besser und rund 28 Prozent günstiger ist, passt dazu: Weniger Wiederentdeckung heißt weniger Tokens.
Was das für Benchmarks bedeutet
Der Fall ist ein sauber dokumentiertes Beispiel für eine Entwicklung, die fast alle Agenten-Benchmarks betrifft: Das Ergebnis hängt zunehmend am Gerüst um das Modell, nicht nur am Modell. Wer Scores vergleicht, muss drei Dinge zusammen betrachten: den Harness, die Reasoning-Stufe und die Kosten pro Lauf. ARC Prize geht dabei vorbildlich offen mit den Daten um: Beide Konfigurationen sind verifiziert, mit Preisen und Konfigurationsdetails einsehbar. Ein Täuschungsvorwurf ist damit nicht belegt, wohl aber ein Vergleichbarkeitsproblem für alle, die nur die Schlagzeilenzahl lesen.
Für die Praxis ist die Adapter-Zahl die relevantere: Wer das Modell über die API produktiv einsetzt, bekommt genau diese Infrastruktur mitgeliefert. Wer dagegen wissen will, was das nackte Modell ohne Provider-Unterstützung leistet, muss auf die 62,7 Prozent schauen.
Häufige Fragen
Welche der beiden Zahlen ist die richtige?
Beide, sie beantworten verschiedene Fragen. 62,7 Prozent misst das Modell mit minimalem, neutralem Gerüst. 99,9 Prozent misst das Modell so, wie ein API-Kunde es tatsächlich nutzt, mit erhaltenem Reasoning-Zustand. Vergleiche sind nur innerhalb derselben Harness-Klasse fair.
Hat OpenAI sich damit einen Vorteil erschlichen?
Dafür gibt es keinen Beleg. ARC Prize selbst verifiziert beide Ergebnisse, beschreibt die Harness-Unterschiede öffentlich und listet alle zwölf getesteten Konfigurationen. Der Adapter ist Teil der Provider-Infrastruktur, keine geheime Sonderlösung.
Was heißt das für andere Benchmark-Vergleiche?
Frage bei jedem Score nach Harness, Reasoning-Stufe und Kosten pro Lauf. Ein Modell mit schwächerem Roh-Score kann mit besserem Gerüst praktisch stärker sein, und umgekehrt kann eine hohe Schlagzeilenzahl an teure Infrastruktur gebunden sein.
Quellen
- OpenAI GPT-6 Astra: Verifizierte ARC-AGI-3-Ergebnisse (ARC Prize, abgerufen 2026-10-26)
- OpenAI's GPT-6 Astra on ARC-AGI-3 (ARC Prize (Blog), abgerufen 2026-10-26)
- AI News Oct 26, 2026 (Morning Tokens, abgerufen 2026-10-26)
Weitere Artikel
- GVS5H: Fünf offene 27B-Modelle im Verbund erreichen Fable-5-Niveau
- Taste-Bench: KI-Agenten treffen schlechte Langzeit-Entscheidungen
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Das Titelbild ist KI-generiert und im Bild entsprechend gekennzeichnet. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.