


KI am Abend: Deutsche NER, Bildbelege und schnellerer Code
Die wichtigsten Fakten
- NER-D bündelt 13 deutsche Datensätze. Mit zusätzlichem LoRA-Training erreichen drei kleine offene Modelle höhere F1-Werte als die nur ohne Beispiele geprüfte GPT-Baseline.
- VEPO verbessert im Test mit LLaVA-1.5-7B die visuelle Objekterkennung auf Hindi. Der große Gewinn setzt eine Mischung aus Hindi- und englischen Trainingspaaren voraus.
- PerfArena trennt funktionierende Programme von effizienten Programmen. In der untersuchten LeetCode-Auswahl liefen korrekte Lösungen je nach Modell im Mittel bis zu 1,61-mal so lange wie die von GPT-6-Astra.
Abendüberblick vom 16. November. Quellenstand: 16:00 Uhr MEZ. Drei neue Preprints zeigen, warum die passende Messung wichtiger ist als ein einzelner Spitzenwert: Bei deutscher Entitätserkennung zählt die gelernte Annotationsregel, beim Bildverständnis die Sprache der Frage und bei generiertem Code mehr als ein bestandener Test.
NER-D: Kleine Modelle lernen deutsche Annotationsregeln
Welche Personen, Orte, Medikamente oder Fachbegriffe stehen in einem deutschen Text? NER-D untersucht diese Entitätserkennung anhand von 13 Datensätzen aus neun Domänen. Das Bielefelder Team um Marc Brinner vergleicht Ministral 8B, Qwen3.5-9B und Gemma 4 12B mit GPT-5.4 mini. Die Aufgabe ist überall ähnlich aufgebaut: Aus einem Satz soll ein JSON-Objekt mit den gefundenen Entitäten entstehen. Bewertet werden sowohl exakt passende Zeichenfolgen als auch eine tolerantere Variante für leicht abweichende Textgrenzen.
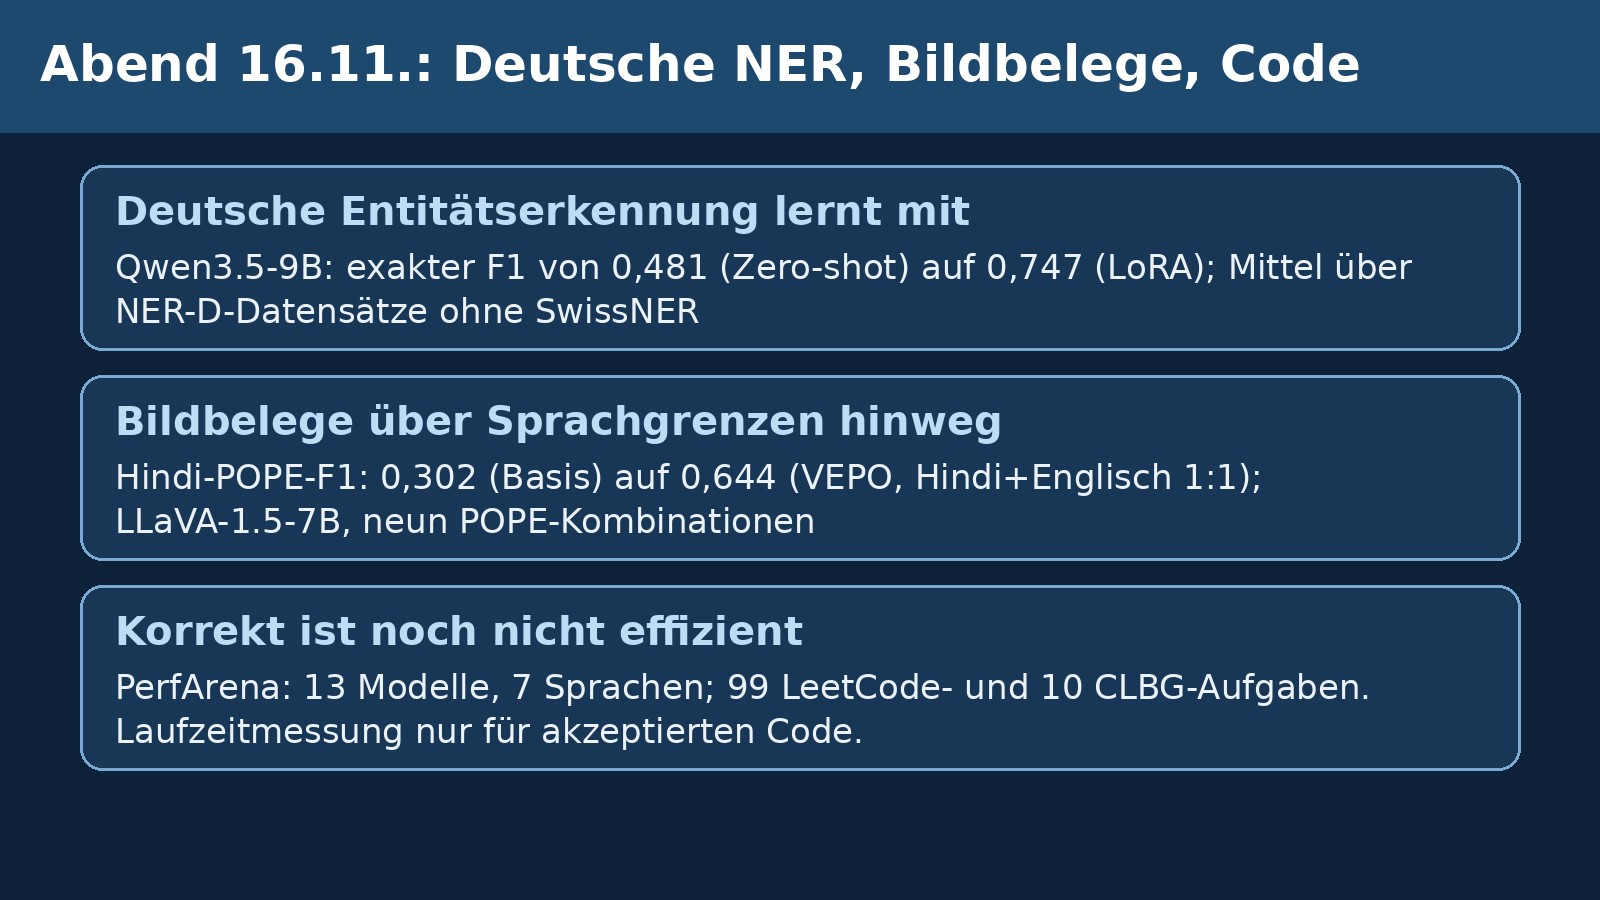
Ohne Beispiele im Prompt liegen Gemma und GPT im gemittelten exakten F1 numerisch nah beieinander: 0,507 und 0,504. Das belegt keine Gleichwertigkeit, und GPT führt auf sechs der 13 einzelnen Datensätze. Der deutlichere Unterschied entsteht durch zusätzliches Training: Qwen steigt mit LoRA von 0,481 auf 0,747, Ministral von 0,430 auf 0,732 und Gemma von 0,507 auf 0,731. Diese Mittelwerte schließen SwissNER aus, weil der kleine Datensatz nur ohne Beispiele geprüft wurde. Wichtig für den Vergleich: GPT wurde ausschließlich ohne Beispiele getestet, nicht ebenfalls auf den Aufgaben nachtrainiert.
Fünf Beispiele im Prompt helfen bereits, vor allem bei exakten Textgrenzen. Das spricht laut Autoren dafür, dass Modelle auch Annotationskonventionen lernen müssen: Gehört etwa ein Artikel oder eine Anrede zum gesuchten Namen? Eine spezialisierte Domäne allein erklärt schwache Ergebnisse nicht. Bei GerPS entfernte die Zerlegung in einzelne Sätze wichtigen Dokumentkontext; selbst Feintuning reparierte diesen Verlust nur begrenzt. Das ist eine Grenze des Testaufbaus, kein allgemeines Urteil über Verwaltungsdokumente. Code, aufbereitete Daten und Modelle kündigt das Paper erst für den Zeitpunkt einer Annahme zur Veröffentlichung an.
VEPO: Bildbelege statt sprachlicher Vermutungen
Ein Bild bleibt dasselbe, doch die Frage auf Hindi kann eine andere Antwort auslösen als die englische Fassung. VEPO setzt bei diesem Sprachgefälle an. Das Team um Chengpeng Fu nutzt die Aufmerksamkeit eines Bild-Sprach-Modells bei englischen Fragen, um wichtige Bildbereiche zu finden. Im Training sieht das Modell dann zwei Fassungen: das vollständige Bild und eines mit gezielt verdeckten Bereichen. Die richtige Antwort bleibt in beiden Trainingspaaren gleich. Das Lernsignal soll diese Antwort stärker an vorhandene Bildbelege binden, statt nur eine sprachlich plausible Antwort zu bevorzugen.
Auf LLaVA-1.5-7B steigt der mittlere POPE-F1 für Hindi von 0,302 auf 0,644, für Französisch von 0,742 auf 0,794 und für Chinesisch von 0,731 auf 0,766. POPE prüft mit Ja-Nein-Fragen, ob Objekte auf einem Bild vorhanden sind. Die Zahlen messen also diese Benchmarkleistung, nicht den Anteil halluzinationsfreier Antworten in beliebigen Gesprächen. Der Hindi-Gewinn enthält eine wichtige Zusatzbedingung: Für diese Sprache mischen die Autoren Hindi- und englische Präferenzpaare im Verhältnis 1:1. Nach vorherigem überwachten Training verschlechtert Hindi-only-VEPO im COCO-POPE-Test den F1 sogar leicht von 0,709 auf 0,700; die gemischte Fassung erreicht 0,769.
Eine Kontrolle spricht für gezielte statt zufällige Bildmasken: Im chinesischen POPE-Test erreicht zufälliges Verdecken 0,745, die gezielte Variante 0,766, gegenüber 0,731 beim Ausgangsmodell. Zugleich sind die Befunde eng begrenzt: ein Modell-Backbone, drei geprüfte Sprachen und in der Regel ein Lauf je Einstellung. Beim zweiten Benchmark MME steigen die Gesamtwerte, aber einzelne Denkaufgaben in Chinesisch und Französisch fallen zurück. VEPO ist damit ein Befund über bessere visuelle Verankerung in diesem Setup, kein allgemeiner Beleg für besseres Schlussfolgern.
PerfArena: Richtiger Code kann trotzdem langsam sein
PerfArena bewertet Code erst auf Korrektheit und misst danach Laufzeit, Spitzenspeicher und Energieverbrauch. Rui Rua und Kollegen vergleichen 13 Modelle in sieben Programmiersprachen: auf 99 ausgewählten LeetCode-Aufgaben und zehn rechenintensiven Programmen aus dem Computer Language Benchmarks Game. Das Paper berichtet 9.455 korrekte und gemessene Lösungen. Jedes Duell hält Aufgabe und Sprache konstant. Fehlerhafte Lösungen zählen bei der Erfolgsquote, erhalten aber keinen künstlichen Laufzeitwert und gehen nicht in Effizienzduelle ein.
Auf der LeetCode-Auswahl lösen zwölf der 13 Modelle mehr als 90 Prozent der Aufgabe-Sprache-Kombinationen. Die korrekten Lösungen der anderen Modelle laufen auf den jeweils gemeinsam gelösten Kombinationen dennoch im geometrischen Mittel 1,14- bis 1,61-mal so lange wie die von GPT-6-Astra. Im schwereren CLBG-Teil reicht die Spanne bis 3,61. Die Autoren können GPT-6-Astra und Claude Opus 5.5 im LeetCode-Laufzeitvergleich statistisch nicht trennen. Das heißt nicht, dass ihr Code gleich schnell ist; bei nur zehn CLBG-Aufgaben ist die Trennschärfe noch geringer. Ein geteilter Spitzenplatz kann dort auch durch wenige gelöste Aufgaben entstehen.
Für den Alltag ist die Methodik interessanter als eine universelle Rangliste: Ein Modell, eine Aufgabe und eine Sprache ergeben zunächst nur eine Stichprobe. Alle Messungen stammen von einem einzigen Intel-Linux-Rechner, pro Kombination wurde nur eine Lösung erzeugt, und die öffentlichen Aufgaben samt bekannten Lösungen könnten in Trainingsdaten vorkommen. Auch wiederholte Aufrufe können Zwischenspeicher-Effekte begünstigen. Der Quellcode ist auf GitHub tatsächlich vorhanden, einschließlich Mess-, Client- und Webapp-Verzeichnissen. Die Rangangaben hier beziehen sich auf die Studie, nicht auf eine separat bestätigte aktuelle Live-Rangliste.
Häufige Fragen
Sind kleine offene Modelle damit besser für deutsche Texte?
Für die getestete deutsche Entitätserkennung profitieren die drei offenen Modelle deutlich von zusätzlichem aufgabenspezifischem LoRA-Training. Die GPT-5.4-mini-Baseline erhielt dieses Training nicht und wurde nur ohne Beispiele geprüft. Daraus folgt kein allgemeiner Größen- oder Qualitätsvergleich für deutsche Texte.
Beseitigt VEPO visuelle Halluzinationen?
Nein, das zeigen die Daten nicht. Im LLaVA-1.5-7B-Test verbessert VEPO die POPE-F1-Werte in drei Sprachen. Der größte Gewinn auf Hindi setzt gemischte Hindi-/Englisch-Trainingspaare voraus. Freie Bildbeschreibungen oder andere Modellarchitekturen sind damit nicht pauschal abgesichert.
Kann ich aus PerfArena das schnellste Coding-Modell auswählen?
Die Studie gibt Hinweise für die geprüften Aufgaben, Sprachen und die verwendete Hardware. Ihre Rangliste misst die Ausführung korrekten erzeugten Codes, nicht die Antwortgeschwindigkeit des KI-Dienstes. Für eine konkrete Anwendung bleiben eigene repräsentative Lasttests nötig.
Quellen
- NER-D: A cross-domain benchmark for German NER (arXiv; Marc Brinner u. a., Universität Bielefeld, abgerufen 2026-11-16)
- VEPO: Mitigating Multilingual Hallucinations in LVLMs via Visual Evidence-guided Preference Optimization (arXiv; Chengpeng Fu u. a., Harbin Institute of Technology, Peng Cheng Laboratory, Zhongguancun Academy, abgerufen 2026-11-16)
- PerfArena: Ranking LLMs by Code Performance (arXiv; Rui Rua, Hailemariam Mersha, João Paulo Fernandes, Karim Ali, abgerufen 2026-11-16)
- PerfArena: Quellcode und Messinfrastruktur (GitHub; perfarena/perfarena, abgerufen 2026-11-16)
Weitere Artikel
- SatBench: 63 Prozent der Benchmarks sind gelöst - unabhängig nur 24
- Anthropic: Claude findet 493 Angriffsflächen in Open-Source-Code
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.