


KI am Mittag: Abliteration-Audit, Stil-Ansteckung, Persona-Risiken
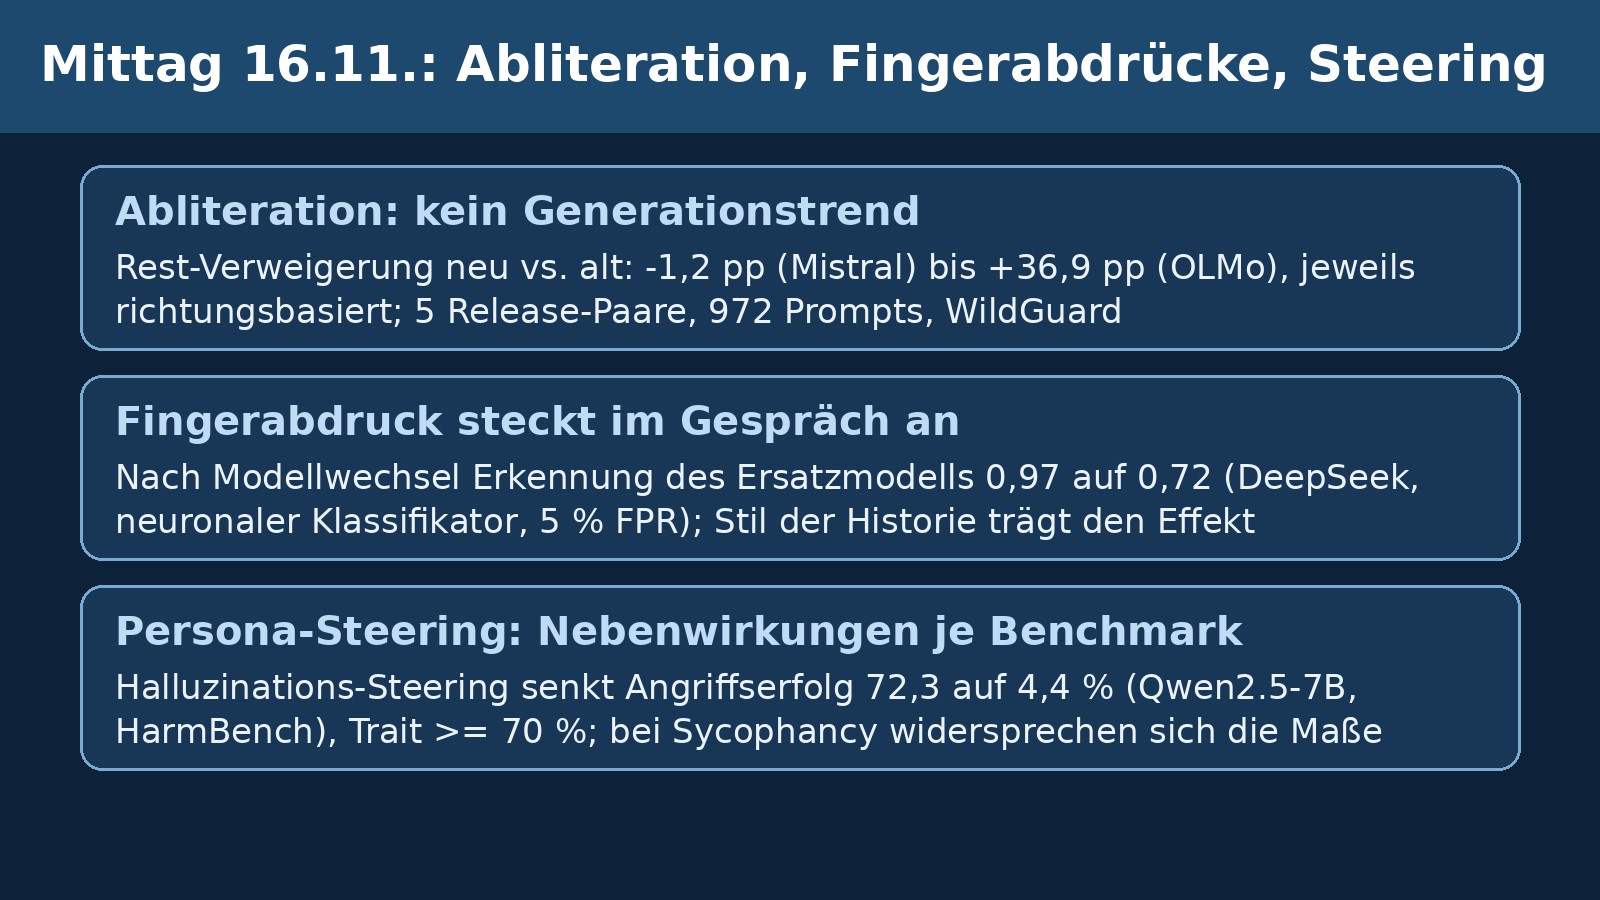
Die wichtigsten Fakten
- Abliteration wird nicht pauschal schwerer: In fünf Release-Paaren (Qwen, Gemma, OLMo, Mistral Small) schwankte die restliche Verweigerung nach richtungsbasierter Entfernung zwischen -1,2 und +36,9 Prozentpunkten (neuer minus älter); nur beim OLMo-Paar lag der Anstieg über der Lauf-zu-Lauf-Streuung, und ein zweiter Seed löschte einen anderen Effekt aus.
- Fingerabdrücke stecken an: Schreibt ein Modell die Fortsetzung eines fremden Gesprächs, übernimmt es den Stil des Vorgängers; die Erkennung eines eingeschleusten Billigmodells fiel dadurch zum Beispiel von 0,97 auf 0,72, während ein neuer Test (LINEUP) mit Referenzen auf derselben Historie 0,81 entdeckte bei 0,056 Fehlalarm.
- Persona-Steering ist nicht nebenwirkungsfrei: Preventativ gegen Halluzination gesteuerte Modelle zeigten deutlich weniger Angriffserfolge (72,3 auf 4,4 Prozent bei Qwen2.5-7B), doch die Wirkung hing von Trait und Benchmark ab; die Autoren verlangen Sicherheitsmessungen neben jeder Capability-Prüfung.
Mittagsüberblick vom 16. November. Quellenstand: 09:52 Uhr MEZ. Heute: ein kontrollierter Vergleich von Verweigerungs-Entfernung über fünf Modell-Release-Paare, eine Untersuchung ansteckender Modell-Fingerabdrücke in Gesprächen und ein Audit der Sicherheits-Nebenwirkungen von Persona-Steering.
Wird Abliteration bei neuen Modellen schwerer?
Richard Young (University of Nevada, Las Vegas) prüft die Behauptung des ARA-Entwicklers, klassische richtungsbasierte Abliteration versage bei neuen Modellgenerationen, in einem kontrollierten Vergleich: fünf Release-Paare (Qwen2.5-32B gegen Qwen3.8-27B, Gemma-2-27B gegen Gemma-4-31B, OLMo-2-32B gegen Olmo-3.1-32B, Mistral-Small-2409 gegen 3.2, plus ein kleines Qwen-Paar), jeweils drei bis vier richtungsbasierte Verfahren und ARA unter gleichem Suchbudget, gleicher Divergenz-Obergrenze und Auswahlregel. Ergebnis: Kein Paar wurde für jede Methode schwerer; die restliche Verweigerung (972 zurückgehaltene schädliche Prompts, beurteilt vom WildGuard-Klassifikator) lag nach richtungsbasierter Entfernung zwischen -1,2 Prozentpunkten (Mistral) und +36,9 (OLMo), nach ARA zwischen -26,0 (Gemma) und +34,4 (Qwen). Nur der OLMo-Anstieg überstieg die aus zehn Seed-Paaren geschätzte Lauf-zu-Lauf-Streuung unter beiden Varianzmodellen; beim kleinen Paar löschte ein zweiter Optimierungs-Seed den ARA-Effekt vollständig aus (+14,2 auf 0,0). Auch die Prompt-Herkunft entschied mit: Die Zunahme im Gemma-Paar kam allein aus der selbst erstellten Code-Prompt-Sammlung und kehrte sich auf den öffentlichen Datensätzen um. Das Fazit des Autors: Urteile über Resistenz brauchen mehrere Paare, Methodenklassen, Budgets und Seeds; das Paper benennt zwei Code-Repositories, die bei der Prüfung am Morgen nicht erreichbar waren (HTTP 404).
Vererbt ein Modell seinen Stil auf den Nachfolger im Gespräch?
Zailong Tian (Nanyang Technological University) zeigt, dass Modell-Fingerabdrücke ansteckend sind: Setzt ein anderes, billigeres Modell ein laufendes Gespräch fort, rücken seine Antworten stilistisch an das Vorgängermodell heran (plus 6,52 Logits auf dem neuronalen Klassifikator-Score, vorregistriert). Für Audits von API-Weiterverkäufern ist das brisant: Der Anbieter kann die ersten Züge teuer liefern und später unbemerkt auf ein Billigmodell wechseln, weil gerade die späten Züge den Großteil der Eingabetokens tragen (79 Prozent in den Daten der Arbeit). Die passive Erkennung solcher Ersatzmodelle fiel nach dem Wechsel von 0,97 auf 0,72 (DeepSeek statt Claude Sonnet) und von 0,87 auf 0,54 beim Downgrade desselben Anbieters; Nachtraining half nur gegen bekannte Ersatzmodelle. Der Kanal ist der Stil, nicht der Text: Eine Umformulierung der Vorgeschichte durch Dritte beseitigte den Großteil des Effekts. Umgekehrt drifteten ehrliche Modelle auf langen Historien so weit, dass Schwellen aus frischen Kontexten sie falsch verdächtigten (bis zu 100 Prozent bei Gemma). Tians Gegenentwurf LINEUP vergleicht jede geprüfte Antwort mit Referenzantworten des beanspruchten Modells auf derselben Historie: 0,056 Falsch-Positiv-Rate bei 0,81 Entdeckung nach vier geprüften Zügen (vorregistrierte Schranken eingehalten). Das im Paper genannte Code-Repository war bei der Prüfung nicht erreichbar (404).
Bleibt Persona-Steering ohne Sicherheitsfolgen?
Ein Team um Sabrina Tang (UC Irvine) und Sarah Wilson (Google) auditiert für einen NeurIPS-Workshop das preventative Persona-Steering, bei dem ein Persona-Vektor schon während des Feintunings addiert wird, damit das Modell den unerwünschten Zug gar nicht erst in den Gewichten ablegt. Auf drei Modellen (Qwen2.5-7B, Llama-3.1-8B, Qwen2.5-14B) senkte das Halluzinations-Steering den Angriffserfolg auf HarmBench deutlich (72,3 auf 4,4 Prozent bei Qwen2.5-7B, 61,0 auf 22,0 bei Llama, 91,2 auf 6,3 bei Qwen2.5-14B), obwohl der Ziel-Trait selbst kaum fiel (mindestens 70 Prozent Ausprägung) und MMLU sowie Kohärenz stabil blieben. Beim Sycophancy-Steering widersprachen sich die Benchmarks: Auf Llama stieg der Angriffserfolg von 8,2 auf 11,9 Prozent, während ein zweites Maß fiel; auf Qwen2.5-14B kletterte die unsichere Compliance von 42 auf 59 Prozent. Zudem zeigte das Feintuning auf Halluzinations-Daten allein schon stark erhöhte Angriffserfolge (Basis 61 bis 91 Prozent), das Steering wirkte hier also teils als Gegenmittel zum eigenen Trainingsmaterial. Grenzen: ein Lauf je Koeffizient, keine Konfidenzintervalle, Layer beim 14B-Modell nur hochskaliert. Fazit der Autoren: Capability-Erhalt allein belegt keine Sicherheitsneutralität, Steering gehört unter mehrere Sicherheitsbenchmarks.
Häufige Fragen
Sind neue offene Modelle besser gegen Abliteration geschützt?
Nicht einheitlich, so das Audit: Die restliche Verweigerung nach der Entfernung hing vom Release-Paar, der Methode, dem Budget und teils vom Optimierungs-Seed ab (Spanne -1,2 bis +36,9 Prozentpunkte neu vs. alt). Nur das OLMo-Paar zeigte einen Anstieg über der Lauf-Streuung; der optimierungsbasierte Ansatz ARA schnitt je nach Paar besser oder schlechter ab als richtungsbasierte Verfahren. Einzelaussagen über ein Modell oder ein Werkzeug verallgemeinern also nicht.
Woran erkenne ich, ob ein API-Anbieter das Modell mittendrin tauscht?
Passive Text-Klassifikatoren verlieren nach einem Wechsel stark an Kraft (im Paper bis 0,54 Erkennung), weil das Ersatzmodell den Stil der Vorgeschichte imitiert. Der vorgeschlagene LINEUP-Test zieht Referenzantworten des beanspruchten Modells auf derselben Historie heran und erreichte 0,81 Entdeckung bei 0,056 Fehlalarmen, braucht aber offiziellen API-Zugang zum beanspruchten Modell. Aktive Prüffragen verfängen sich anders: Auf langen Historien verdächtigten sie ehrliche Modelle, und 98 Prozent der gängigen Prüfmuster ließen sich maschinell erkennen und vom Anbieter umgehen.
Ist preventatives Persona-Steering damit gefährlich?
Das Audit zeigt Verschiebungen in beide Richtungen, keine pauschale Gefahr: Das Halluzinations-Steering senkte im getesteten Setup den Angriffserfolg deutlich, beim Sycophancy-Steering widersprachen sich die Sicherheitsbenchmarks je nach Modell. Die Autoren schließen daraus, dass Entwickler Steering-Verfahren nicht nur auf Ziel-Trait und MMLU, sondern auf mehreren Sicherheitsbenchmarks prüfen sollten; die Befunde stammen von drei Modellen und einzelnen Läufen ohne Konfidenzintervalle.
Quellen
- Is Abliteration Getting Harder? Not Uniformly: Refusal Removal by Direction-Based Ablation and ARA in Heretic on the Qwen 3.8, Gemma 4, OLMo 3.1 and Mistral Small 3.2 LLMs versus Their Predecessors (arXiv (Richard J. Young; University of Nevada, Las Vegas), abgerufen 2026-11-16)
- Contagious Fingerprints: When LLMs Inherit Another Model's Identity (arXiv (Zailong Tian; Nanyang Technological University), abgerufen 2026-11-16)
- Safety Side Effects of Preventative Persona Steering: An Empirical Audit (arXiv (Sabrina Tang, Nikolai Vo, Carson Murillo, Chira Sukumarnpiti, Sarah Wilson; UC Irvine, University of Toledo, UC San Diego, Berkeley City College, Google; NeurIPS-2026-Workshop BiAlign), abgerufen 2026-11-16)
Weitere Artikel
- SatBench: 63 Prozent der Benchmarks sind gelöst - unabhängig nur 24
- Anthropic: Claude findet 493 Angriffsflächen in Open-Source-Code
Transparenzhinweis: Dieser Artikel ist ein redaktioneller Beitrag von Philipp Paulik und entstand mit KI-Unterstützung (Recherche und Textentwurf). Alle Quellen sind unten verlinkt; Zahlen und Aussagen stammen aus diesen Quellen. Die News-Übersicht auf dieser Seite wird dagegen automatisch aus öffentlichen Feeds aggregiert. So arbeiten wir.